Неделя 06 · Обучение представлениям последовательностей: от рекуррентной памяти к энкодерам Transformer
English · Русский
Фраза «A journey of a thousand miles begins…» («Путешествие в тысячу миль начинается…») приглашает продолжить её. Следующее слово зависит от уже заданных слов и их порядка. Измерения устроены похожим образом: растущая и падающая температура могут иметь одинаковое среднее, но подсказывать разные следующие значения. Представление последовательности должно сохранять информацию, необходимую для решения её задачи.
На неделе 04 мы разобрали, как модель обучается промежуточным представлениям (representations). На неделе 05 параметры повторно использовались в разных точках изображения. Здесь мы используем одни и те же параметры в разных позициях последовательности и выясняем, как информация перемещается между ними. Рекуррентная модель (recurrent model) передаёт состояние от одного наблюдения к следующему. Механизм внимания (attention) строит представление, объединяя информацию из доступных позиций-источников. Обоим подходам по-прежнему нужны предсказывающая голова (prediction head), функция потерь (loss) и процедура обучения.
Начнём с одного входного числа и одного числа состояния. Такая небольшая модель позволяет увидеть каждую операцию прямого прохода (forward pass) и каждое звено обратного прохода (backward pass). Затем перейдём к векторным состояниям, изучим градиенты памяти и вентили (gates) и построим механизм внимания и полный энкодер Transformer на примере приведённого выше префикса из семи английских слов.
Результаты обучения (learning outcomes)
После изучения главы вы сможете:
- сформулировать задачу для последовательности и определить, какая информация доступна в момент предсказания;
- вычислить рекуррентные состояния и предсказания и вывести градиенты с учётом каждого использования общих параметров;
- объяснить, как длина последовательности, производные активаций и обновления с вентилями влияют на память и обучение;
- проследить путь токенов через выборку эмбеддингов (embedding lookup), позиционную информацию и одно- и многоголовое внимание;
- объяснить операции, оси, остаточные пути (residual paths) и предсказывающие головы энкодера Transformer;
- проверить маскирование (masking), согласование целевых значений (target alignment) и оценку моделей последовательностей, а также интерпретировать выводы, которые подтверждаются сравнением.
Предварительные знания и сопутствующие материалы
Предполагается знакомство со скалярными производными и правилом дифференцирования сложной функции (chain rule). В главе недели 04 объясняется, почему производные перемножаются вдоль пути и складываются там, где пути сходятся. В главе недели 05 показано, как один общий параметр получает вклады от нескольких использований. При переходе к векторным состояниям пригодится матричное умножение; для первого расчёта оно не требуется.
Лекция недели 06 даёт обзор материала. Практикум недели 06 позволяет выполнить обучение последовательностей на небольшом языке команд робота. Скалярный пример регрессии в этой главе — отдельный, намеренно небольшой расчёт: формулы выводятся без задания численных значений наблюдений, весов и целевого значения.
Почему важны порядок и доступный контекст
Сначала сформулируйте задачу предсказания
Последовательность (sequence) — упорядоченный набор наблюдений. Обозначим её позиции как \(t=0,\ldots,T-1\), где \(T\) — длина. Наблюдением может быть значение датчика, вектор измерений или токен, обозначающий слово. Начнём со скалярного наблюдения \(x_t\in\mathbb R\): в каждой позиции задано одно действительное число.
Структура выхода не обязана совпадать со структурой входа. Мы можем присвоить один класс всей последовательности, назначить метку каждому заданному слову или спрогнозировать будущее измерение по наблюдаемому префиксу. Эти задачи различаются тем, какую информацию разрешено использовать для предсказания.
| Задача | Предсказание | Доступный вход в сформулированной задаче |
|---|---|---|
| Классификация записанной последовательности | Одна метка для всей записи | Вся предоставленная запись |
| Разметка слов в предоставленном предложении | Одна метка на слово | Всё предложение, если это допускает приложение |
| Прогноз следующего измерения | Одно будущее значение | Измерения, наблюдённые до этого будущего значения |
Префикс (prefix) состоит из уже предоставленных наблюдений в их исходном порядке. При прогнозировании неизвестное следующее наблюдение служит целевым значением (target), а не частью префикса. Если модель получает будущие измерения при обучении, она решает более простую задачу, чем та, которую предстоит решать при использовании. Поэтому сначала задаём доступный вход и лишь затем выбираем архитектуру.
Вы наблюдали \(x_0,x_1,x_2\) и должны предсказать следующее измерение \(x_3\). Какие наблюдения могут участвовать в предсказании? Если обучающий пример также содержит истинное \(x_3\), где должно использоваться это значение?
Показать объяснение
Предсказание может использовать наблюдаемый префикс \(x_0,x_1,x_2\). Истинное \(x_3\) задаёт целевое значение для функции потерь. Передача его предсказывающей модели раскрыла бы ответ, недоступный при прогнозировании будущего измерения.
Передавайте представление вдоль последовательности
При фиксированной длине можно передать \((x_0,x_1,\ldots,x_{T-1})\) сети прямого распространения (feedforward model). Каждая координата соответствует позиции, поэтому разворачивание в вектор в заданном порядке не уничтожает порядок. Рекуррентная модель предлагает другой способ: многократно применять одно небольшое преобразование, объединяя текущее наблюдение с предыдущим представлением.
Её скрытое состояние (hidden state) \(h_t\) — представление после обработки позиции \(t\). «Скрытое» означает промежуточное: состояние находится внутри вычисления предсказания, а не является наблюдаемым измерением или целевым значением. В нашей скалярной модели это одно действительное число, обобщающее вычисления на префиксе. Оно не обязано воспроизводить наблюдения или сохранять все их подробности.
Каждый шаг использует \(x_t\) и \(h_{t-1}\). Параметры остаются прежними, а состояние изменяется. Более длинная последовательность добавляет новые использования преобразования, но не требует отдельного набора параметров ячейки для каждой позиции. Это совместное использование параметров во времени (parameter sharing), аналогичное использованию общих параметров в пространстве на неделе 05. Рекуррентная конструкция и её развёрнутый вычислительный граф описаны в Goodfellow и др. (2016 г.), глава 10.
Скалярная рекуррентная модель: прямой проход, предсказание, потери и обучение
Сформулируем задачу с тремя шагами
Пусть один обучающий пример содержит три скалярных наблюдения, \((x_0,x_1,x_2)\), и одно скалярное целевое значение \(y\). Длина последовательности равна \(T=3\), а временные шаги — \(t=0,1,2\). Обработаем наблюдения по порядку и затем предскажем \(y\) по конечному состоянию. В задаче прогнозирования \(y\) могло бы быть следующим измерением \(x_3\); для вывода требуется только заданное целевое значение регрессии.
Рекуррентная нейронная сеть (recurrent neural network, RNN) многократно применяет ячейку — преобразование, объединяющее текущее наблюдение с предыдущим скрытым состоянием. Для скалярного входа \(x_t\) и скалярного состояния \(h_t\) запишем
\[ z_t=w_xx_t+w_hh_{t-1}, \qquad h_t=\phi(z_t). \]
Входной вес \(w_x\) управляет вкладом текущего наблюдения, а рекуррентный вес \(w_h\) — вкладом предыдущего состояния. Предактивация (preactivation) \(z_t\) — значение до применения функции активации \(\phi\); скрытое состояние \(h_t\) — значение после неё. Оставим \(\phi\) в общем виде и предположим, что в предактивациях данного примера она дифференцируема.
В этом выводе смещение ячейки и смещение выхода (bias) фиксированы и равны нулю. Они исключены из формул и обновлений. Обучаемые параметры — три веса \(\theta=(w_x,w_h,w_o)\). В более общей модели смещения можно вернуть; здесь их отсутствие позволяет непосредственно проследить рекуррентные зависимости.
До первого наблюдения зададим фиксированное начальное состояние \(h_{-1}=0\). Это начальное условие, а не четвёртое наблюдение. В этой модели каждая независимая последовательность начинается с нового начального состояния.
Предсказывающая голова (prediction head), также называемая считыванием (readout), превращает скрытое состояние в предсказание регрессии. В позиции, где требуется выход, она выполняет
\[ \widehat y_t=w_oh_t. \]
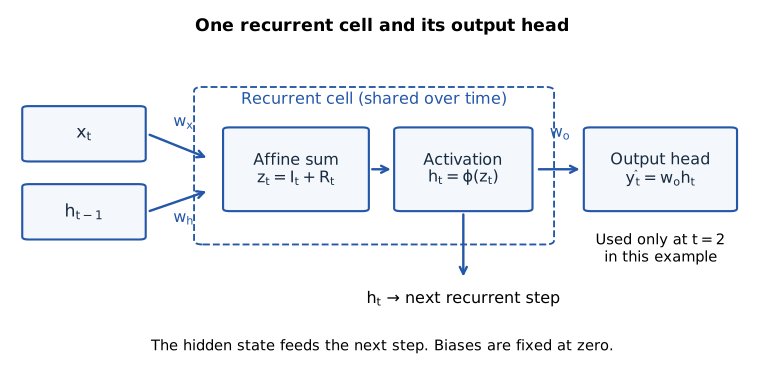
На Рисунок 1 показаны обе операции: рекуррентная ячейка создаёт \(h_t\), а выходная голова считывает его. На каждом временном шаге используется одна и та же ячейка с общими \(w_x,w_h\) и \(\phi\). Её состояние \(h_t\) изменяется вместе с наблюдениями. Предсказание \(\widehat y_t\) — выход; на следующий рекуррентный шаг передаётся именно \(h_t\). На схеме вклады текущего входа и предыдущего состояния обозначены как \(I_t=w_xx_t\) и \(R_t=w_hh_{t-1}\).
В задаче с тремя шагами требуется одно предсказание после последнего временного шага, поэтому применяем голову только к \(h_2\) и записываем \(\widehat y=\widehat y_2\). Функция потерь равна
\[ \widehat y=w_oh_2, \qquad \mathcal L=\frac12(\widehat y-y)^2. \]
Выходной вес \(w_o\) преобразует скрытое представление в предсказание \(\widehat y\). Целевое значение \(y\) определяет ошибку предсказания и потери \(\mathcal L\). Есть одна функция потерь на конечном выходе; к предыдущим шагам потери не привязаны. Множитель \(1/2\) упрощает дифференцирование. Усреднения по позициям или примерам здесь нет. Эта \(\mathcal L\) — частный случай общей функции потерь \(L\) недели 04.
| Символ | Значение в этом примере |
|---|---|
| \(x_0,x_1,x_2\) | Три наблюдаемых скалярных входа |
| \(h_{-1}=0\) | Фиксированное начальное состояние |
| \(z_t\), \(h_t\) | Предактивация и скрытое состояние на шаге \(t\) |
| \(w_x\), \(w_h\) | Входной и рекуррентный веса, общие для всех шагов |
| \(w_o\) | Вес выходной головы; в этом примере используется только на последнем шаге |
| \(\phi\), \(\phi'\) | Активация и её локальная производная |
| \(y\), \(\widehat y\), \(\mathcal L\) | Целевое значение, конечное предсказание и потери одной последовательности |
| \(\widehat y_t=w_oh_t\) | Предсказание, считываемое из \(h_t\), когда задача требует выхода в позиции \(t\) |
| \(e=\widehat y-y\) | Ошибка предсказания; также \(\partial\mathcal L/\partial\widehat y\) для этих квадратичных потерь |
| \(g_t^h=\partial\mathcal L/\partial h_t\) | Чувствительность потерь к скрытому состоянию на шаге \(t\); верхний индекс \(h\) обозначает переменную дифференцирования |
| \(g_t^z=\partial\mathcal L/\partial z_t\) | Чувствительность потерь к предактивации на шаге \(t\); верхний индекс \(z\) обозначает переменную дифференцирования |
Сопоставьте каждую прямую операцию с её обратным вычислением
Разворачивание (unrolling) изображает каждое использование одной и той же рекуррентной ячейки отдельно. На Рисунок 2 конечные потери зависят от \(h_2\), которое зависит от \(h_1\), которое зависит от \(h_0\). Каждый блок использует те же \(w_x,w_h\); увеличение числа блоков не добавляет независимых весов.
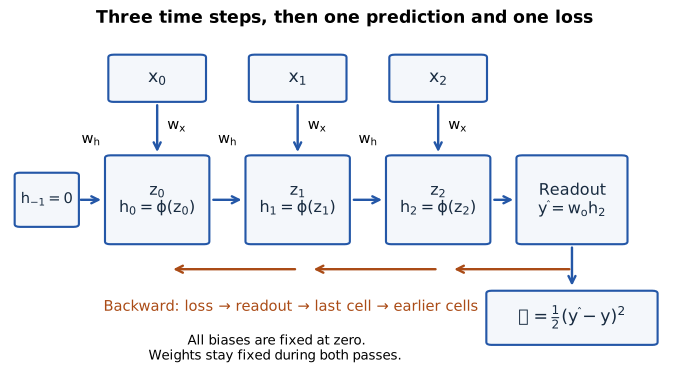
Для любой скалярной промежуточной величины \(v\) производная \(\partial\mathcal L/\partial v\) описывает, как небольшое изменение \(v\) повлияло бы на потери через оставшиеся вычисления. Введём короткие обозначения для двух таких чувствительностей:
\[ g_t^h=\frac{\partial\mathcal L}{\partial h_t}, \qquad g_t^z=\frac{\partial\mathcal L}{\partial z_t}, \qquad e=\widehat y-y. \]
Здесь \(e\) — ошибка предсказания; верхние индексы \(h,z\) указывают, по какой величине берётся производная. Это не степени. Ни \(g_t^h\), ни \(g_t^z\) не являются параметрами или обновлениями состояния.
Читайте столбец прямого прохода сверху вниз. Затем начните с потерь и читайте столбец обратного прохода снизу вверх. В каждой строке рядом с прямой операцией указана чувствительность, передаваемая через неё.
| Прямой проход (forward pass) | Обратный проход (backward pass) |
|---|---|
| \(z_0=w_xx_0+w_hh_{-1}=w_xx_0\) | \(\partial\mathcal L/\partial h_{-1}=g_0^z w_h\) |
| \(h_0=\phi(z_0)\) | \(g_0^z=g_0^h\phi'(z_0)\) |
| \(z_1=w_xx_1+w_hh_0\) | \(g_0^h=g_1^z w_h\) |
| \(h_1=\phi(z_1)\) | \(g_1^z=g_1^h\phi'(z_1)\) |
| \(z_2=w_xx_2+w_hh_1\) | \(g_1^h=g_2^z w_h\) |
| \(h_2=\phi(z_2)\) | \(g_2^z=g_2^h\phi'(z_2)\) |
| \(\widehat y=w_oh_2\) | \(g_2^h=e w_o\) |
| \(\mathcal L=\tfrac12(\widehat y-y)^2\) | \(\partial\mathcal L/\partial\widehat y=\widehat y-y=e\) |
Первая строка показывает, как вычисление отреагировало бы на изменение начального состояния. Здесь мы останавливаемся: \(h_{-1}=0\) фиксировано и не обновляется как параметр.
Строка потерь запускает обратное вычисление: дифференцирование квадрата даёт \(e\). Голова умножает эту чувствительность на \(w_o\), передавая её к \(h_2\). Активация затем умножает её на \(\phi'(z_2)\), передавая к \(z_2\).
Чтобы дойти до \(h_1\), дифференцируем \(z_2\) по предыдущему состоянию: \(\partial z_2/\partial h_1=w_h\). Это добавляет множитель \(w_h\). Чтобы дойти до \(z_1\), дифференцируем \(h_1=\phi(z_1)\) и получаем \(\phi'(z_1)\). Повторяем эти два шага, чтобы дойти до \(h_0\) и \(z_0\).
Это обратное распространение во времени (backpropagation through time, BPTT): обычное chain rule, применённое к развёрнутому рекуррентному вычислению. Пока вычисляются производные, все веса сохраняют значения прямого прохода. В этом примере конечные потери — единственный исходный сигнал; более ранние состояния получают сигнал, поскольку влияют на конечное предсказание.
Подставляя строки обратного прохода друг в друга, получаем
\[ \begin{aligned} g_2^z&=e\,w_o\,\phi'(z_2),\\ g_1^z&=e\,w_o\,\phi'(z_2)\,w_h\,\phi'(z_1),\\ g_0^z&=e\,w_o\,\phi'(z_2)\,w_h\,\phi'(z_1)\\ &\qquad\cdot w_h\,\phi'(z_0). \end{aligned} \]
Каждое умножение соответствует локальной производной на пути. Во всех выражениях предсказывающая голова остаётся видимой через множитель \(w_o\).
Почему градиенты общих весов содержат суммы
Таблица обратного прохода задаёт чувствительность потерь к каждой предактивации. Теперь свяжем эти чувствительности с весами. Для одного использования входного веса локальная производная равна \(\partial z_t/\partial w_x=x_t\), поэтому вклад этого использования составляет \(g_t^zx_t\).
Один и тот же \(w_x\) присутствует на всех трёх шагах. Чтобы понять, почему вклады складываются, временно обозначим три использования как \(w_x^{[0]},w_x^{[1]},w_x^{[2]}\). Квадратные скобки обозначают использования, а не новые слои или степени. Общий вес означает \(w_x^{[t]}=w_x\) для каждого \(t\), поэтому при изменении \(w_x\) каждое использование изменяется на одну и ту же величину. Chain rule даёт
\[ \begin{aligned} \frac{\partial\mathcal L}{\partial w_x} &=\sum_{t=0}^{2} \frac{\partial\mathcal L}{\partial w_x^{[t]}} \frac{\partial w_x^{[t]}}{\partial w_x}\\ &=\sum_{t=0}^{2}g_t^zx_t, \qquad \frac{\partial w_x^{[t]}}{\partial w_x}=1. \end{aligned} \]
Знак суммы \(\sum\) складывает три вклада. Они возникают от трёх использований одного параметра, хотя функция потерь всего одна. Мы не создаём отдельные потери на каждом шаге и не усредняем по времени.
Для рекуррентного веса локальный вход на шаге \(t\) равен \(h_{t-1}\), что даёт вклад \(g_t^zh_{t-1}\). Более ранняя зависимость \(h_{t-1}\) от \(w_h\) уже учтена предыдущими использованиями и их обратными сигналами. Не следует повторно дифференцировать эту зависимость внутри каждого локального вклада.
Выходной вес используется один раз. Его локальный вход — \(h_2\), а входящая чувствительность — \(e\). Поэтому полные градиенты \(\nabla_{\theta}\mathcal L=[\partial\mathcal L/\partial w_x,\partial\mathcal L/\partial w_h,\partial\mathcal L/\partial w_o]\) равны
\[ \boxed{\frac{\partial\mathcal L}{\partial w_x} =g_0^zx_0+g_1^zx_1+g_2^zx_2} \]
\[ \boxed{\frac{\partial\mathcal L}{\partial w_h} =g_0^zh_{-1}+g_1^zh_0+g_2^zh_1} \]
\[ \boxed{\frac{\partial\mathcal L}{\partial w_o} =e h_2=(\widehat y-y)h_2.} \]
Подставим полные пути из Таблица 3, чтобы явно показать произведения и суммы:
\[ \begin{aligned} \frac{\partial\mathcal L}{\partial w_x} &=(\widehat y-y)w_o\Bigl[\\ &\quad\phi'(z_2)w_h\phi'(z_1)w_h\phi'(z_0)x_0\\ &\quad+\phi'(z_2)w_h\phi'(z_1)x_1\\ &\quad+\phi'(z_2)x_2\Bigr], \end{aligned} \]
\[ \begin{aligned} \frac{\partial\mathcal L}{\partial w_h} &=(\widehat y-y)w_o\Bigl[\\ &\quad\phi'(z_2)w_h\phi'(z_1)w_h\phi'(z_0)h_{-1}\\ &\quad+\phi'(z_2)w_h\phi'(z_1)h_0\\ &\quad+\phi'(z_2)h_1\Bigr]. \end{aligned} \]
Первый вклад рекуррентного веса равен нулю, поскольку \(h_{-1}=0\). Это не исключает \(x_0\) из вычисления: \(x_0\) по-прежнему влияет на \(h_0\), последующие состояния и конечные потери. В общем случае
\[ \frac{\partial\mathcal L}{\partial x_0}=g_0^z w_x, \]
и это значение не обязано быть нулевым. Разные вклады в общий вес могут иметь противоположные знаки и компенсировать друг друга; сумма не обязательно больше каждого отдельного вклада.
Что произведения говорят о градиентах дальних зависимостей
Сумма собирает отдельные использования общего параметра. Произведение внутри каждого вклада описывает передачу сигнала от этого использования к потерям. Вклад раннего использования проходит больше рекуррентных переходов, чем вклад позднего.
Для перехода от \(h_{t-1}\) к \(h_t\) локальная производная равна
\[ \frac{\partial h_t}{\partial h_{t-1}} =\phi'(z_t)\,w_h. \]
Теперь рассмотрим более длинную последовательность и две позиции \(s<q\). Если между ними нет дополнительных потерь, чувствительность, переданная назад от \(h_q\) к \(h_s\), равна
\[ \begin{aligned} \frac{\partial\mathcal L}{\partial h_s} &=\frac{\partial\mathcal L}{\partial h_q} \prod_{t=s+1}^{q}\bigl[w_h\phi'(z_t)\bigr],\\ \left|\frac{\partial\mathcal L}{\partial h_s}\right| &=\left|\frac{\partial\mathcal L}{\partial h_q}\right| \prod_{t=s+1}^{q}\left|w_h\phi'(z_t)\right|. \end{aligned} \]
Знак произведения \(\prod\) означает перемножение одного множителя перехода для каждого из \(q-s\) шагов. Знаки модуля выделяют величину: знаки самих производных тоже могут меняться. Если модуль каждого множителя не превышает \(r<1\), величина переданного сигнала ограничена сверху входящей величиной, умноженной на \(r^{q-s}\). Длинные пути экспоненциально подавляют сигнал. Это механизм затухающих градиентов (vanishing gradients): далёкие входы могут влиять на прямое состояние, хотя их обучающий сигнал становится крайне малым.
Если модуль множителей многократно превышает единицу, они, наоборот, могут усиливать ненулевой сигнал. Постоянная нижняя граница \(r>1\) даёт рост не менее \(r^{q-s}\) вдоль этого скалярного пути. Это механизм взрывающихся градиентов (exploding gradients). При сочетании малых и больших множителей результат зависит от всего произведения; один большой вес или одна длинная последовательность сами по себе его не определяют. Эти произведения объясняют трудности рекуррентных градиентов; в Pascanu, Mikolov и Bengio (2013), §2 анализ развивается для векторных состояний.
Повторяющиеся множители зависят и от \(w_h\), и от наклонов активации в фактических предактивациях. Даже если один ранний вклад стал ничтожным, общий параметр может получить существенный градиент от поздних использований. Поэтому ненулевой суммарный градиент веса сам по себе не показывает, что модель обучается дальним зависимостям.
Как активация влияет на эти множители
Активация влияет на градиенты через локальный наклон (local slope) \(\phi'(z_t)\). Она также изменяет прямые состояния, а значит, последующие предактивации, в которых вычисляются наклоны. Поэтому один и тот же рекуррентный вес может передавать совершенно разные чувствительности на разных входных последовательностях.
| Активация | Локальная производная | Следствие для рекуррентного пути |
|---|---|---|
| Тождественная (identity): \(\phi(z)=z\) | \(\phi'(z)=1\) | Каждый переход добавляет \(w_h\); активация не ослабляет сигнал, но обновление состояния линейно. |
| Гиперболический тангенс (tanh): \(\phi(z)=\tanh(z)\) | \(\phi'(z)=1-\tanh^2(z)\) | Наклон близок к единице около нуля и мал в области насыщения. |
| Логистическая сигмоида (sigmoid): \(\phi(z)=\sigma(z)\) | \(\phi'(z)=\sigma(z)(1-\sigma(z))\) | Наклон не превышает \(1/4\) и мал в области насыщения. |
| ReLU: \(\phi(z)=\max(0,z)\) | \(\phi'(z)=1\) при \(z>0\); \(0\) при \(z<0\) | Положительные предактивации пропускают сигнал через активацию; отрицательная предактивация обрывает этот путь. |
Насыщение (saturation) означает, что большое изменение предактивации вызывает лишь небольшое изменение выхода активации. Для tanh и sigmoid это происходит далеко от нуля, где производные стремятся к нулю. ReLU не дифференцируема в нуле; общий вывод предполагает дифференцируемые точки, а реализация должна задавать соглашение для нуля.
Отсутствие ослабления активацией не устраняет множители рекуррентного веса. На активном пути ReLU они по-прежнему равны \(w_h\); повторяющиеся модули больше единицы могут усиливать градиенты и состояния. При тождественной активации и фиксированных весах конечное предсказание аффинно по входной последовательности, что ограничивает зависимости, представимые этой простой моделью.
Почему в простой RNN часто используют tanh
Tanh даёт простому рекуррентному состоянию три полезных свойства. Выход ограничен, поэтому каждое значение состояния остаётся между \(-1\) и \(1\) даже после многих переходов. Возможны положительные и отрицательные значения, позволяющие представлению передавать информацию со знаком. Функция гладкая, с наклоном около единицы вблизи нуля, поэтому сама активация не обязана сильно ослаблять градиенты малых сигналов в этой области. В отличие от тождественной активации, она также делает обновление состояния нелинейным.
Эти свойства делают tanh полезным стандартным выбором для простой RNN. Например, RNN в PyTorch по умолчанию использует tanh и предлагает ReLU как альтернативу. Tanh не является универсальным решением задачи рекуррентной оптимизации. Её производная равна
\[ \phi'(z_t)=1-h_t^2 \qquad\text{при }h_t=\tanh(z_t). \]
Когда \(h_t\) близко к одному из краёв диапазона, производная близка к нулю. Повторное насыщение может подавлять сигнал даже при \(|w_h|>1\). И наоборот, ограниченные состояния не гарантируют ограниченных градиентов: вдоль пути производные перемножаются с \(w_h\), и произведение может расти, если состояния остаются в области достаточно больших наклонов. Выбор tanh означает компромисс между ограниченными нелинейными состояниями и насыщением; он не гарантирует, что простая RNN запоминает информацию на произвольной длине.
В следующем разделе скалярные соотношения обобщаются на матричные якобианы и вводится память с вентилями. Вентили изменяют способы удержания и записи информации, а не просто заменяют одну активацию другой в той же простой рекурсии.
Вычислите полный градиент до обновления
Обратное распространение завершается сборкой трёх приведённых выше градиентов. Затем обычный градиентный спуск (gradient descent) выполняет
\[ \begin{aligned} w_x^{\mathrm{new}}&=w_x-\eta\,\frac{\partial\mathcal L}{\partial w_x},\\ w_h^{\mathrm{new}}&=w_h-\eta\,\frac{\partial\mathcal L}{\partial w_h},\\ w_o^{\mathrm{new}}&=w_o-\eta\,\frac{\partial\mathcal L}{\partial w_o}. \end{aligned} \]
Здесь \(\eta>0\) — шаг обучения (learning rate), а верхний индекс «new» обозначает обновлённый параметр. Все производные вычислены с одними и теми же исходными весами. Чтобы оценить обновлённую модель, заново вычислите состояния начиная с \(h_{-1}=0\); сохранение старых состояний смешало бы два набора параметров. В дифференцируемой точке с ненулевым градиентом достаточно малый шаг против градиента уменьшает потери. Нулевой градиент по этому правилу не даёт обновления, а большой шаг может увеличить потери.
Цикл обучения состоит из знакомых частей: наблюдения создают состояния, голова создаёт предсказание, целевое значение определяет потери, произведения передают чувствительности назад, суммы собирают общие использования, а оптимизатор изменяет веса. Скалярный вывод делает эти части явными до того, как векторная модель добавит новые координаты.
Больше координат, длиннее пути и память с вентилями
Две координаты — два связанных скалярных обновления
Что меняется, если наблюдение содержит два измерения, а состояние — два обучаемых признака? Каждая новая координата состояния может объединять обе входные координаты и обе координаты предыдущего состояния. Используем индексы координат с нуля \(i,j=0,1\), отличные от индекса времени \(t\). Запишем векторы-строки \(\mathbf x_t=(x_{t,0},x_{t,1})\) и \(\mathbf h_t=(h_{t,0},h_{t,1})\). Жирные символы обозначают целые векторы или матрицы; обычные символы с индексами — их элементы.
Пока оставим смещения фиксированными и нулевыми. Если \(W_{x,ij}\) соединяет входную координату \(j\) с координатой состояния \(i\), то
\[ \begin{aligned} z_{t,0}&=W_{x,00}x_{t,0}+W_{x,01}x_{t,1}\\ &\quad+W_{h,00}h_{t-1,0}+W_{h,01}h_{t-1,1},\\ z_{t,1}&=W_{x,10}x_{t,0}+W_{x,11}x_{t,1}\\ &\quad+W_{h,10}h_{t-1,0}+W_{h,11}h_{t-1,1},\\ h_{t,0}&=\phi(z_{t,0}),\qquad h_{t,1}=\phi(z_{t,1}). \end{aligned} \]
На каждом шаге работают два обычных нейрона, связанные через предыдущее состояние. Активация действует отдельно на каждую координату. Матрицы собирают их коэффициенты:
\[ \mathbf W_x=\begin{bmatrix}W_{x,00}&W_{x,01}\\W_{x,10}&W_{x,11}\end{bmatrix}, \qquad \mathbf W_h=\begin{bmatrix}W_{h,00}&W_{h,01}\\W_{h,10}&W_{h,11}\end{bmatrix}. \]
Скалярная голова регрессии по-прежнему делает одно предсказание. После последнего шага она объединяет две координаты состояния:
\[ \widehat y=W_{o,00}h_{T-1,0}+W_{o,01}h_{T-1,1}, \qquad \mathcal L=\tfrac12(\widehat y-y)^2. \]
Ширина скрытого состояния и ширина выхода служат разным целям. Два скрытых признака не требуют двух предсказаний. Если все три ширины равны единице, мы в точности получаем скалярную модель.
Общий прямой проход: читайте размеры вместе с уравнением
Пусть \(D\) — ширина входа, \(H\) — скрытого состояния, \(C\) — выхода. Наблюдения и состояния сохраняем как векторы-строки (row vectors), а веса храним с выходными координатами по строкам, как на неделях 04–05 и в PyTorch. Транспонирование \(\top\) меняет местами строки и столбцы матрицы.
| Символ | Размер и значение |
|---|---|
| \(\mathbf x_t\) | \(1\times D\): одно наблюдение |
| \(\mathbf z_t,\mathbf h_t\) | \(1\times H\): предактивация и состояние |
| \(\mathbf W_x,\mathbf W_h\) | \(H\times D\), \(H\times H\): общие входные и рекуррентные веса |
| \(\mathbf W_o\) | \(C\times H\): веса предсказывающей головы |
| \(\mathbf b_h,\mathbf b_o\) | \(1\times H\), \(1\times C\): необязательные смещения ячейки и головы |
| \(\widehat{\mathbf y},\mathbf y\) | \(1\times C\): предсказание регрессии и целевое значение |
| \(\mathbf g_t^h,\mathbf g_t^z\) | \(1\times H\): производные по состоянию и предактивации |
| \(\mathbf e\) | \(1\times C\): ошибка предсказания и производная по конечному предсказанию |
Теперь вернём смещения, чтобы показать общую модель. Смещение сдвигает предактивацию независимо от входов; скалярный вывод остаётся частным случаем со смещениями, фиксированными в нуле.
\[ \begin{aligned} \mathbf z_t&=\mathbf x_t\mathbf W_x^\top +\mathbf h_{t-1}\mathbf W_h^\top+\mathbf b_h,\\ \mathbf h_t&=\phi(\mathbf z_t),\qquad \mathbf h_{-1}=\mathbf 0,\\ \widehat{\mathbf y}&=\mathbf h_{T-1}\mathbf W_o^\top+\mathbf b_o,\\ \mathcal L&=\tfrac12\sum_{c=0}^{C-1}(\widehat y_c-y_c)^2. \end{aligned} \]
Первое произведение имеет размеры \((1\times D)(D\times H)\) и даёт \(1\times H\); рекуррентное произведение даёт тот же размер. Поэтому сумма объединяет соответствующие скрытые координаты. Голова имеет размеры \((1\times H)(H\times C)\) и даёт \(1\times C\). Потери суммируют квадраты ошибок по выходным координатам; неявного усреднения нет. При \(C=1\) получаем прежние потери.
Общий обратный проход: внешнее произведение собирает локальные производные
Векторный обратный проход применяет те же локальные chain rule, что и скалярная таблица. Определим \(\mathbf e=\widehat{\mathbf y}-\mathbf y\). Начиная с конечной головы,
\[ \begin{aligned} \mathbf g_{T-1}^h&=\mathbf e\mathbf W_o,\\ \mathbf g_t^z&=\mathbf g_t^h\odot\phi'(\mathbf z_t),\\ \mathbf g_{t-1}^h&=\mathbf g_t^z\mathbf W_h, \qquad t=T-1,\ldots,0. \end{aligned} \]
Символ \(\odot\) означает поэлементное умножение (elementwise multiplication): перемножаются элементы соответствующих координат. У каждой активации своя локальная производная. Затем умножение на \(\mathbf W_h\) объединяет чувствительности всех координат нового состояния, зависящих от данной ранней координаты. Например, в двух измерениях
\[ g_{t-1,0}^h=g_{t,0}^z W_{h,00}+g_{t,1}^z W_{h,10}. \]
Эта сумма объединяет два исходящих пути из \(h_{t-1,0}\). Она отличается от последующей суммы по времени, собирающей использования общих параметров.
Для одного элемента входного веса локальная производная равна \(\partial z_{t,i}/\partial W_{x,ij}=x_{t,j}\). Поэтому его полный градиент равен
\[ \frac{\partial\mathcal L}{\partial W_{x,ij}} =\sum_{t=0}^{T-1}g_{t,i}^z x_{t,j}. \]
Чтобы собрать все элементы сразу, вычислим внешнее произведение (outer product) \((\mathbf g_t^z)^\top\mathbf x_t\). Столбец размера \(H\times1\), умноженный на строку размера \(1\times D\), создаёт матрицу \(H\times D\); её элемент \((i,j)\) равен именно \(g_{t,i}^z x_{t,j}\). Это не скалярное произведение (dot product), которое сводит соответствующие координаты к одному числу.
\[ \begin{aligned} \nabla_{\mathbf W_x}\mathcal L &=\sum_{t=0}^{T-1}(\mathbf g_t^z)^\top\mathbf x_t,\\ \nabla_{\mathbf W_h}\mathcal L &=\sum_{t=0}^{T-1}(\mathbf g_t^z)^\top\mathbf h_{t-1},\\ \nabla_{\mathbf W_o}\mathcal L &=\mathbf e^\top\mathbf h_{T-1},\\ \nabla_{\mathbf b_h}\mathcal L &=\sum_{t=0}^{T-1}\mathbf g_t^z, \qquad \nabla_{\mathbf b_o}\mathcal L=\mathbf e. \end{aligned} \]
Каждый градиент имеет размер своего параметра. Нулевое обучаемое смещение может получить ненулевую производную; смещение, фиксированное в нуле, исключено из обновлений. Это различие объясняет, почему bias=False удобно для воспроизведения нашей скалярной модели.
То же правило даёт \(\partial\mathcal L/\partial\mathbf x_t=\mathbf g_t^z\mathbf W_x\). При \(D=H=C=1\) внешние произведения становятся обычным умножением, и уравнения воспроизводят три скалярных градиента весов. При фиксированном начальном состоянии обратный проход останавливается после вычисления его чувствительности; само состояние не обновляется.
Если у каждой позиции есть целевое значение, в каждом состоянии сходятся два пути
Потери только на конечном выходе обучают ранние состояния через их влияние на конечное предсказание. В некоторых задачах предсказание требуется в каждой позиции. Чтобы выделить это изменение, оставим регрессию и ту же общую голову:
\[ \begin{aligned} \widehat{\mathbf y}_t&=\mathbf h_t\mathbf W_o^\top+\mathbf b_o,\\ \ell_t&=\tfrac12\sum_{c=0}^{C-1}(\widehat y_{t,c}-y_{t,c})^2,\\ \mathcal L&=\sum_{t=0}^{T-1}\ell_t. \end{aligned} \]
Теперь \(\mathbf h_t\) влияет на текущее предсказание и на будущие состояния. Положим \(\mathbf e_t=\widehat{\mathbf y}_t-\mathbf y_t\) и зададим \(\mathbf g_T^z=\mathbf 0\) как граничное условие обратного прохода. Для \(t=T-1,\ldots,0\),
\[ \begin{aligned} \mathbf g_t^h&=\underbrace{\mathbf e_t\mathbf W_o}_{\text{текущая голова}} +\underbrace{\mathbf g_{t+1}^z\mathbf W_h}_{\text{будущие состояния}},\\ \mathbf g_t^z&=\mathbf g_t^h\odot\phi'(\mathbf z_t). \end{aligned} \]
Сложите оба пути до применения производной активации. Будущий вклад уже включает все последующие потери через рекурсию; повторное добавление каждой поздней функции потерь посчитало бы её дважды. Градиенты входных и рекуррентных весов сохраняют суммы по использованиям. У общей головы теперь тоже несколько использований:
\[ \nabla_{\mathbf W_o}\mathcal L =\sum_{t=0}^{T-1}\mathbf e_t^\top\mathbf h_t, \qquad \nabla_{\mathbf b_o}\mathcal L=\sum_{t=0}^{T-1}\mathbf e_t. \]
При усреднении по позициям, \(\mathcal L=T^{-1}\sum_t\ell_t\), замените каждый прямой сигнал ошибки на \(\mathbf e_t/T\). Не делите рекуррентный сигнал на \(T\) снова на каждом переходе. Усреднение по \(B\) примерам даёт дополнительный множитель \(1/B\). Для классификации замените производную головы квадратичных потерь производной выбранных классификационных потерь; рекурсия с двумя путями остаётся прежней. В лекции разобран случай кросс-энтропии (cross-entropy).
Матричные пути могут сжимать, растягивать и менять направление
В одном измерении переход умножает чувствительность на одно число. В нескольких измерениях он может также поворачивать и смешивать координаты. Определим матрицу Якоби (Jacobian) \(\mathbf J_t\) как \((J_t)_{ij}=\partial h_{t,i}/\partial h_{t-1,j}\). Она перечисляет влияние каждой координаты предыдущего состояния на каждую координату нового:
\[ \mathbf J_t=\operatorname{diag}\!\left(\phi'(\mathbf z_t)\right)\mathbf W_h. \]
Здесь \(\operatorname{diag}\) строит диагональную матрицу из наклонов активаций. Наша чувствительность-строка подчиняется \(\mathbf g_{t-1}^h=\mathbf g_t^h\mathbf J_t\). Для \(s<q\) без промежуточных потерь,
\[ \mathbf g_s^h=\mathbf g_q^h\mathbf J_q\mathbf J_{q-1}\cdots\mathbf J_{s+1}. \]
Порядок важен: матричные произведения в общем случае некоммутативны. Их действие зависит от направления сигнала и наклонов активации вдоль фактической траектории. Элемент \(\mathbf W_h\), превышающий единицу, не является критерием взрыва градиентов.
Спектральная норма (spectral norm) \(\|\mathbf J\|_2\) — наибольший коэффициент, с которым матрица может растянуть евклидову длину вектора. Она даёт полезную верхнюю границу
\[ \|\mathbf g_s^h\|_2 \leq \|\mathbf g_q^h\|_2 \prod_{t=s+1}^{q}\|\mathbf J_t\|_2. \]
Если нормы равномерно меньше единицы, достаточно длинный путь подавляет каждое направление. Нормы больше единицы допускают усиление, но не гарантируют, что конкретный сигнал направлен вдоль усиливаемых направлений. В Pascanu, Mikolov и Bengio (2013) анализируются эти трудности рекуррентных градиентов и обосновывается обрезка по норме (norm clipping).
Контролируемые эксперименты разделяют длину пути и насыщение
На Рисунок 3 показаны два разных расчёта. Слева мы фиксируем скалярную производную перехода на \(0.8\), \(1\) или \(1.2\) и строим её модуль в степени числа переходов. Это изолирует длину пути, а не показывает измеренный результат обучения.
Справа вычисляются фактические траектории tanh при \(w_h=1.2\), \(w_x=1\), \(h_{-1}=0\) и постоянных входах. Мы измеряем \(|\partial h_{T-1}/\partial h_0|\) без множителей головы или потерь. При нулевом входе все состояния остаются нулевыми, а каждая производная перехода равна \(1.2\), поэтому чувствительность растёт, хотя состояния ограничены. При входе \(x_t=1\) состояния приближаются к насыщению и чувствительность уменьшается. При \(T=1\) переходов из \(h_0\) в само себя нет, и чувствительность равна единице. Это намеренно контролируемые, необученные скалярные примеры, а не рейтинг архитектур или свидетельство качества решения задачи.
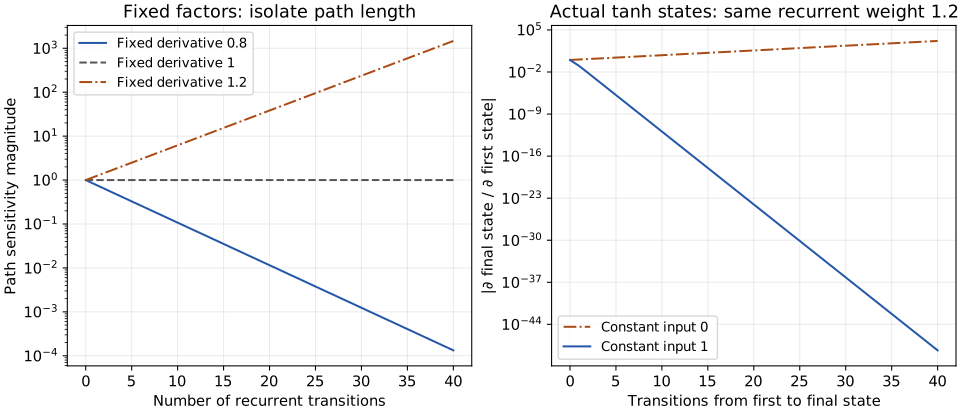
Графики измеряют чувствительность пути, а не норму всех градиентов общих весов. Поздние использования параметров всё ещё могут давать большой суммарный градиент, даже если далёкий сигнал исчезает. Важны и фактическая траектория, и расстояние до выхода с заданным целевым значением.
Обрезка ограничивает большой градиент, но не восстанавливает потерянный
После того как BPTT вычислит все производные по параметрам, соберите их в один вектор \(\mathbf g=\nabla_\theta\mathcal L\), мысленно развернув и соединив массивы параметров. Для положительного порога \(\tau\) обрезка по норме (norm clipping) задаёт
\[ \mathbf g_{\mathrm{clip}}= \begin{cases} \mathbf g,&\|\mathbf g\|_2\leq\tau,\\ \displaystyle\tau\frac{\mathbf g}{\|\mathbf g\|_2},&\|\mathbf g\|_2>\tau. \end{cases} \]
Градиент длиннее \(\tau\) сохраняет направление, но его длина уменьшается. Для нулевого градиента используется первая ветвь, избегая деления на ноль. Обрезку применяют после обратного прохода и до шага оптимизатора. Она может не дать очень большому градиенту нарушить обновление, но не восстанавливает информацию, затухшую на раннем пути. При обычном градиентном спуске длина обновления не превышает \(\eta\tau\). Адаптивный оптимизатор преобразует градиент дополнительно, поэтому эта граница непосредственно не ограничивает длину его шага параметров.
GRU учится, сколько удержать и сколько записать
Простая ячейка на каждом шаге преобразует старое состояние полным аффинным отображением и активацией. Управляемый рекуррентный блок (gated recurrent unit, GRU) добавляет прямой путь сохранения старого состояния и учится выбирать его долю. Вентиль (gate) — вектор выходов сигмоиды в \((0,1)\), вычисляемый по текущему наблюдению и предыдущему состоянию. Он умножает соответствующие координаты; это не фиксированный гиперпараметр и не команда включения или выключения.
Обозначим через \(\mathbf u_t\) вентиль удержания/обновления (update gate), через \(\mathbf r_t\) — вентиль сброса (reset gate), а через \(\widetilde{\mathbf h}_t\) — кандидат состояния (candidate state). Все они имеют размер \(1\times H\). Обновление состояния:
\[ \mathbf h_t=\mathbf u_t\odot\mathbf h_{t-1} +(\mathbf 1-\mathbf u_t)\odot\widetilde{\mathbf h}_t. \]
Координата \(\mathbf u_t\), близкая к единице, преимущественно сохраняет соответствующее старое состояние; близкая к нулю — отдаёт предпочтение кандидату. Для одной координаты \(u=0.9\), старого состояния \(0.5\) и кандидата \(-0.4\) получаем \(0.9(0.5)+0.1(-0.4)=0.410\). Эти иллюстративные значения объясняют смешивание; это не выходы обученной модели.
Для точного определения вентилей используем соглашение GRU в PyTorch из лекции. Для \(a\in\{u,r\}\),
\[ \mathbf a_t=\sigma\!\left( \mathbf x_t\mathbf W_{xa}^\top+\mathbf b_{xa} +\mathbf h_{t-1}\mathbf W_{ha}^\top+\mathbf b_{ha}\right). \]
Кандидат вычисляется как
\[ \begin{aligned} \widetilde{\mathbf h}_t=\tanh\Bigl(&\mathbf x_t\mathbf W_{xn}^\top+\mathbf b_{xn}\\ &+\mathbf r_t\odot(\mathbf h_{t-1}\mathbf W_{hn}^\top+\mathbf b_{hn})\Bigr). \end{aligned} \]
Каждая входная матрица имеет размер \(H\times D\), а рекуррентная — \(H\times H\). Сигмоида \(\sigma(v)=1/(1+e^{-v})\) действует покоординатно. Вентиль сброса задаёт, какая доля результата рекуррентного аффинного преобразования входит в кандидата. В этой реализации он действует после аффинной операции, включая её смещение; применение вентиля к предыдущему состоянию до умножения на \(\mathbf W_{hn}\) в общем случае задаёт другую модель. PyTorch называет вентиль обновления \(z_t\); мы используем \(\mathbf u_t\), чтобы оставить \(\mathbf z_t\) для предактиваций. Некоторые источники используют противоположное соглашение о смешивании, поэтому проверяйте, какой член умножается на названный вентиль.
При фиксированных значениях вентиля и кандидата производная прямого переноса равна \(\operatorname{diag}(\mathbf u_t)\). Этот путь может избегать повторного прохождения через производную tanh кандидата. Однако и вентили, и кандидат зависят от старого состояния: полный якобиан включает дополнительные производные этих зависимостей. Вентиль переноса около единицы создаёт полезный путь, но не гарантирует устойчивых градиентов или успешного запоминания.
LSTM отделяет хранимую память от видимого состояния
Ячейка долгой краткосрочной памяти (long short-term memory, LSTM) поддерживает два вектора: память ячейки \(\mathbf c_t\) и видимое скрытое состояние \(\mathbf h_t\), оба ширины \(H\). Вентиль забывания (forget gate) \(\mathbf f_t\) управляет удержанием памяти, входной вентиль (input gate) \(\mathbf i_t\) — записью, выходной вентиль (output gate) \(\mathbf o_t\) — передачей памяти в скрытое состояние. С кандидатом \(\widetilde{\mathbf c}_t\),
\[ \begin{aligned} \mathbf c_t&=\mathbf f_t\odot\mathbf c_{t-1} +\mathbf i_t\odot\widetilde{\mathbf c}_t,\\ \mathbf h_t&=\mathbf o_t\odot\tanh(\mathbf c_t). \end{aligned} \]
Для простой современной ячейки из лекции, без проекции и связей peephole, определим три сигмоидальных вентиля как
\[ \mathbf a_t=\sigma\!\left( \mathbf x_t\mathbf W_{xa}^\top +\mathbf h_{t-1}\mathbf W_{ha}^\top+\mathbf b_a\right), \qquad a\in\{f,i,o\}, \]
а кандидат как
\[ \widetilde{\mathbf c}_t=\tanh\!\left( \mathbf x_t\mathbf W_{xc}^\top +\mathbf h_{t-1}\mathbf W_{hc}^\top+\mathbf b_c\right). \]
Здесь смещения объединяют входные и рекуррентные смещения, используемые в LSTM PyTorch. В этом примере независимые последовательности начинаются с обоих нулевых состояний. Внешняя предсказывающая голова считывает \(\mathbf h_t\); внутренний выходной вентиль \(\mathbf o_t\) — другая операция, отличная от весов головы \(\mathbf W_o\).
При фиксированных значениях вентилей и кандидата производная прямого переноса памяти ячейки равна \(\operatorname{diag}(\mathbf f_t)\). Поэтому сохранение информации может идти через произведения вентилей забывания вместо повторяющихся рекуррентных аффинных преобразований и tanh простой RNN. Значения вентиля забывания ниже единицы всё ещё ослабляют длинный прямой путь, а зависимости через \(\mathbf h_{t-1}\) добавляют другие пути в полную производную. LSTM не обещает идеального хранения и не устраняет все проблемы градиентов.
| Ячейка | Состояние, передаваемое между позициями | Как изменяется состояние |
|---|---|---|
| Простая RNN | \(\mathbf h_t\) | Аффинное смешивание с последующей активацией |
| GRU | \(\mathbf h_t\) | Обучаемая покоординатная смесь сохранённого состояния и кандидата |
| LSTM | \((\mathbf c_t,\mathbf h_t)\) | Отдельные операции удержания, записи и раскрытия памяти с вентилями |
Вентили изменяют вычисления внутри ячейки. Они не отменяют необходимость обрабатывать однонаправленную последовательность по порядку, добавлять подходящую предсказывающую голову и обучать модель по заданной целевой функции. Следующий код делает эти границы явными.
PyTorch: рекуррентный слой и отдельная предсказывающая голова
nn.RNN в PyTorch обрабатывает целую последовательность общей рекуррентной ячейкой. Этот короткий пример на CPU использует три наблюдения по два признака, скрытую ширину два, tanh и фиксированные нулевые смещения. Отдельная голова nn.Linear превращает конечное состояние в одно предсказание регрессии.
import torch
from torch import nn

torch.manual_seed(6)
B, T, D, H, C = 1, 3, 2, 2, 1
X = torch.tensor([[[0.2, -0.1], [0.0, 0.3], [0.4, 0.1]]])
# Размер X: (B, T, D) — пакет, время, входные признаки.
rnn = nn.RNN(D, H, nonlinearity="tanh", bias=False,
             batch_first=True)
head = nn.Linear(H, C, bias=False)

output, final = rnn(X)       # Начальное скрытое состояние по умолчанию нулевое.
assert output.shape == (B, T, H)
assert final.shape == (1, B, H)
prediction = head(final[0])  # (B, H) -> (B, C)

target = X.new_tensor([[0.5]])
loss = 0.5 * (prediction - target).square().sum()
rnn.zero_grad(set_to_none=True)
head.zero_grad(set_to_none=True)
loss.backward()             # Вычисляет градиенты через все временные шаги.

for t, row in enumerate(output.detach()[0]):
    print(f"h_{t} = [{row[0].item():#.3g}, {row[1].item():#.3g}]")
print(f"prediction = {prediction.item():.3g}")
print(f"loss = {loss.item():.3g}")
При PyTorch 2.8 на CPU и указанном выше начальном значении генератора (seed) вывод имеет вид (три значащие цифры):
h_0 = [0.0128, 0.122]
h_1 = [0.00930, 0.0915]
h_2 = [0.0384, 0.314]
prediction = -0.144
loss = 0.208
Конечное состояние — последняя показанная строка. Голова объединяет две его координаты в одно предсказание; сравнение предсказания с целевым значением \(0.5\) даёт потери. Это результаты модели с заданным seed без обучения, а не обученный прогноз.
output содержит скрытое состояние в каждой позиции, размер \((B,T,H)\). final содержит конечное состояние каждого слоя и направления. Здесь один слой и одно направление, поэтому final[0] выбирает конечное состояние каждой последовательности, размер \((B,H)\). batch_first=True изменяет расположение осей последовательности, но не расположение осей конечного состояния.
Рекуррентный слой создаёт представления. Отдельная head преобразует конечное представление в предсказание задачи. Применение head(output) вместо этого создаст предсказание в каждой позиции, размер \((B,T,C)\), и потребует соответствующих целевых значений. bias=False соответствует нашему примеру с фиксированными нулевыми смещениями; активация теперь конкретно tanh.
Потери сохраняют множитель \(1/2\) и суммируются по примерам и выходным координатам, как в выводе. loss.backward() вычисляет градиенты параметров; затем оптимизатор обновил бы параметры. Очищайте буферы .grad перед каждым обратным проходом, если накопление не задумано специально. Для обрезки по норме вставьте torch.nn.utils.clip_grad_norm_(list(rnn.parameters()) + list(head.parameters()), max_norm=1.0) после обратного прохода и до шага оптимизатора.
Необученные параметры иллюстрируют вычисление. Практикум недели 06 содержит полные эксперименты обучения. Далее каждому слову будет сопоставлено собственное представление с позицией, после чего внимание напрямую объединит доступные позиции.
Слова становятся представлениями токенов с позиционной информацией
Теперь перейдём к моделям Transformer, использующим внимание для объединения информации из разных позиций последовательности. Внутри слоя позиции можно вычислять вместе, а не через цепочку рекуррентных состояний, и далёкие позиции могут взаимодействовать напрямую. Это делает Transformer полезным для построения контекстных представлений (contextual representations), хотя стоимость обычного полного внимания растёт квадратично с длиной последовательности.
В этой главе изучается энкодер Transformer (Transformer encoder) — часть, превращающая предоставленную последовательность в представления с учётом доступного контекста. Они подходят, например, для классификации последовательности или разметки её слов. В исходном Transformer также есть декодер (decoder), создающий выходную последовательность; здесь мы его не строим. Пример продолжения предложения даёт конкретный вход и мотивирующую цель, пока мы изучаем устройство энкодера. Сначала численно представим идентичность токена и позицию, затем построим внимание и полный блок энкодера. Исходная архитектура и сравнение вычислительных затрат приведены в Vaswani и др. (2017), §§3–4.
Превратите продолжение фразы в последовательность идентификаторов токенов
Вернёмся к предложению, которое хотим продолжить:
A journey of a thousand miles begins → with a single step.
Предоставленный префикс содержит семь слов. Мы хотим понять, как модель превращает их в численные представления до предсказания продолжения. Знание знакомой фразы даёт нам целевое значение; оно не означает, что небольшая необученная модель способна его создать.
Токен (token) — одна единица дискретной входной последовательности. Для примера используем намеренно простое правило: перевести слова в нижний регистр, разделить по пробелам и удалить пунктуацию. Поэтому вход имеет вид
a journey of a thousand miles beginsЗдесь по этому правилу одно слово — один токен. Другие токенизаторы (tokenizers) могут разбивать слова на меньшие части; семь позиций относятся именно к нашему заданному примеру.
Словарь (vocabulary) перечисляет различные токены, которые модель способна представлять. Назначим каждому целочисленный ID начиная с нуля. Сразу включим слова продолжения, чтобы тот же словарь мог описывать и заданные, и предсказанные слова. В префиксе шесть разных типов, к ним добавляются with, single и step: размер словаря \(K=9\). Для фиксированного примера не нужны токены заполнения (padding), неизвестного слова или конца последовательности. В более общем приложении потребовалось бы явное правило для слов вне словаря.
a имеют одинаковый ID, но разные позиции.
| Позиция \(t\) | Входной токен | ID токена \(k_t\) |
|---|---|---|
| 0 | a |
0 |
| 1 | journey |
1 |
| 2 | of |
2 |
| 3 | a |
0 |
| 4 | thousand |
3 |
| 5 | miles |
4 |
| 6 | begins |
5 |
ID — индекс для поиска, а не измерение. ID 4 не делает miles вдвое более значимым, чем ID 2. Порядок словарных записей произволен, если выборка и выходные метки согласованы. Различайте три числа: \(T=7\) позиций, \(K=9\) записей словаря и \(D=5\) признаков представления.
Выберите пятикоординатный эмбеддинг каждого токена
Эмбеддинг (embedding) сопоставляет дискретному токену вектор действительных чисел. Храним эти векторы как строки таблицы эмбеддингов \(\mathbf E_{\mathrm{vocab}}\in\mathbb R^{K\times D}\). ID выбирает строку, а не умножается на неё. Для позиции \(t\),
\[ \mathbf e_t=\mathbf E_{\mathrm{vocab}}[k_t,:], \qquad \mathbf e_t\in\mathbb R^{1\times D}. \]
Двоеточие означает «все координаты признаков». В обученной модели таблица эмбеддингов обычно является параметром, обучаемым вместе с остальной сетью. Для расчётов ниже возьмём явную необученную иллюстративную таблицу из Таблица 8. Ширина пять позволяет видеть каждую координату; это не утверждение, что пяти признаков достаточно для реального понимания языка. Обозначаем координаты индексами, не приписывая им вымышленные значения вроде «расстояние» или «важность».
| ID | Токен | \(j=0\) | \(j=1\) | \(j=2\) | \(j=3\) | \(j=4\) |
|---|---|---|---|---|---|---|
| 0 | a |
0.2 | -0.1 | 0.4 | 0 | -0.2 |
| 1 | journey |
0.5 | 0.3 | -0.2 | 0.1 | 0.4 |
| 2 | of |
-0.1 | 0.2 | 0 | -0.3 | 0.1 |
| 3 | thousand |
0.4 | -0.4 | 0.2 | 0.5 | -0.1 |
| 4 | miles |
0.1 | 0.5 | -0.3 | 0.2 | 0.3 |
| 5 | begins |
-0.3 | 0.1 | 0.5 | -0.2 | 0.2 |
| 6 | with |
0 | -0.2 | 0.1 | 0.3 | -0.4 |
| 7 | single |
0.3 | 0 | -0.1 | 0.4 | 0.2 |
| 8 | step |
-0.2 | 0.4 | 0.3 | -0.1 | 0.5 |
Соберём выбранные строки во входном порядке в матрицу эмбеддингов последовательности \(\mathbf E_{\mathrm{seq}}\in\mathbb R^{7\times5}\). В ней одна строка на появление токена, поэтому словарная строка a выбирается дважды. Например,
\[ \mathbf e_0=\mathbf e_3=(0.2,-0.1,0.4,0,-0.2). \]
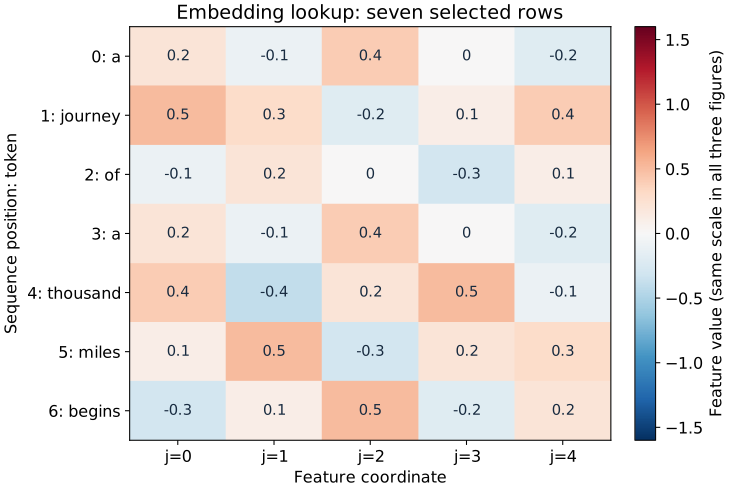
На Рисунок 4 показаны все семь выбранных строк. Сравните первую и четвёртую: значения совпадают в точности. Одна лишь выборка (lookup) даёт идентичность токена; она ещё не добавляет позиционный признак и не объединяет информацию других слов.
Задайте позицию вторым вектором
Рекуррентная ячейка встречает позиции через последовательные обновления состояния. Следующее вычисление внимания получает все семь строк вместе. Поэтому числовую позиционную информацию добавляем к идентичности токена. Позиционное кодирование (positional encoding) сопоставляет позиции \(t\) вектор \(\mathbf p_t\); токен в другом месте получает другой позиционный вектор.
Используем фиксированные синусы и косинусы нескольких частот по синусоидальной конструкции из Vaswani и др. (2017), §3.5. Пусть \(j=0,\ldots,D-1\) индексирует признак, а \(\lfloor j/2\rfloor\) обозначает целую часть \(j/2\). Определим
\[ \begin{aligned} \omega_j&=10000^{-2\lfloor j/2\rfloor/D},\\ P_{t,j}&= \begin{cases} \sin(t\omega_j),&j\text{ чётное},\\ \cos(t\omega_j),&j\text{ нечётное}. \end{cases} \end{aligned} \]
Здесь \(\omega_j\) — угловая частота, а тригонометрические функции используют радианы. Соседние координаты синуса и косинуса имеют общую частоту. При нашей нечётной ширине \(D=5\) пять элементов равны
\[ \mathbf p_t=\left( \sin t,\ \cos t,\ \sin\frac{t}{10000^{2/5}},\ \cos\frac{t}{10000^{2/5}},\ \sin\frac{t}{10000^{4/5}} \right). \]
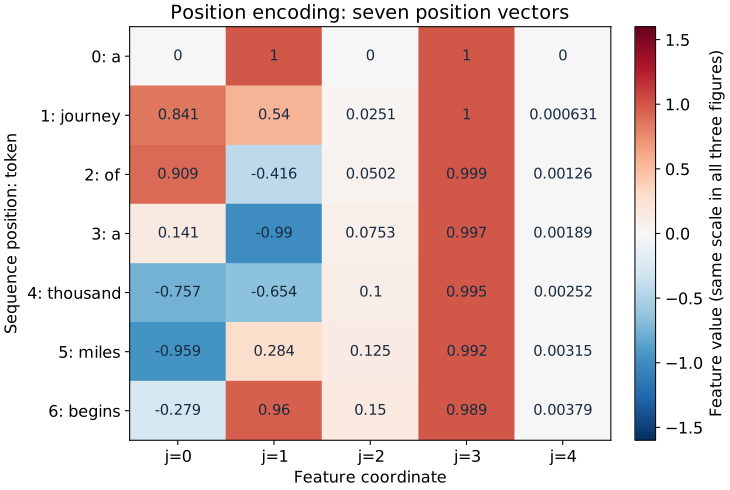
Первая пара быстро меняется на семи позициях. Вторая — медленнее; последний синус — ещё медленнее. В нулевой позиции синус равен нулю, косинус единице, поэтому \(\mathbf p_0=(0,1,0,1,0)\). В позиции три,
\[ \mathbf p_3\approx(0.141,-0.990,0.0753,0.997,0.00189). \]
На Рисунок 5 показана полная матрица \(\mathbf P\) размера \(7\times5\). Эти векторы зависят от позиции, а не от занимающего её слова. Медленные координаты могут мало меняться на коротком префиксе; числовые подписи делают это небольшое изменение заметным.
Обычная конструкция чётной ширины содержит полные пары синуса и косинуса. Для каждой полной пары формулы сложения углов выражают кодирование при \(t+\Delta\) как линейное преобразование пары при \(t\) с коэффициентами, зависящими от сдвига \(\Delta\). Наш пример ширины пять явно обрезает эту конструкцию: координата четыре — синус без пары. Не следует считать, что то же двухкоординатное соотношение относительного сдвига действует для этой последней координаты отдельно. Такой выбор сохраняет согласованность расчётов с пятью признаками; парная формула лекции описывает стандартный случай чётной ширины.
Сложите идентичность токена и позицию покоординатно
И выбранные эмбеддинги, и позиционные векторы имеют пять координат. Сложим соответствующие элементы:
\[ \mathbf h_t^{(0)}=\mathbf e_t+\mathbf p_t, \qquad \mathbf H^{(0)}=\mathbf E_{\mathrm{seq}}+\mathbf P \in\mathbb R^{7\times5}. \]
Верхний индекс \((0)\) обозначает входное представление до первого слоя энкодера; это метка глубины, а не степень или временной шаг. Заглавная \(\mathbf H^{(0)}\) собирает представления-строки \(\mathbf h_t^{(0)}\) всех семи позиций. Сложение сохраняет пять признаков на строку; конкатенация (concatenation) дала бы десять и здесь не используется.
Для первого a при \(t=0\),
\[ \begin{aligned} \mathbf h_0^{(0)} &=(0.2,-0.1,0.4,0,-0.2)+(0,1,0,1,0)\\ &=(0.2,0.9,0.4,1,-0.2). \end{aligned} \]
Для второго a при \(t=3\) тот же эмбеддинг объединяется с другим позиционным вектором:
\[ \mathbf h_3^{(0)}\approx(0.341,-1.09,0.475,0.997,-0.198). \]
Например, первая координата равна \(0.2+\sin 3\approx0.341\), вторая — \(-0.1+\cos 3\approx-1.09\). На Рисунок 6 показаны все полученные строки. Два появления a теперь различаются, хотя их базовый эмбеддинг по-прежнему общий. Все вычисления выполняются с полной точностью; показанные значения округляются лишь после этого.
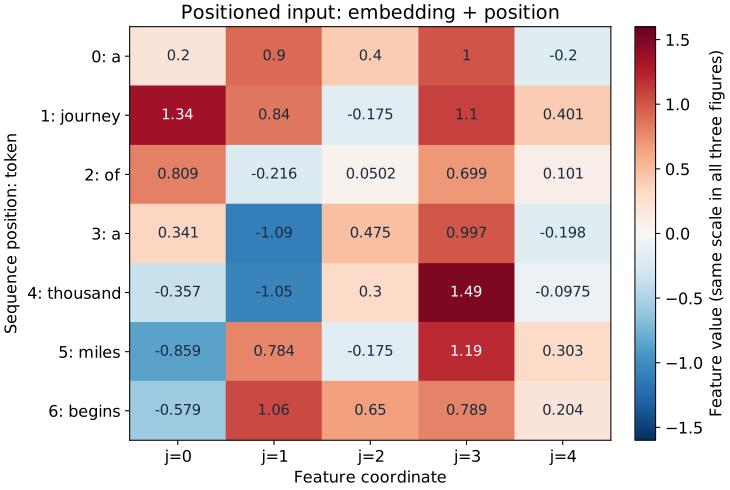
Три тепловые карты (heatmaps) используют одну цветовую шкалу, поэтому цвет имеет одинаковый числовой смысл до и после сложения. Подписи также показывают значения, слишком малые для различения по цвету.
В примере эмбеддинги не масштабируются. Исходный Transformer умножает их на \(\sqrt{D}\) до добавления позиции (Vaswani и др., §3.4). Во всём учебном примере это масштабирование опущено, чтобы не менять числа незаметно. Фиксированные синусоидальные кодирования — не единственный способ представить позицию; другой вариант — обучаемые позиционные эмбеддинги (learned position embeddings).
Токен a встречается в позициях ноль и три. Какие строки равны до добавления позиции? Какие различаются после? Был ли эмбеддинг слова заменён вторым обучаемым эмбеддингом?
Показать объяснение
Оба появления выбирают одну словарную строку, поэтому \(\mathbf e_0=\mathbf e_3\). Позиция задаёт \(\mathbf p_0\ne\mathbf p_3\), следовательно, \(\mathbf h_0^{(0)}\ne\mathbf h_3^{(0)}\). Для a по-прежнему есть один общий эмбеддинг; его два появления имеют разные представления с позицией. Ни одно ещё не получило информацию от других слов через внимание.
К чему готова эта матрица — и чего она ещё не сделала
| Объект | Размер | Что описывают строки |
|---|---|---|
| \(\mathbf E_{\mathrm{vocab}}\) | \(9\times5\) | Один эмбеддинг для каждого типа словаря |
| \(\mathbf E_{\mathrm{seq}}\) | \(7\times5\) | Эмбеддинги, выбранные для входных появлений токенов |
| \(\mathbf P\) | \(7\times5\) | Позиционная информация этих появлений |
| \(\mathbf H^{(0)}\) | \(7\times5\) | Входные появления с объединёнными идентичностью и позицией |
Мы преобразовали заданный префикс в семь строк признаков с позициями. Это вход следующего разбора внимания. Это не семь предсказанных слов, и здесь нет вероятностей словаря. На этом этапе каждая строка зависит лишь от выбранного эмбеддинга и позиции; позже внимание позволит ей использовать информацию из разрешённых позиций-источников.
Для задачи следующего слова в итоге понадобится словарная голова (vocabulary head): отображение контекстной строки ширины пять в девять оценок, по одной на токен словаря, с последующим вычислением вероятностей. Размер хранимых весов будет \(K\times D=9\times5\). Эта голова отличается от таблицы эмбеддингов: её хранимый размер тоже \(K\times D\), но операция — выборка. Совпадение размеров не делает эти операции взаимозаменяемыми.
Желаемый первый токен продолжения — with, ID 6. Мы включили его в словарь, но не обучали представление или голову предсказывать его. В дальнейших вычислениях внимания сохраним точно этот порядок токенов, таблицу эмбеддингов и правило позиции.
Одна голова внимания, операция за операцией
Что одна позиция должна считывать из других?
Матрица \(\mathbf H^{(0)}\) с позиционной информацией даёт каждому слову строку из пяти признаков. Как строка begins может использовать информацию journey или miles? Самовнимание (self-attention) строит новую строку, объединяя информацию позиций той же заданной последовательности. Запрос в позиции определяет, насколько сильно участвует каждый разрешённый источник. Источником может быть и сама позиция запроса.
Голова внимания (attention head) — одно такое вычисление сопоставления и смешивания со своими параметрами проекций. Проследим одну голову с шириной запросов/ключей \(d_k=3\) и шириной значений \(d_v=3\). Три её выходных признака — промежуточное представление. Несколько голов и возврат к ширине модели пять рассмотрим в следующем разделе.
Для отдельного расчёта используем \(\mathbf H^{(0)}\) напрямую, с полными значениями предыдущего раздела. Опустим смещения проекций, нормализацию и dropout, чтобы выделить операции внимания. Позже, внутри полного pre-norm энкодера, нормализация изменит вход внимания, поэтому численные проекции нужно будет пересчитать.
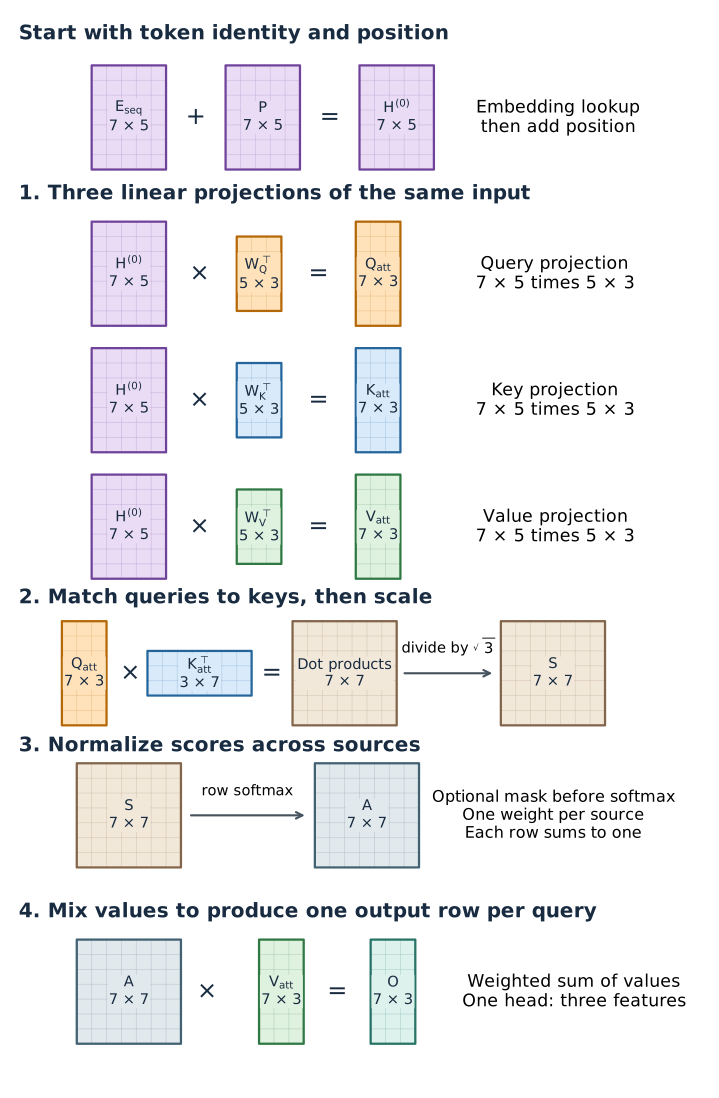
Прежде чем переходить к числам, рассмотрите полный путь на Рисунок 7. Выборка эмбеддингов даёт признаки токенов, а добавление позиционного кодирования создаёт фиолетовый вход \(7\times5\). Затем голова внимания применяет три линейных отображения: оранжевое для запросов, синее для ключей, зелёное для значений. Она умножает запросы на транспонированные ключи, делит оценки на \(\sqrt3\), применяет softmax по каждой строке и умножает полученные веса на значения. На выходе одна строка с тремя признаками для каждой из семи входных позиций. Разберём операции в этом порядке. Позиция добавляется перед этой отдельной головой, а не отдельно внутри каждой проекции.
Дайте одному входу три разные роли
Спроецируем вход по трём ветвям, показанным на Рисунок 7:
- Запрос (query) \(\mathbf q_t\) представляет то, чем позиция \(t\) сопоставляет источники.
- Ключ (key) \(\mathbf k_j\) представляет то, чем позиция-источник \(j\) участвует в сопоставлении.
- Значение (value) \(\mathbf v_j\) содержит признаки, которые будут фактически объединяться.
Эти названия описывают вычислительные роли; они не приписывают необученной координате конкретного языкового смысла. Запросы и ключи вместе определяют веса, а значения задают содержимое. Индекс источника \(j\) перебирает позиции последовательности, а не ID словаря или координаты признаков.
Мы мысленно используем один вход в трёх ветвях; математически выделять три физические копии не требуется. Каждое отображение общее для всех семи строк, как линейный слой использует одни веса для всех примеров. Выберем следующие разреженные необученные параметры, чтобы расчёты были читаемыми. По соглашению хранения «выход на вход» \(\mathbf W_Q,\mathbf W_K,\mathbf W_V\) имеют размер \(3\times5\). Справа умножаются их транспонированные матрицы \(5\times3\):
\[ \mathbf W_Q^\top= \begin{bmatrix} 1&0&0\\0&1&0\\0&0&1\\0&0&0\\0&0&0 \end{bmatrix}, \qquad \mathbf W_K^\top= \begin{bmatrix} \tfrac12&0&0\\0&1&0\\0&0&\tfrac12\\\tfrac12&0&0\\0&0&\tfrac12 \end{bmatrix}. \]
\[ \mathbf W_V^\top= \begin{bmatrix} 1&0&0\\0&0&0\\0&1&0\\0&0&\tfrac12\\0&0&\tfrac12 \end{bmatrix}. \]
Исходная статья о внимании напрямую именует матрицы правого умножения. Наше соглашение о транспонировании сохраняет ориентацию хранения предыдущих разделов курса; само умножение одинаково.
\[ \begin{aligned} \mathbf Q_{\mathrm{att}}&=\mathbf H^{(0)}\mathbf W_Q^\top,\\ \mathbf K_{\mathrm{att}}&=\mathbf H^{(0)}\mathbf W_K^\top,\\ \mathbf V_{\mathrm{att}}&=\mathbf H^{(0)}\mathbf W_V^\top. \end{aligned} \]
Каждое умножение имеет размер \((7\times5)(5\times3)=7\times3\). Индекс «att» отличает матрицу ключей от размера словаря \(K=9\). Для входной строки \((h_{t,0},h_{t,1},h_{t,2},h_{t,3},h_{t,4})\) в позиции \(t\) эти конкретные отображения дают
\[ \begin{aligned} \mathbf q_t&=(h_{t,0},h_{t,1},h_{t,2}),\\ \mathbf k_t&=\bigl((h_{t,0}+h_{t,3})/2,\ h_{t,1},\ (h_{t,2}+h_{t,4})/2\bigr),\\ \mathbf v_t&=\bigl(h_{t,0},\ h_{t,2},\ (h_{t,3}+h_{t,4})/2\bigr). \end{aligned} \]
Например, первая строка a равна \((0.2,0.9,0.4,1,-0.2)\), поэтому её ключ — \((0.6,0.9,0.1)\), а значение — \((0.2,0.4,0.4)\). Полные спроецированные массивы приведены ниже. Намеренно разреженные отображения иллюстрируют операцию; обученная проекция может использовать каждый входной признак в каждом выходном признаке.
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.2 | 0.9 | 0.4 |
1: journey |
1.34 | 0.84 | -0.175 |
2: of |
0.809 | -0.216 | 0.0502 |
3: a |
0.341 | -1.09 | 0.475 |
4: thousand |
-0.357 | -1.05 | 0.3 |
5: miles |
-0.859 | 0.784 | -0.175 |
6: begins |
-0.579 | 1.06 | 0.65 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.6 | 0.9 | 0.1 |
1: journey |
1.22 | 0.84 | 0.113 |
2: of |
0.754 | -0.216 | 0.0757 |
3: a |
0.669 | -1.09 | 0.139 |
4: thousand |
0.569 | -1.05 | 0.101 |
5: miles |
0.167 | 0.784 | 0.0642 |
6: begins |
0.105 | 1.06 | 0.427 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.2 | 0.4 | 0.4 |
1: journey |
1.34 | -0.175 | 0.75 |
2: of |
0.809 | 0.0502 | 0.4 |
3: a |
0.341 | 0.475 | 0.4 |
4: thousand |
-0.357 | 0.3 | 0.699 |
5: miles |
-0.859 | -0.175 | 0.748 |
6: begins |
-0.579 | 0.65 | 0.496 |
Проследите запрос «begins» через семь сопоставлений
Возьмём позицию \(t=6\), begins. Её запрос равен
\[ \mathbf q_6\approx(-0.579,1.06,0.650). \]
Чтобы оценить источник \(j=0\), первое a, вычислим скалярное произведение с \(\mathbf k_0=(0.6,0.9,0.1)\). Перемножим соответствующие признаки и сложим:
\[ \begin{aligned} \mathbf q_6\mathbf k_0^\top &=q_{6,0}k_{0,0}+q_{6,1}k_{0,1}+q_{6,2}k_{0,2}\\ &\approx(-0.579)(0.6)+(1.06)(0.9)+(0.650)(0.1)\\ &\approx0.672. \end{aligned} \]
Итог округлён из скалярного произведения полной точности; пересчёт только по показанным округлённым входам может немного отличаться. Скалярное произведение — оценка соответствия, а не вероятность. Оно зависит и от длин векторов, и от направлений, поэтому в общем случае не является косинусным сходством (cosine similarity).
Повторим расчёт для каждого из семи ключей, затем разделим каждый результат на \(\sqrt{d_k}=\sqrt3\):
\[ S_{6j}=\frac{\mathbf q_6\mathbf k_j^\top}{\sqrt3}, \qquad S_{60}\approx\frac{0.672}{\sqrt3}\approx0.388. \]
Масштаб использует ширину признаков запросов/ключей, а не число слов или размер словаря. При мотивирующем предположении независимых координат запросов/ключей с нулевым средним и единичной дисперсией немасштабированное скалярное произведение имеет дисперсию \(d_k\); деление на \(\sqrt{d_k}\) даёт единичную дисперсию. Это помогает избегать очень больших оценок, резко концентрирующих softmax. Это выбор масштаба, а не гарантия, что фактически обученные запросы соответствуют предположениям. Так устроено масштабированное скалярное внимание (scaled dot-product attention) в Vaswani и др. (2017), §3.2.1.
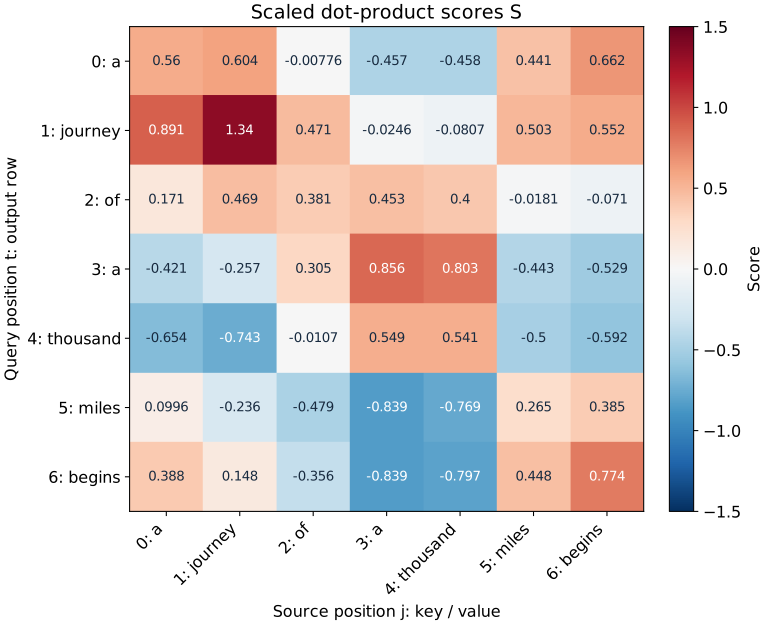
begins оценивает все семь доступных источников; softmax нормирует эту строку по источникам.
| Источник \(j\): токен | Скалярное произведение до масштабирования | \(S_{6j}\) | \(A_{6j}\) |
|---|---|---|---|
0: a |
0.672 | 0.388 | 0.185 |
1: journey |
0.257 | 0.148 | 0.146 |
2: of |
-0.617 | -0.356 | 0.0881 |
3: a |
-1.45 | -0.839 | 0.0544 |
4: thousand |
-1.38 | -0.797 | 0.0567 |
5: miles |
0.776 | 0.448 | 0.197 |
6: begins |
1.34 | 0.774 | 0.273 |
Нормализуйте по источникам, а не по признакам
Для одного запроса преобразуем семь масштабированных оценок в семь неотрицательных весов с помощью softmax:
\[ A_{6j}=\frac{\exp(S_{6j})}{\sum_{r=0}^{6}\exp(S_{6r})}. \]
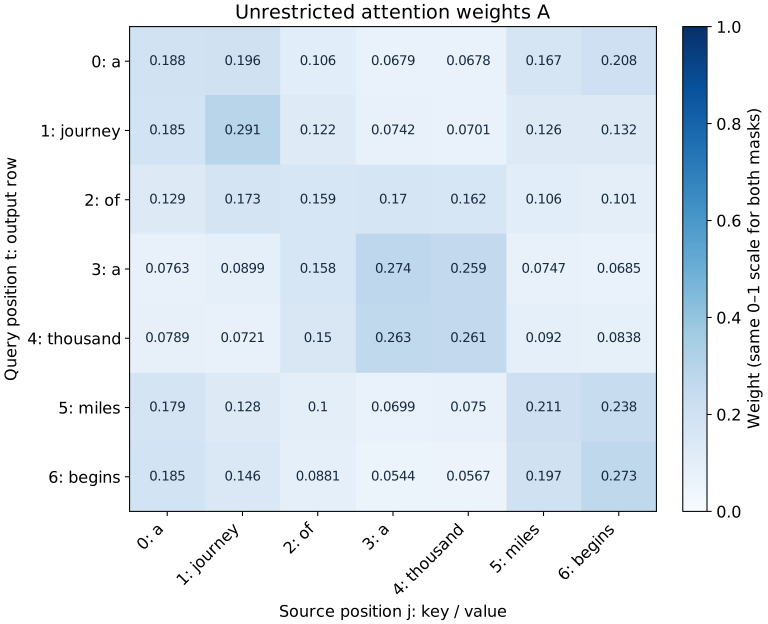
Знаменатель суммирует позиции-источники \(r\). У каждого запроса свой знаменатель. Его веса суммируются в единицу, и большая оценка получает больший вес. Изменение одной оценки источника меняет и другие нормализованные веса.
Для численной устойчивости (numerical stability) до возведения в экспоненту вычтем максимум строки \(m_6=\max_r S_{6r}\):
\[ A_{6j}=\frac{\exp(S_{6j}-m_6)}{\sum_{r=0}^{6}\exp(S_{6r}-m_6)}. \]
Общий множитель \(\exp(-m_6)\) сокращается, поэтому распределение остаётся прежним. Наибольший показатель экспоненты теперь ноль, что предотвращает переполнение от больших положительных оценок. Используя значения Таблица 13, получаем
\[ \mathbf A_{6,:}\approx (0.185,0.146,0.0881,0.0544,0.0567,0.197,0.273). \]
Это веса по семи предоставленным появлениям токенов, а не вероятности девяти возможных следующих слов. Их сумма полной точности равна единице; сумма округлённых значений может немного отличаться.
Используйте каждый вес для масштабирования целого вектора значений
Один скалярный вес \(A_{6j}\) умножает все три признака \(\mathbf v_j\). Сложим семь взвешенных векторов, чтобы получить выходную строку \(\mathbf o_6\):
\[ \mathbf o_6=\sum_{j=0}^{6}A_{6j}\mathbf v_j. \]
Для первого источника вклад равен
\[ A_{60}\mathbf v_0 \approx0.185\,(0.2,0.4,0.4) \approx(0.0371,0.0741,0.0741). \]
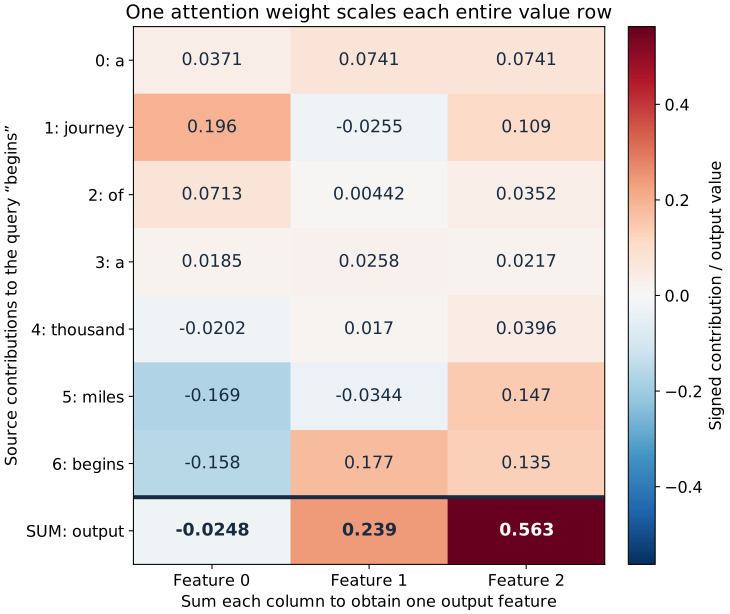
В Таблица 14 перечислены все семь вкладов. Суммируйте первый столбец признаков для выходного признака ноль, второй — для признака один, третий — для признака два. Получаем
\[ \mathbf o_6\approx(-0.0248,0.239,0.563). \]
begins.
| Источник \(j\): токен | Вклад 0 | Вклад 1 | Вклад 2 |
|---|---|---|---|
0: a |
0.0371 | 0.0741 | 0.0741 |
1: journey |
0.196 | -0.0255 | 0.109 |
2: of |
0.0713 | 0.00442 | 0.0352 |
3: a |
0.0185 | 0.0258 | 0.0217 |
4: thousand |
-0.0202 | 0.017 | 0.0396 |
5: miles |
-0.169 | -0.0344 | 0.147 |
6: begins |
-0.158 | 0.177 | 0.135 |
На Рисунок 8 та же сумма показана визуально: каждая из первых семи строк — один взвешенный вектор значений, а каждый столбец — признак. Отдельная нижняя строка суммирует элементы над ней. Читайте вниз по столбцу, а не по словам как по временному ряду. Веса внимания неотрицательны, но координаты значений могут быть отрицательными, поэтому вклады способны компенсировать друг друга. Выход — взвешенное среднее векторов значений, а не среднее ID слов, ключей или предсказанных вероятностей токенов.
Соберите то же вычисление для всех семи запросов
Правило сопоставления ничем не выделяет позицию шесть. Повторим его для каждой строки запроса или выразим все строки в матричном виде:
\[ \begin{aligned} \mathbf S&=\frac{\mathbf Q_{\mathrm{att}}\mathbf K_{\mathrm{att}}^\top}{\sqrt3} \in\mathbb R^{7\times7},\\ \mathbf A&=\operatorname{softmax}_{\mathrm{rows}}(\mathbf S) \in\mathbb R^{7\times7},\\ \mathbf O&=\mathbf A\mathbf V_{\mathrm{att}} \in\mathbb R^{7\times3}. \end{aligned} \]
Произведение оценок имеет размер \((7\times3)(3\times7)\). Строка \(t\) соответствует запросу \(t\), столбец \(j\) — источнику \(j\). Softmax по строкам сохраняет обе оси. Произведение значений имеет размер \((7\times7)(7\times3)\): общая размерность суммирует позиции-источники и оставляет один выход с тремя признаками на запрос.
На Рисунок 9 и Рисунок 10 показаны полные матрицы оценок и весов. В последней строке найдите предыдущий расчёт begins. Другая строка показывает, что другой запрос создаёт другие веса, хотя считывает те же ключи и значения.
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.122 | 0.205 | 0.567 |
1: journey |
0.342 | 0.15 | 0.579 |
2: of |
0.237 | 0.206 | 0.556 |
3: a |
0.16 | 0.262 | 0.541 |
4: thousand |
0.103 | 0.268 | 0.543 |
5: miles |
-0.0337 | 0.228 | 0.563 |
6: begins |
-0.0248 | 0.239 | 0.563 |
Параметры задают общие отображения, но \(\mathbf A\) вычисляется по этому входу. Это не постоянно обучаемая таблица весов семь на семь. Одна голова возвращает признаки \(7\times3\); она ещё не вернула представление энкодера ширины пять и не сделала предсказание по словарю.
Для запроса begins softmax возвращает семь весов. Каждый вес соответствует входному признаку, слову словаря или позиции-источнику? Какой вектор умножает \(A_{62}\) и сколько признаков остаётся в результате?
Показать объяснение
Каждый вес соответствует позиции-источнику. \(A_{62}\) умножает весь вектор значений из трёх признаков в позиции два, of. Сложение семи взвешенных векторов оставляет три признака в выходной строке. Softmax нормализует по семи источникам, а не по трём признакам значений или девяти записям словаря.
Измените видимость с помощью маски
Первый расчёт кодирует весь предоставленный префикс: каждая строка может использовать каждое заданное слово. Такая неограниченная видимость подходит, когда весь вход доступен для задачи. Другая задача может требовать, чтобы строка использовала лишь свой префикс, например когда предсказания ранних позиций не должны видеть последующие слова.
Каузальная маска (causal mask) разрешает источник \(j\) при \(j\leq t\) и исключает его при \(j>t\). Добавим маску к оценкам до softmax:
\[ M_{tj}=\begin{cases}0,&j\leq t,\\-\infty,&j>t,\end{cases} \qquad \mathbf A^{\mathrm{causal}} =\operatorname{softmax}_{\mathrm{rows}}(\mathbf S+\mathbf M). \]
Исключённые источники получают нулевой вес, поскольку \(\exp(-\infty)=0\). Разрешённые источники заново нормализуются до суммы один. Простое обнуление части уже нормализованных весов оставило бы неверную сумму и является другой операцией. Каждый запрос здесь включает себя, поэтому полностью замаскированных строк нет; softmax для строки из одних \(-\infty\) был бы не определён.
Для begins, \(t=6\), оба правила разрешают все семь заданных источников: последние строки совпадают. Вместо этого рассмотрите journey, \(t=1\), в Таблица 16. Каузальные веса приблизительно равны \((0.389,0.611,0,0,0,0,0)\), поскольку доступны только первое a и journey.
journey в позиции один показывает различие правил видимости: причинное внимание (causal attention) заново нормирует веса только по позициям ноль и один.
| Источник \(j\): токен | Без ограничений \(A_{1j}\) | Причинное \(A_{1j}\) |
|---|---|---|
0: a |
0.185 | 0.389 |
1: journey |
0.291 | 0.611 |
2: of |
0.122 | 0 |
3: a |
0.0742 | 0 |
4: thousand |
0.0701 | 0 |
5: miles |
0.126 | 0 |
6: begins |
0.132 | 0 |
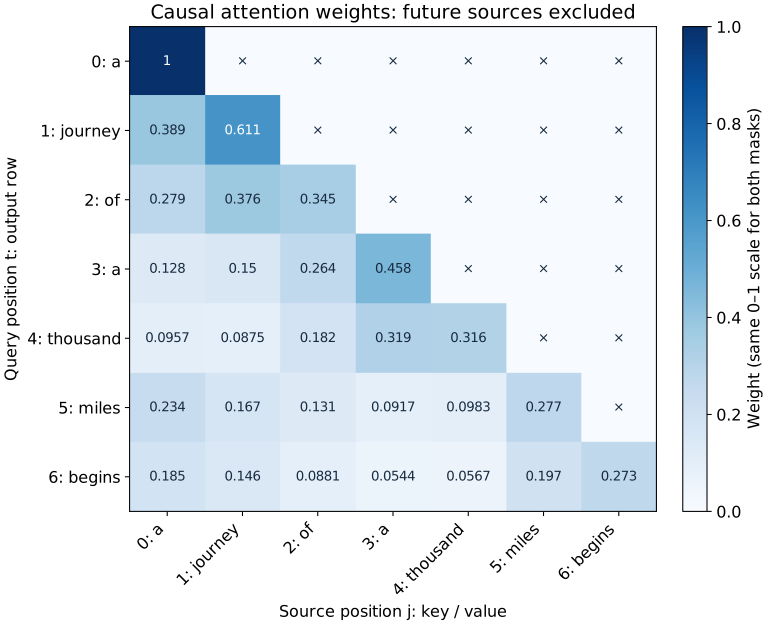
Выход головы с маской равен \(\mathbf O^{\mathrm{causal}}=\mathbf A^{\mathrm{causal}}\mathbf V_{\mathrm{att}}\). Для этой отдельной головы изменение входной строки после позиции один не может изменить каузальный выход в позиции один: оно не меняет ни запрос, ни разрешённые ключи/значения источников. То же изменение может повлиять на выход без ограничений. В полной модели граница информации должна соблюдаться и во всех предыдущих слоях; поздняя маска не может удалить информацию будущего, уже смешанную во входной строке.
В разборе энкодера на заданном префиксе используем внимание без ограничений. Продолжение остаётся мотивацией, а не демонстрацией авторегрессионного декодера (autoregressive decoder). Теперь одна голова проверена; в следующем разделе другая получит собственные проекции, после чего мы соединим выходные признаки и вернёмся к ширине пять.
Несколько голов возвращают контекстное представление той же ширины
Одна голова выбирает распределение по позициям-источникам и смешивает три признака значений с этим распределением. Вторая может выбрать другое распределение и извлечь другой набор признаков. Несколько голов дают каждому запросу несколько отдельно вычисленных взглядов на один контекст. Они читают один вход, а не последовательные части предложения.
Сохраняем \(T=7\), ширину модели \(D=5\) и первую голову точно в рассчитанном виде. Добавим вторую с шириной запросов/ключей \(d_k=3\) и значений \(d_v=3\). Обе головы имеют неограниченную видимость заданного префикса. Все отображения ниже — иллюстративные необученные параметры; смещения и dropout по-прежнему опущены.
Две головы, два набора параметров проекции
Верхний индекс \([i]\) обозначает голову, а не временной шаг или слой энкодера. Для \(i=1,2\),
\[ \begin{aligned} \mathbf Q_{\mathrm{att}}^{[i]}&=\mathbf H^{(0)}(W_Q^{[i]})^\top,\\ \mathbf K_{\mathrm{att}}^{[i]}&=\mathbf H^{(0)}(W_K^{[i]})^\top,\\ \mathbf V_{\mathrm{att}}^{[i]}&=\mathbf H^{(0)}(W_V^{[i]})^\top,\\ \mathbf A^{[i]}&=\operatorname{softmax}_{\mathrm{row}}\!\left( \frac{\mathbf Q_{\mathrm{att}}^{[i]}(\mathbf K_{\mathrm{att}}^{[i]})^\top}{\sqrt{3}}\right),\\ \mathbf O^{[i]}&=\mathbf A^{[i]}\mathbf V_{\mathrm{att}}^{[i]}. \end{aligned} \]
Отображения первой головы — \(W_Q,W_K,W_V\) из разбора одной головы. Вторая использует
\[ W_Q^{[2]}=\begin{bmatrix}0&0&0&1&0\\0&0&0&0&1\\0.5&0.5&0&0&0\end{bmatrix},\qquad W_K^{[2]}=\begin{bmatrix}0&0&0&1&0\\0&0&1&0&0\\0&0.5&0&0&0.5\end{bmatrix}, \]
\[ W_V^{[2]}=\begin{bmatrix}0&1&0&0&0\\0&0&0&1&0\\0.5&0&0&0&0.5\end{bmatrix}. \]
Каждое хранимое отображение имеет размер \(3\times5\), поэтому транспонированная матрица правого умножения — \(5\times3\). Обе головы проецируют весь вход из пяти признаков. Разреженные элементы упрощают ручной расчёт; голова 2 не ограничена заранее заданной второй половиной входа.
Поэтому для строки begins голова 2 строит
\[ \begin{aligned} \mathbf q_6^{[2]}&=(h_{6,3}^{(0)},\;h_{6,4}^{(0)},\;0.5h_{6,0}^{(0)}+0.5h_{6,1}^{(0)}) \\&\approx(0.789,\;0.204,\;0.240),\\ \mathbf v_6^{[2]}&=(h_{6,1}^{(0)},\;h_{6,3}^{(0)},\;0.5h_{6,0}^{(0)}+0.5h_{6,4}^{(0)}) \\&\approx(1.06,\;0.789,\;-0.188). \end{aligned} \]
Она повторяет операции оценивания, масштабирования и softmax по строкам из разбора одной головы со своими ключами. В Таблица 17 сравниваются полученные смеси для одного запроса. Каждый столбец весов здесь суммируется в единицу, поскольку показывает полное распределение источников одного запроса одной головы. Мы не нормализуем две головы вместе.
begins. Обе головы могут читать все семь источников.
| Источник | Вес головы 1 | Вес головы 2 |
|---|---|---|
0: a |
0.185 | 0.147 |
1: journey |
0.146 | 0.149 |
2: of |
0.0881 | 0.116 |
3: a |
0.0544 | 0.129 |
4: thousand |
0.0567 | 0.16 |
5: miles |
0.197 | 0.154 |
6: begins |
0.273 | 0.143 |
Вторая голова задаёт более равномерное распределение в этом конкретном примере. Это следует из фиксированных чисел и не доказывает, что обученная голова обнаружила грамматическую роль. Отдельные параметры допускают разные смеси, но не заставляют каждую голову стать отличной от других или полезной (Vaswani и др., §3.2.2).
Для begins две взвешенные суммы равны
\[ \mathbf o_6^{[1]}\approx(-0.0248,\;0.239,\;0.563),\qquad \mathbf o_6^{[2]}\approx(0.196,\;1.06,\;0.0863). \]
Значения различаются, поскольку различны и веса источников, и проекции значений. Координата ноль одной головы не обязана означать то же, что координата ноль другой. Полные выходы доступны ниже; первая таблица воспроизводит результат одной головы из предыдущего раздела.
Посмотреть все семь выходных строк обеих голов
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.122 | 0.205 | 0.567 |
1: journey |
0.342 | 0.15 | 0.579 |
2: of |
0.237 | 0.206 | 0.556 |
3: a |
0.16 | 0.262 | 0.541 |
4: thousand |
0.103 | 0.268 | 0.543 |
5: miles |
-0.0337 | 0.228 | 0.563 |
6: begins |
-0.0248 | 0.239 | 0.563 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 |
|---|---|---|---|
0: a |
0.277 | 1.06 | 0.104 |
1: journey |
0.382 | 1.05 | 0.0938 |
2: of |
0.218 | 1.05 | 0.0923 |
3: a |
0.0352 | 1.09 | 0.0776 |
4: thousand |
-0.0919 | 1.12 | 0.0523 |
5: miles |
0.0969 | 1.08 | 0.0689 |
6: begins |
0.196 | 1.06 | 0.0863 |
Соедините признаки, не соединяя позиции
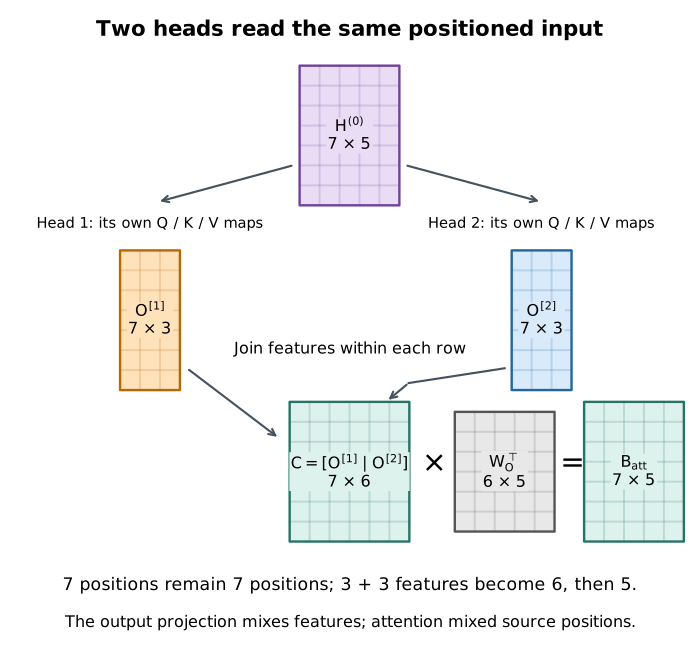
На Рисунок 12 показаны обе головы через конкатенацию и проекцию. Конкатенация размещает два выходных вектора рядом внутри каждой строки запроса:
\[ \mathbf C=[\mathbf O^{[1]}\mid\mathbf O^{[2]}]\in\mathbb R^{7\times6},\qquad \mathbf c_6\approx(-0.0248,\;0.239,\;0.563,\;0.196,\;1.06,\;0.0863). \]
Первые три столбца принадлежат голове 1, следующие три — голове 2. Строка шесть по-прежнему описывает begins. Конкатенация по оси позиций дала бы четырнадцать строк и была бы другой операцией. Мы также не складываем и не усредняем выходы голов: отдельные координаты позволяют следующему отображению выбирать, как их объединить.
Линейная выходная проекция возвращает ширину модели
Обучаемая проекция объединяет шесть признаков голов в пять признаков модели. Храним \(W_O\in\mathbb R^{5\times6}\), поэтому
\[ \mathbf B_{\mathrm{att}}=\mathbf C W_O^\top\in\mathbb R^{7\times5},\qquad W_O=\begin{bmatrix} 1&0&0&0.5&0&0\\ 0&1&0&0&0.5&0\\ 0&0&1&0&0&0.5\\ 0.5&0&0&0&1&0\\ 0&0.5&0&1&0&0 \end{bmatrix}. \]
Здесь \(\mathbf B_{\mathrm{att}}\) — выход ветви внимания, который войдёт в энкодер следующего раздела. Заглавная \(O\) в \(W_O\) отличает эту проекцию от считывания задачи \(W_o\). Проекция смешивает признаки внутри каждой строки; матрицы внимания уже выполнили смешивание по позициям-источникам.
Например, первый выходной признак begins равен
\[ B_{\mathrm{att},6,0}=c_{6,0}+0.5c_{6,3} \approx-0.0248+0.5(0.196)\approx0.0732. \]
Приближение показано с тремя значащими цифрами; расчёт использует неокруглённые значения. Полная строка равна
\[ \mathbf b_{\mathrm{att},6}\approx(0.0732,\;0.768,\;0.606,\;1.05,\;0.315). \]
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
0.26 | 0.736 | 0.619 | 1.12 | 0.379 |
1: journey |
0.533 | 0.672 | 0.626 | 1.22 | 0.457 |
2: of |
0.346 | 0.733 | 0.602 | 1.17 | 0.32 |
3: a |
0.178 | 0.805 | 0.58 | 1.17 | 0.166 |
4: thousand |
0.057 | 0.826 | 0.569 | 1.17 | 0.0421 |
5: miles |
0.0147 | 0.767 | 0.598 | 1.06 | 0.211 |
6: begins |
0.0732 | 0.768 | 0.606 | 1.05 | 0.315 |
| Этап | Размер | Что изменяется |
|---|---|---|
| Вход с позицией \(\mathbf H^{(0)}\) | \(7\times5\) | Исходное представление |
| Запросы, ключи и значения каждой головы | \(7\times3\) | Собственные спроецированные признаки |
| Веса внимания каждой головы | \(7\times7\) | Распределение по источникам для каждого запроса |
| Выход каждой головы \(\mathbf O^{[i]}\) | \(7\times3\) | Контекст, смешанный внутри этой головы |
| Конкатенированные выходы \(\mathbf C\) | \(7\times6\) | Два набора признаков расположены рядом |
| Выходной правый множитель \(W_O^\top\) | \(6\times5\) | Отображение соединённых признаков в признаки модели |
| Ветвь внимания \(\mathbf B_{\mathrm{att}}\) | \(7\times5\) | Контекстные признаки исходной ширины модели |
Как учебный пример соотносится со стандартными реализациями
Обычное соглашение Transformer выбирает \(d_k=d_v=D/N_{\mathrm{head}}\), поэтому все выходы голов вместе имеют ширину \(D\). Тогда выходная проекция отображает \(D\) признаков в \(D\); она всё равно учится смешивать головы, хотя ширина не меняется.
Наш намеренно небольшой пример использует \(D=5\) и две головы ширины три, что даёт соединённую ширину шесть. Уравнения внимания допускают такой выбор. Однако стандартный nn.MultiheadAttention в PyTorch делит embed_dim поровну между головами, поэтому embed_dim=5, num_heads=2 не поддерживается. Для точного воспроизведения примера нужны явные линейные отображения запросов/ключей/значений \(5\to3\) каждой головы, операции внимания, конкатенация признаков и выходное линейное отображение \(6\to5\) (документация PyTorch 2.8). При ширине модели, делящейся на число голов, можно использовать обычный модуль.
Теперь есть семь контекстных строк по пять признаков. Это не сгенерированные слова и не вероятности словаря. Это также ещё не полные выходы энкодера: в следующем разделе ветвь внимания войдёт в блок с нормализацией, остаточными сложениями и MLP, действующим в каждой позиции. В pre-norm блоке внимание получает нормализованные входы, поэтому численные выходы нужно пересчитать.
Внутри полного энкодера Transformer
Внимание позволяет каждому слову считывать другие слова. Блоку энкодера также нужны способы сохранить входное представление, нелинейно преобразовать собранные признаки и удерживать входы этих преобразований в контролируемом масштабе. Энкодер Transformer объединяет эти задачи через внимание, LayerNorm, остаточные сложения (residual additions) и позиционный многослойный перцептрон (position-wise MLP).
На Рисунок 13 соединён весь путь: ID токенов выбирают эмбеддинги, позиционные векторы добавляются один раз, строки с позицией проходят стек энкодера, а отдельная предсказывающая голова считывает конечные представления. Развёрнутый блок показывает оба остаточных пути; рамка повторения относится ко всему блоку, а не только вниманию. Пунктирная граница выделяет энкодер после подготовки входа. Голова задачи находится вне него и будет определена в следующем разделе.
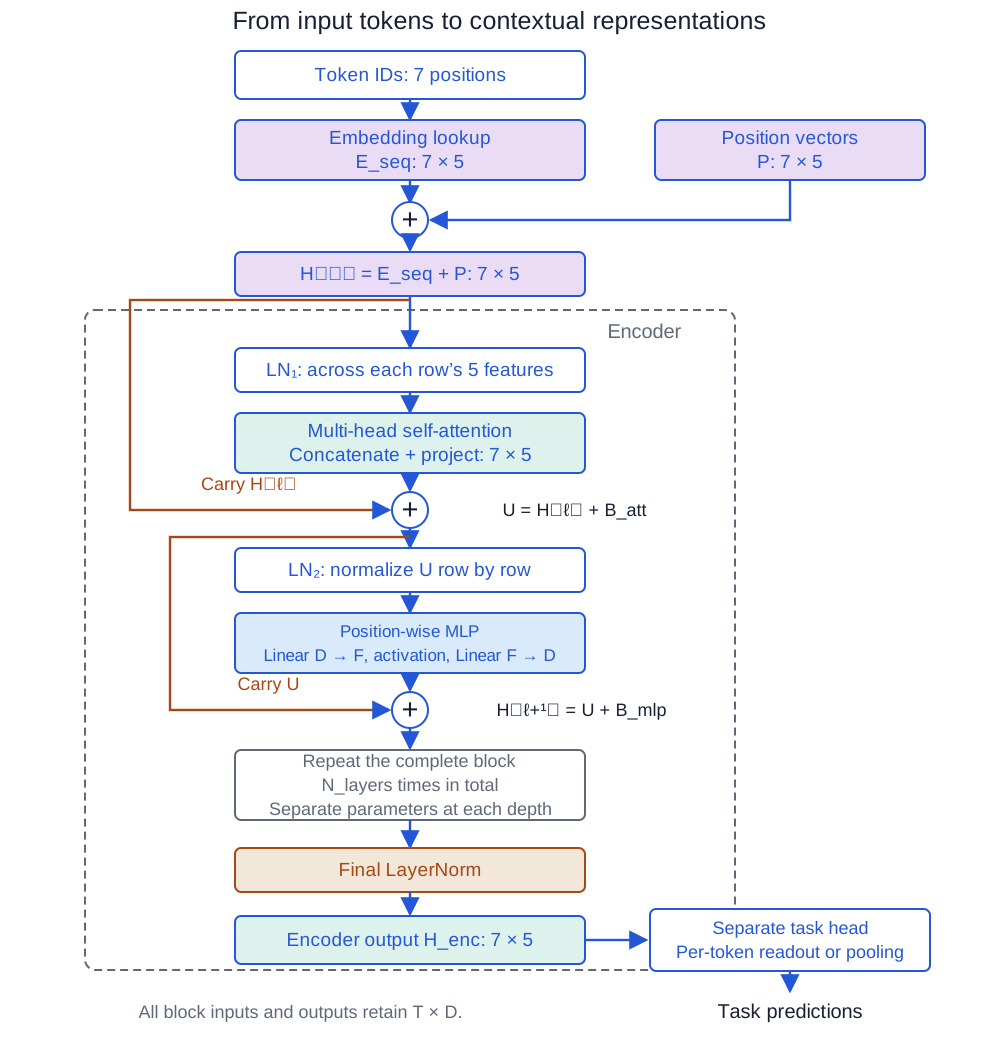
Соберём pre-norm блок из лекции: нормализуем вход каждой преобразующей ветви и затем добавим её результат к обходному пути (bypass). Сохраняем те же семь позиций, пять признаков модели, две головы ширины три и параметры внимания. Численный пример использует один блок, скрытую ширину MLP \(F=4\) и ReLU. Смещения внимания и dropout по-прежнему опущены; смещения MLP включены явно. Все параметры остаются иллюстративными и необученными.
Прочитайте блок как два обновления представления
Для глубины энкодера \(\ell\) блок вычисляет
\[ \begin{aligned} \mathbf X&=\operatorname{LN}_1(\mathbf H^{(\ell)}),\\ \mathbf B_{\mathrm{att}}&=\operatorname{MHA}(\mathbf X),\\ \mathbf U&=\mathbf H^{(\ell)}+\mathbf B_{\mathrm{att}},\\ \mathbf R&=\operatorname{LN}_2(\mathbf U),\\ \mathbf B_{\mathrm{mlp}}&=\operatorname{MLP}(\mathbf R),\\ \mathbf H^{(\ell+1)}&=\mathbf U+\mathbf B_{\mathrm{mlp}}. \end{aligned} \]
Здесь \(\operatorname{MHA}\) включает обе головы, конкатенацию признаков и выходную проекцию из разбора нескольких голов. Каждая матрица выше имеет размер \(7\times5\). На Рисунок 14 выделены два обходных пути. Первое сложение сохраняет вход блока \(\mathbf H^{(\ell)}\), второе — промежуточный результат \(\mathbf U\). Ни одно не переносит нормализованный вход ветви. Это остаточные обновления того же типа, что введён в главе недели 05.
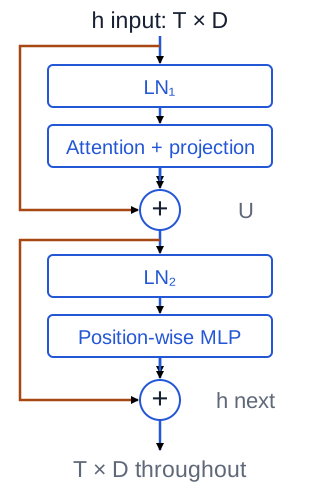
| Символ | Значение в этом блоке |
|---|---|
| \(\ell\) | Глубина энкодера; не связана с позицией токена \(t\) и индексом головы \([i]\) |
| \(\mathbf X\), \(\mathbf R\) | Нормализованные входы внимания и MLP |
| \(\mathbf U\) | Представление после первого остаточного сложения |
| \(\mathbf B_{\mathrm{att}}\), \(\mathbf B_{\mathrm{mlp}}\) | Выходы двух преобразующих ветвей |
| \(F\) | Скрытая ширина MLP, в примере четыре |
| \(\boldsymbol\gamma\), \(\boldsymbol\beta\) | Обучаемые масштабы и сдвиги признаков одного LayerNorm |
| \(\epsilon\) | Положительный стабилизатор знаменателя, здесь \(10^{-5}\) |
LayerNorm работает по признакам внутри одного слова
На Рисунок 15 разделены оси трёх операций: внимание объединяет позиции-источники, а LayerNorm и общий MLP работают внутри каждой строки.
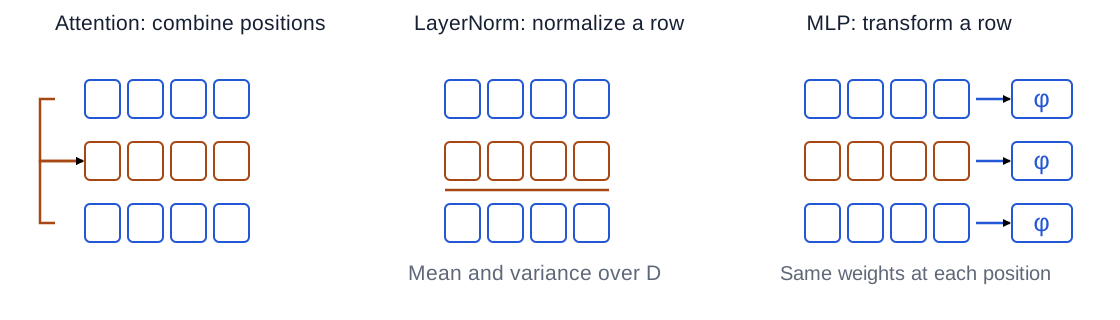
Для строки \(\mathbf h_t\in\mathbb R^5\) LayerNorm сначала вычисляет среднее и дисперсию с делением на число признаков (population variance) по пяти признакам:
\[ \mu_t=\frac15\sum_{c=0}^4 h_{t,c},\qquad \sigma_t^2=\frac15\sum_{c=0}^4(h_{t,c}-\mu_t)^2. \]
Затем для признака \(c\),
\[ \operatorname{LN}(\mathbf h_t)_c =\gamma_c\frac{h_{t,c}-\mu_t}{\sqrt{\sigma_t^2+\epsilon}}+\beta_c. \]
Вычитание среднего центрирует строку, деление управляет масштабом. Обучаемые \(\gamma_c\) и \(\beta_c\) позволяют модели корректировать каждый полученный признак. Один вектор параметров общий для позиций, но каждая позиция задаёт собственные статистики. \(\operatorname{LN}_1\) и \(\operatorname{LN}_2\) имеют отдельные обучаемые параметры, даже если начальные значения равны.
В ручном расчёте оба используют \(\boldsymbol\gamma=(1,1,1,1,1)\) и \(\boldsymbol\beta=(0,0,0,0,0)\). Это значения параметров, а не требование заморозить их. При них нормализованная строка имеет нулевое среднее и дисперсию \(\sigma_t^2/(\sigma_t^2+\epsilon)\), немного меньше единицы. У постоянной строки центрированные признаки нулевые, поэтому выход равен \(\boldsymbol\beta\); \(\epsilon\) сохраняет ненулевой знаменатель.
LayerNorm не усредняет по словам или примерам пакета (batch). Для размера \((B,T,D)\) nn.LayerNorm(D) нормализует последнюю ось признаков независимо для каждого примера и позиции. В обучении и применении используются статистики текущей строки, а не накопленные статистики BatchNorm (документация LayerNorm PyTorch 2.8). Это также означает, что сама нормализация не переносит информацию между позициями токенов.
Для begins вход с позиционной информацией равен
\[ \mathbf h_6^{(0)}\approx(-0.579,\;1.06,\;0.650,\;0.789,\;0.204). \]
Его среднее \(\mu_6\approx0.425\), дисперсия \(\sigma_6^2\approx0.329\). Нормализация первого признака даёт
\[ X_{6,0}=\frac{h_{6,0}^{(0)}-\mu_6}{\sqrt{\sigma_6^2+10^{-5}}} \approx-1.75. \]
Полная нормализованная строка равна \(\mathbf x_6\approx(-1.75,1.11,0.393,0.635,-0.385)\). Приближённые входы здесь объясняют арифметику; все дальнейшие расчёты используют неокруглённые значения.
Пересчитайте внимание и добавьте исходный вход
В разборе нескольких голов две головы читали \(\mathbf H^{(0)}\). Внутри этого блока они читают \(\mathbf X=\operatorname{LN}_1(\mathbf H^{(0)})\). Для каждой головы пересчитайте
\[ \mathbf Q_{\mathrm{att}}^{[i]}=\mathbf X(W_Q^{[i]})^\top,\qquad \mathbf K_{\mathrm{att}}^{[i]}=\mathbf X(W_K^{[i]})^\top, \]
\[ \mathbf V_{\mathrm{att}}^{[i]}=\mathbf X(W_V^{[i]})^\top. \]
Оставшиеся операции прежние: скалярные произведения, деление на \(\sqrt3\), softmax по строкам, взвешенные значения, конкатенация признаков и выходная проекция. Но нормализация меняет все семь входных строк, а значит — запросы, ключи, значения и итоговые смеси. Нельзя вставить выход предыдущего раздела в этот блок без изменений.
Новая ветвь внимания для begins равна
\[ \mathbf b_{\mathrm{att},6}\approx(-1.38,\;0.546,\;0.102,\;0.537,\;-0.299). \]
Она отличается от прежнего ненормализованного результата \((0.0732,0.768,0.606,1.05,0.315)\). Параметры те же, вход другой. Первое остаточное сложение добавляет новый результат ветви к исходному входу с позиционной информацией:
\[ \mathbf u_6=\mathbf h_6^{(0)}+\mathbf b_{\mathrm{att},6} \approx(-1.96,\;1.61,\;0.752,\;1.33,\;-0.0954). \]
Например, \(u_{6,0}=h_{6,0}^{(0)}+B_{\mathrm{att},6,0}\approx-1.96\). Обходной путь сохраняет представление, к которому ветвь предлагает обновление. Он не копирует \(\mathbf x_6\) в сумму.
MLP преобразует каждую контекстную строку отдельно
Вторая нормализация работает с \(\mathbf U\), статистики которого отличаются от статистик входа блока. Для begins среднее приблизительно \(0.325\), дисперсия \(1.65\), что даёт
\[ \mathbf r_6=\operatorname{LN}_2(\mathbf u_6) \approx(-1.78,\;0.998,\;0.333,\;0.780,\;-0.327). \]
Теперь MLP преобразует эту строку двумя аффинными отображениями с нелинейной активацией между ними:
\[ \begin{aligned} \mathbf Z_{\mathrm{mlp}}&=\mathbf R W_1^\top+\mathbf b_1,\\ \mathbf J_{\mathrm{mlp}}&=\operatorname{ReLU}(\mathbf Z_{\mathrm{mlp}}),\\ \mathbf B_{\mathrm{mlp}}&=\mathbf J_{\mathrm{mlp}} W_2^\top+\mathbf b_2. \end{aligned} \]
Смещения распространяются на все строки (broadcasting). \(W_1\) имеет размер \(4\times5\), \(W_2\) — \(5\times4\). В этом намеренно небольшом примере каждая строка переходит от пяти входных признаков к четырём скрытым, затем обратно к пяти. В практических Transformer \(F\) часто больше \(D\); четыре здесь — выбор для расчёта, а не требование архитектуры. Одни параметры MLP действуют на каждую позицию. Именно это означает позиционный (position-wise): MLP смешивает признаки внутри строки, а внимание — информацию между строками (Vaswani и др., §3.3).
Для примера выберем
\[ W_1=\begin{bmatrix} 1&0&-0.5&0&0\\0&1&0&0&-0.5\\0&0&1&0.5&0\\0.5&0&0&0&1 \end{bmatrix}, \]
\[ \mathbf b_1=(0.1,-0.2,0.15,0.05), \]
\[ W_2=\begin{bmatrix} 0.5&0&0.2&0\\0&0.5&0&0.2\\0.2&0&0.5&0\\0&0.2&0&0.5\\0.3&0&0&0.3 \end{bmatrix}, \]
\[ \mathbf b_2=(0.05,-0.05,0,0.1,-0.1). \]
Для begins эти отображения дают
\[ \mathbf z_{\mathrm{mlp},6}\approx(-1.85,\;0.962,\;0.872,\;-1.17), \]
\[ \mathbf j_{\mathrm{mlp},6}\approx(0,\;0.962,\;0.872,\;0). \]
Например, первая предактивация равна \(r_{6,0}-0.5r_{6,2}+0.1\approx-1.85\), и ReLU обнуляет её. Третья равна \(r_{6,2}+0.5r_{6,3}+0.15\approx0.872\) и сохраняется. Первый выходной признак затем равен \(0.5j_{6,0}+0.2j_{6,2}+0.05\approx0.224\), где \(j\) здесь обозначает скрытые признаки MLP этой строки.
Полная ветвь MLP равна
\[ \mathbf b_{\mathrm{mlp},6}\approx(0.224,\;0.431,\;0.436,\;0.292,\;-0.100). \]
Без нелинейной активации между отображениями их композиция осталась бы аффинной. ReLU делает преобразование признаков нелинейным. Другие варианты Transformer выбирают другие активации; ReLU здесь соответствует арифметическому примеру лекции.
Второе сложение завершает блок
Второй обходной путь передаёт \(\mathbf U\), поэтому выход блока равен
\[ \mathbf h_6^{(1)}=\mathbf u_6+\mathbf b_{\mathrm{mlp},6} \approx(-1.74,\;2.04,\;1.19,\;1.62,\;-0.195). \]
Для первой координаты \(h_{6,0}^{(1)}=u_{6,0}+B_{\mathrm{mlp},6,0}\approx-1.74\). Мы не добавляем нормализованную строку \(\mathbf r_6\) и не возвращаемся к исходной \(\mathbf h_6^{(0)}\) при втором сложении. У обоих операндов пять признаков, поэтому и внимание, и MLP возвращаются к ширине модели.
begins проходит через полный блок pre-norm и отдельную заключительную нормализацию стека. Каждое остаточное сложение складывает две строки с пятью признаками.
| Этап | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
| Вход H⁽⁰⁾ | -0.579 | 1.06 | 0.65 | 0.789 | 0.204 |
| LN₁: вход внимания | -1.75 | 1.11 | 0.393 | 0.635 | -0.385 |
| Ветвь внимания | -1.38 | 0.546 | 0.102 | 0.537 | -0.299 |
| Первая сумма U | -1.96 | 1.61 | 0.752 | 1.33 | -0.0954 |
| LN₂: вход MLP | -1.78 | 0.998 | 0.333 | 0.78 | -0.327 |
| Ветвь MLP | 0.224 | 0.431 | 0.436 | 0.292 | -0.1 |
| Выход блока H⁽¹⁾ | -1.74 | 2.04 | 1.19 | 1.62 | -0.195 |
| Заключительная LN (стек из одного блока) | -1.68 | 1.05 | 0.439 | 0.75 | -0.562 |
Посмотреть статистики нормализации и все семь строк на каждом этапе
| Позиция: токен | Среднее LN₁ | Дисперсия LN₁ | Среднее LN₂ | Дисперсия LN₂ |
|---|---|---|---|---|
0: a |
0.46 | 0.198 | 0.494 | 0.775 |
1: journey |
0.701 | 0.289 | 0.951 | 0.914 |
2: of |
0.289 | 0.157 | 0.71 | 0.71 |
3: a |
0.105 | 0.502 | 0.498 | 1.12 |
4: thousand |
0.0575 | 0.711 | 0.348 | 1.71 |
5: miles |
0.249 | 0.517 | 0.164 | 1.88 |
6: begins |
0.425 | 0.329 | 0.325 | 1.65 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-0.584 | 0.988 | -0.135 | 1.21 | -1.48 |
1: journey |
1.19 | 0.258 | -1.63 | 0.741 | -0.559 |
2: of |
1.31 | -1.27 | -0.601 | 1.03 | -0.473 |
3: a |
0.333 | -1.69 | 0.523 | 1.26 | -0.428 |
4: thousand |
-0.491 | -1.32 | 0.288 | 1.7 | -0.184 |
5: miles |
-1.54 | 0.743 | -0.589 | 1.31 | 0.0752 |
6: begins |
-1.75 | 1.11 | 0.393 | 0.635 | -0.385 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-0.817 | 0.315 | 0.131 | 0.686 | -0.144 |
1: journey |
0.347 | -0.107 | 0.022 | 1.28 | -0.295 |
2: of |
0.398 | 0.378 | 0.221 | 1.42 | -0.306 |
3: a |
0.0512 | 0.661 | 0.32 | 1.34 | -0.413 |
4: thousand |
-0.212 | 0.643 | 0.303 | 1.3 | -0.585 |
5: miles |
-1.18 | 0.454 | 0.0757 | 0.755 | -0.528 |
6: begins |
-1.38 | 0.546 | 0.102 | 0.537 | -0.299 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-0.617 | 1.21 | 0.531 | 1.69 | -0.344 |
1: journey |
1.69 | 0.733 | -0.153 | 2.38 | 0.106 |
2: of |
1.21 | 0.162 | 0.271 | 2.11 | -0.205 |
3: a |
0.392 | -0.429 | 0.796 | 2.34 | -0.611 |
4: thousand |
-0.569 | -0.411 | 0.603 | 2.8 | -0.683 |
5: miles |
-2.04 | 1.24 | -0.0991 | 1.95 | -0.225 |
6: begins |
-1.96 | 1.61 | 0.752 | 1.33 | -0.0954 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-1.26 | 0.818 | 0.0421 | 1.35 | -0.952 |
1: journey |
0.771 | -0.228 | -1.15 | 1.5 | -0.884 |
2: of |
0.59 | -0.651 | -0.521 | 1.67 | -1.09 |
3: a |
-0.0998 | -0.877 | 0.282 | 1.74 | -1.05 |
4: thousand |
-0.701 | -0.58 | 0.195 | 1.87 | -0.788 |
5: miles |
-1.61 | 0.782 | -0.192 | 1.3 | -0.283 |
6: begins |
-1.78 | 0.998 | 0.333 | 0.78 | -0.327 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
0.224 | 0.497 | 0.434 | 0.319 | -0.1 |
1: journey |
0.774 | -0.043 | 0.29 | 0.103 | 0.335 |
2: of |
0.618 | -0.05 | 0.421 | 0.1 | 0.185 |
3: a |
0.311 | -0.05 | 0.652 | 0.1 | -0.1 |
4: thousand |
0.306 | -0.05 | 0.641 | 0.1 | -0.1 |
5: miles |
0.172 | 0.312 | 0.304 | 0.245 | -0.1 |
6: begins |
0.224 | 0.431 | 0.436 | 0.292 | -0.1 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-0.393 | 1.71 | 0.966 | 2 | -0.444 |
1: journey |
2.46 | 0.69 | 0.137 | 2.48 | 0.44 |
2: of |
1.83 | 0.112 | 0.692 | 2.21 | -0.0194 |
3: a |
0.703 | -0.479 | 1.45 | 2.44 | -0.711 |
4: thousand |
-0.262 | -0.461 | 1.24 | 2.9 | -0.783 |
5: miles |
-1.87 | 1.55 | 0.205 | 2.19 | -0.325 |
6: begins |
-1.74 | 2.04 | 1.19 | 1.62 | -0.195 |
| Позиция: токен | Признак 0 | Признак 1 | Признак 2 | Признак 3 | Признак 4 |
|---|---|---|---|---|---|
0: a |
-1.13 | 0.918 | 0.192 | 1.2 | -1.18 |
1: journey |
1.2 | -0.542 | -1.08 | 1.22 | -0.787 |
2: of |
0.954 | -0.945 | -0.302 | 1.38 | -1.09 |
3: a |
0.0193 | -0.982 | 0.65 | 1.49 | -1.18 |
4: thousand |
-0.574 | -0.719 | 0.521 | 1.72 | -0.953 |
5: miles |
-1.55 | 0.838 | -0.102 | 1.29 | -0.472 |
6: begins |
-1.68 | 1.05 | 0.439 | 0.75 | -0.562 |
Соберите блоки по глубине, затем нормализуйте конечное представление
Следующий блок получает \(\mathbf H^{(1)}\) и выполняет ту же последовательность операций со своими параметрами. Стек меняет глубину, а не длину последовательности: каждый блок по-прежнему получает семь строк по пять признаков. Позиции одного блока используют общие отображения; разные блоки обычно обучают отдельные параметры внимания, MLP и нормализации.
Для \(N_{\mathrm{layers}}\) блоков выбранный pre-norm энкодер завершается отдельной нормализацией:
\[ \mathbf H_{\mathrm{enc}}=\operatorname{LN}_{\mathrm{final}}(\mathbf H^{(N_{\mathrm{layers}})}). \]
Численный разбор использует \(N_{\mathrm{layers}}=1\). При собственных конечных векторах масштаба/сдвига, равных единицам/нулям, и том же \(\epsilon\) конечная строка begins приблизительно равна \((-1.68,1.05,0.439,0.750,-0.562)\). Это другой этап, чем \(\mathbf h_6^{(1)}\): конечная нормализация принадлежит стеку, вне отдельного блока. Более глубокий стек нормализовал бы выход последнего блока. Предсказание задачи ещё не сделано.
Почему позиция всё ещё необходима
Внимание прочитало заданный префикс, но его проекции не содержат внутреннего правила порядка токенов. Для самовнимания без ограничений и без позиционной информации перестановка входных строк переставляет выходные строки тем же образом. Это эквивариантность к перестановкам (permutation equivariance): выход следует перестановке, а не кодирует, какой порядок был исходным.
Чтобы понять причину, пусть \(\Pi\) — матрица перестановки строк. LayerNorm и общий MLP действуют построчно, поэтому оба коммутируют с такой перестановкой. Проекции также переставляют Q/K/V; оценки запросов и ключей переставляются по обеим осям, а softmax по строкам следует той же перестановке источников:
\[ \mathbf A(\Pi\mathbf H)=\Pi\mathbf A(\mathbf H)\Pi^\top,\qquad \mathbf O(\Pi\mathbf H)=\Pi\mathbf O(\mathbf H). \]
Остаточные суммы сохраняют это свойство. Позиционные векторы устраняют неоднозначность порядка, задавая слову в другой позиции другое входное представление. Перестановка эмбеддингов токенов при закреплённых за позициями позиционных векторах меняет комбинации, входящие в блок. Если же лишь переставить уже позиционно закодированные строки вместе с прикреплёнными признаками позиции, выход тоже переставится; это другой эксперимент. Аргумент эквивариантности выше предполагает неограниченную видимость: фиксированная каузальная маска, привязанная к индексам позиций, в общем случае не сохраняется при произвольной перестановке.
Pre-norm, post-norm и обратный путь
Для одной преобразующей ветви \(\mathcal F\) два варианта расположения имеют вид
\[ \text{Pre-norm: }\quad \mathbf y=\mathbf h+\mathcal F(\operatorname{LN}(\mathbf h)), \]
\[ \text{Post-norm: }\quad \mathbf y=\operatorname{LN}(\mathbf h+\mathcal F(\mathbf h)). \]
Исходный Transformer использовал post-norm (Vaswani и др., §3.1); наша лекция и основной разбор используют pre-norm. Перенос нормализации меняет вычисление и его градиенты. Это не вопрос оформления, и одни параметры не дают одинаковых промежуточных чисел при двух схемах. Исследования положения нормализации связывают различие с поведением оптимизации (Xiong и др., 2020); ни одна схема не гарантирует успешного обучения во всех условиях.
Остаточный путь даёт прямой вклад в градиент. Развернём вход ветви в координаты и запишем \(y_j=h_j+f_j(\mathbf h)\), где \(f\) включает pre-norm ветвь. Если \(g_j=\partial\mathcal L/\partial y_j\), то
\[ \frac{\partial\mathcal L}{\partial h_i} =g_i+\sum_j g_j\frac{\partial f_j}{\partial h_i}. \]
Первый член возникает из тождественного обходного пути; сумма — из преобразующей ветви. Это ещё один пример сложения производных в местах встречи путей. Не каждый вклад обязан проходить все операции ветви. Её члены всё ещё могут компенсировать или усиливать другие члены, поэтому остаточные связи не гарантируют ограниченных или незатухающих градиентов. При post-norm даже вклад обхода проходит нормализацию после сложения; в нашем pre-norm стеке отдельный конечный LayerNorm также влияет на итоговый обратный сигнал.
Обучение следует циклу недели 04: голова задачи считывает представление энкодера, потери сравнивают предсказания с целевыми значениями, обратное распространение корректирует эмбеддинги, отображения внимания и MLP, масштабы и сдвиги нормализации. Градиент представления получает вклады от обхода и ветви; градиенты параметров общего отображения суммируют вклады всех позиций его использования. В середине блока параметры не обновляются. В следующем разделе выберем голову задачи и проверим, какой информацией могут пользоваться её предсказания.
Головы задач, границы информации и экспериментальные свидетельства
Энкодер возвращает признаки. Голова задачи (task head) превращает их в предсказания нужного приложению типа. Её входные строки, целевые значения и правила видимости должны быть согласованы: корректный softmax не исправит представление, уже содержащее информацию, недоступную в момент предсказания.
Выберите считывание для задачи
Пусть \(\mathbf h_{\mathrm{enc},t}\) — строка \(t\) конечного представления энкодера. Для классификации токенов на \(C\) классов общая аффинная голова создаёт логиты (logits)
\[ \mathbf s_t=\mathbf h_{\mathrm{enc},t}W_o^\top+\mathbf b_o, \qquad W_o\in\mathbb R^{C\times D}. \]
Логит — неограниченная оценка класса. Softmax по \(C\) классам даёт \(p_{t,c}=\exp(s_{t,c})/\sum_{r=0}^{C-1}\exp(s_{t,r})\). Это другой softmax, чем нормализация внимания по позициям-источникам. Для ID целевого класса \(y_t\) кросс-энтропия равна \(-\log p_{t,y_t}\); для численной устойчивости реализации обычно вычисляют её непосредственно по логитам.
Для одной метки на последовательность сначала объедините действительные строки в вектор. При \(m_t=1\) для реального входного токена и \(m_t=0\) для заполнения усредняющий пулинг с маской (masked mean pooling) даёт
\[ \overline{\mathbf h} =\frac{\sum_{t=0}^{T-1}m_t\mathbf h_{\mathrm{enc},t}}{\sum_{t=0}^{T-1}m_t}. \]
Знаменатель должен быть положительным. Голова классификации может считывать этот вектор. Отдельное представление токена класса (class token) — другой вариант пулинга; слово энкодер не подразумевает ни один из них. Регрессия использует голову нужной ширины непрерывного выхода и подходящие потери регрессии.
| Задача | Строки, считываемые головой | Предсказание и видимость |
|---|---|---|
| Разметка заданных слов | Каждая действительная строка | Распределение классов на слово; полный контекст предложения, если доступен при применении |
| Классификация записи | Объединённое представление | Одно распределение для последовательности; объединять только реальные наблюдения |
| Предсказание следующего токена | Последняя строка префикса или каждая каузально вычисленная обучающая строка | Распределение словаря на оцениваемую позицию; исключить ещё не наблюдённые будущие токены |
| Прогноз измерения | Представление наблюдаемого префикса | Непрерывный выход; будущее измерение — целевое значение, никогда не вход |
Заполнение меняет видимость и выбор выходов
Последовательности разной длины часто дополняют заполнением (padding) до прямоугольного пакета. Заполнение удобно для хранения, но не является ещё одним наблюдаемым словом. Даже нулевой эмбеддинг заполнения может стать ненулевым после добавления позиции или отображений со смещениями. Маскируйте заполненные позиции-источники в каждом слое внимания. На Рисунок 16 это ограничение источников отделено от исключения заполненных выходных строк.
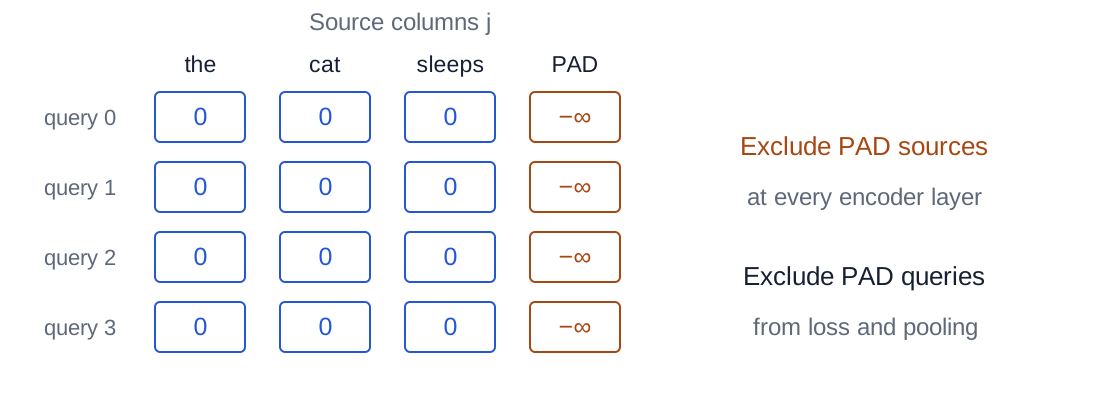
Для оцениваемого запроса в позиции \(t\) объедините заполнение и каузальное ограничение до softmax по строкам:
\[ M_{tj}=\begin{cases} 0,&m_j=1\text{ и задача разрешает источник }j,\\ -\infty,&\text{иначе}. \end{cases} \]
Энкодер без ограничений разрешает все реальные источники; каузальный стек дополнительно требует \(j\le t\). Для каждой вычисляемой строки softmax должен остаться хотя бы один доступный источник. Пустые последовательности и заполненные строки запросов без разрешённого источника требуют явной обработки вместо softmax из одних \(-\infty\). При правом заполнении и наличии хотя бы одного реального токена эта простая конструкция оставляет реальные источники доступными заполненным запросам.
Маска источников не удаляет выход заполненного запроса: он всё ещё может считывать реальные значения и создавать ненулевую строку. Такие строки отдельно исключаются из пулинга и потерь. Если \(v_t\) указывает действительное оцениваемое целевое значение, средние токенные потери равны
\[ \mathcal L=\frac{\sum_t v_t[-\log p_{t,y_t}]}{\sum_t v_t},\qquad \sum_t v_t>0. \]
Индикатор корректности цели \(v_t\) не обязан совпадать с индикатором действительного входа \(m_t\): у последнего реального токена может не быть цели следующего токена. Для пакета суммируйте числитель и знаменатель по примерам и позициям, чтобы получить среднее на действительное целевое значение. Сначала усреднить каждую последовательность, затем последовательности — значит задать другие веса при различающихся длинах. Не вычисляйте потери для недопустимого индекса цели до выбора действительных элементов; последующее обнуление веса потерь может оказаться запоздалым.
Соглашения о масках различаются между API. В nn.MultiheadAttention PyTorch значение True булевой маски исключает элемент; проверяйте документацию, не предполагая одинаковое правило у всех функций внимания (документация PyTorch 2.8).
Сдвиньте целевое значение на одну позицию вперёд
Вернёмся к пословице. У словарной головы теперь \(C=K=9\) выходных классов, а ширина контекстных признаков остаётся \(D=5\):
\[ \mathbf s_t=\mathbf h_{\mathrm{enc},t}W_o^\top+\mathbf b_o, \qquad W_o\in\mathbb R^{9\times5}. \]
Используя ID токенов \(k_t\) из раздела выборки токенов, получаем целевое значение следующего токена \(y_t=k_{t+1}\). Например:
| Входная позиция | Входной токен | Предсказываемый токен | Разрешённый вход до этой позиции включительно |
|---|---|---|---|
| 0 | a |
journey |
a |
| 1 | journey |
of |
a journey |
| 5 | miles |
begins |
a journey of a thousand miles |
| 6 | begins |
with |
a journey of a thousand miles begins |
Если пример содержит только семь токенов префикса без продолжения, первые шесть строк имеют цели следующего токена, а строка begins — нет. Если обучающая запись также содержит with, это значение может служить меткой последней строки префикса. Оно не должно входить во входы этого предсказания.
Чтобы обучать много предсказаний следующего токена по одной полной записи, используйте каузальное самовнимание в каждом блоке. Например, строка miles без ограничений могла бы считывать будущий вход begins, который является именно её целью. Каузальная маска только в последнем блоке не удалит информацию будущего, уже смешанную предыдущим блоком без ограничений. Построчная нормализация, MLP и остаточные пути сохраняют правильно установленную границу, но сами её не устанавливают.
Это стек каузального самовнимания для авторегрессионного предсказания. Наш разобранный энкодер использовал неограниченный контекст полностью заданного префикса. Те же блоки поддерживают оба варианта, но видимость и цели обучения различаются. Полная модель encoder–decoder добавила бы декодер и перекрёстное внимание (cross-attention) к выходам энкодера; эта архитектура выходит за рамки разбора энкодера в главе (Vaswani и др., §§3.1–3.2).
Вы обучаете строку miles предсказывать begins. Полная запись содержит оба слова. Первый блок использует внимание без ограничений, второй — каузальную маску. Защищено ли предсказание от информации будущего?
Показать объяснение
Нет. Первый блок может смешать begins в представление miles. Каузальная маска второго блока не удаляет эту зависимость из собственного входа. Ограничивайте видимость в каждом слое внимания и сохраняйте сдвиг целей следующего токена относительно входов.
Обучение по истинному префиксу — не цикл генерации
При обучении или оценке по истинному префиксу (teacher forcing) каждый префикс содержит записанные предыдущие токены, а каждая строка предсказывает следующий записанный токен. Целевые значения задают потери; они не становятся видимыми будущими входами оцениваемой строки. Все строки известной записи можно вычислять вместе под каузальной маской.
При генерации считайте распределение словаря из последней заданной строки, выберите токен по объявленному правилу, например argmax или случайной выборке (sampling), добавьте его к префиксу и предскажите снова. Так, гипотетический выбор with дал бы префикс из восьми токенов для следующего шага. Наши вручную выбранные параметры не демонстрируют ни такого выбора, ни успешного продолжения пословицы. В игрушечном словаре не задан токен EOS, поэтому учебному примеру нужна внешне выбранная длина генерации; система с EOS явно задаёт его ID и правило остановки.
Сгенерированные префиксы могут содержать ошибки, которых нет в записанных. Поэтому точность следующего токена на входах с teacher forcing и качество сгенерированной последовательности отвечают на разные вопросы. Каузальный стек может распараллелить позиции известной обучающей последовательности, но генерация неизвестных будущих токенов остаётся последовательной по шагам генерации.
Что устанавливает эксперимент практикума?
Практикум недели 06 использует небольшой язык команд робота вместо пословицы. Эпизод имеет вид BOS cue … RECALL cue EOS. Подсказка (cue) — одно из четырёх направлений движения; перед RECALL вставлены \(d\) независимых случайных команд движения. Предсказание движения после RECALL требует запомнить начальную подсказку. Здесь точность воспроизведения подсказки (cue-recall accuracy) — доля правильно выполненных таких запросов, а не обычная классификационная метрика полноты (recall).
Целевые случайные движения независимы от истории. Даже при идеальной памяти сохраняется неопределённость выбора из четырёх: равномерный предиктор движения имеет ожидаемую точность \(1/4\) и кросс-энтропию \(\log4\approx1.39\) нат. Оценка по всем токенам смешивает эту неопределённость с обучаемой зависимостью подсказки и детерминированной структурой эпизода, поэтому может скрывать, работает ли память.
Сохранённое сравнение использует 4,096 обучающих, 512 валидационных и 1,024 тестовых эпизода на задержку, с отдельными seed генерации эпизодов. Варианты RNN, GRU и одноблочного каузального Transformer обучаются 60 эпох на одинаковых эпизодах и порядках пакетов, с Adam при 0.003 и обрезкой градиента по норме один. Каждый запуск выбирает контрольную точку (checkpoint) по валидационной кросс-энтропии воспроизведения подсказки до оценки на тесте. Сохраняются три seed инициализации, 6206/6207/6208, вместо выбора удачного seed по тесту.
Эти обученные варианты отличаются от арифметики учебника: ширина эмбеддингов рекуррентных моделей 16, Transformer — 12; словарь содержит семь токенов робота, а Transformer использует обучаемые позиции. Скрытые ширины RNN/GRU — 32/17; у Transformer две головы ширины шесть и MLP ширины 24. Числа параметров близки (1,943/2,023/1,915), но это не уравнивает вычисления или ёмкость моделей (capacity).
| Модель | Задержка 8 | Задержка 16 | Задержка 32 |
|---|---|---|---|
| RNN | 1 ± 0 | 0.44 ± 0.126 | 0.257 ± 0 |
| GRU | 1 ± 0 | 0.814 ± 0.116 | 0.322 ± 0.102 |
| Transformer | 1 ± 0 | 1 ± 0 | 1 ± 0 |
При задержке 8 все три варианта достигают идеальной точности воспроизведения подсказки на этих тестовых эпизодах. При задержке 16 среднее RNN ниже половины, GRU — около четырёх пятых, а Transformer успешен для каждой сохранённой инициализации. При задержке 32 рекуррентные варианты испытывают трудности, а Transformer успешен на этой зависимости с фиксированной позицией. Малый разброс между seed может означать стабильно плохие результаты, как у RNN с задержкой 32. Разброс относится к инициализации на одном фиксированном наборе данных; это не доверительный интервал и не свидетельство о независимо выбранных наборах.
Результаты поддерживают это сравнение при его задаче, бюджете и правиле выбора checkpoint. Они не устанавливают универсального превосходства, экстраполяции на другие длины или успешной генерации языка. Каждая задержка обучается отдельно; позиция начальной подсказки фиксирована, и обученный Transformer может напрямую извлечь её. Для более полной интерпретации практикум сохраняет кросс-энтропии каждого seed, эталонные предикторы, измерения вычислительных затрат и вмешательства в подсказку. Его необязательное расширение прогнозирования также различает предсказание одного шага по наблюдаемым данным и поддержание развёрнутого прогноза (rollout). Для реальных временных рядов могут потребоваться хронологические разбиения и разделение пересекающихся окон вместо случайно разделённых эпизодов.
У короткого пути внимания есть вычислительная цена
RNN передаёт информацию между далёкими позициями через повторные переходы; полное внимание может связать любую разрешённую пару в одном слое. Короткий путь зависимости помогает информации достичь далёких строк, но не гарантирует успешного обучения и не делает любую реализацию быстрее.
Для одной головы сопоставление запросов и ключей требует порядка \(T^2d_k\) операций, смешивание значений — \(T^2d_v\). Явно материализованные массивы оценок и весов содержат \(T^2\) элементов на голову. Блочные реализации точного внимания, такие как FlashAttention, могут не хранить эти массивы целиком, хотя полное попарное внимание всё ещё выполняет квадратичную арифметику пар. Проекции и MLP добавляют работу; при стандартных ширинах голов их типичные затраты масштабируются как \(TD^2\) и \(TDF\). Это числа операций по размерам, а не измеренные прогнозы времени выполнения. Также важны размер пакета, число голов, глубина, оборудование и реализация (Vaswani и др., §4).
Изображения тоже могут задавать токены
Vision Transformer (ViT) заменяет выборку слов проекцией фрагментов изображения (patch projection). Для изображения высоты \(H_{\mathrm{img}}\), ширины \(W_{\mathrm{img}}\) с \(C_{\mathrm{img}}\) каналами неперекрывающиеся квадратные фрагменты со стороной \(p\) дают \(N_{\mathrm{patch}}=(H_{\mathrm{img}}/p)(W_{\mathrm{img}}/p)\) фрагментов, если размеры делятся на \(p\). Разверните каждый фрагмент в \(p^2C_{\mathrm{img}}\) чисел и спроецируйте в ширину модели \(D\).
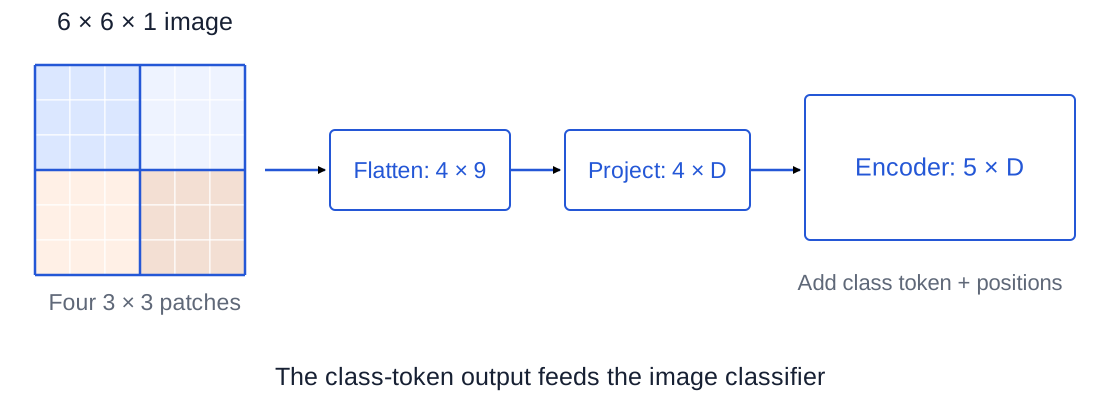
В примере Рисунок 17 четыре фрагмента по девять входных признаков; проекция в \(D=4\) даёт четыре строки признаков. Добавление обучаемого токена класса даёт \(T=5\) строк, а позиционные векторы задают пространственное расположение. Блоки энкодера контекстуализируют строки; классификатор считывает выход токена класса. Исходный ViT использует pre-norm энкодер, конечную нормализацию и GELU в MLP; наша небольшая арифметика использовала ReLU (Dosovitskiy и др. 2021 г.). Механизм связан с представлениями изображений недели 05, но заменяет локальное смешивание свёртками вниманием по токенам фрагментов. Выбор конструкции токенов меняет вход, но не отменяет необходимость головы задачи и оценки.
Обобщение, необязательные упражнения и дальнейшее чтение
Проследите информацию, затем обучающий сигнал
Рекуррентная модель обновляет состояние одной общей ячейкой. Обратное распространение следует развёрнутым зависимостям: локальные производные перемножаются вдоль пути, а вклады общих использований складываются. Длинные произведения объясняют, почему простым рекуррентным моделям трудно обучаться дальним зависимостям. Вентили вводят управляемые пути переноса и записи, а обрезка ограничивает большие градиенты, не восстанавливая затухшие.
Внимание строит контекстную строку, проецируя запросы, ключи и значения, сравнивая запросы с разрешёнными ключами источников, нормализуя оценки по источникам и вычисляя взвешенные суммы значений. Несколько голов сохраняют несколько таких смесей до возврата к ширине модели выходной проекцией. Энкодер объединяет эту операцию с построчной нормализацией, общим построчным MLP и двумя остаточными сложениями. Позиционная информация различает порядки; голова задачи даёт предсказания; маски и согласование целей обеспечивают границу информации.
Разбор также помещает методы в контекст. Исходный Transformer 2017 года объединял стеки энкодера и декодера на основе внимания для преобразования последовательностей (sequence transduction); глава сосредоточена на строительных блоках энкодера и различает их каузальный вариант. Позже Vision Transformer использовал энкодер для спроецированных фрагментов изображений вместо слов (Dosovitskiy и др. 2021 г.). Общая идея — обучение полезным промежуточным представлениям; архитектура определяет способы движения информации между их координатами и позициями.
Типичные заблуждения, которые стоит устранить
| Заблуждение | Что следует проверить |
|---|---|
| Скрытый признак уже является предсказанием. | Найдите голову задачи, целевое значение и потери. |
| У более длинной RNN на каждом шаге новые параметры ячейки. | Один общий параметр получает вклады градиента от всех использований. |
| Ненулевой градиент общего веса доказывает обучение дальним зависимостям. | Поздние использования могут давать градиент, пока ранние пути затухли. |
| Семь весов внимания означают семь выходных признаков. | Веса индексируют позиции-источники; взвешенные значения определяют ширину признаков. |
| Softmax внимания предсказывает следующее слово. | Он нормализует оценки источников; словарная голова нормализует логиты классов. |
| Головы делят предложение на части. | Каждая проецирует весь вход и использует свою смесь разрешённых источников. |
| LayerNorm смешивает слова или использует накопленные статистики пакета. | Здесь статистики берутся по признакам одной текущей строки. |
| Второй обходной путь возвращается к исходному входу. | Он передаёт U — представление после первого сложения. |
| Достаточно маскировать источники заполнения. | Также исключайте заполненные выходы из пулинга и недействительные цели из потерь. |
| Каузальная маска последнего слоя предотвращает всю утечку будущего. | Проверяйте видимость и во всех предыдущих слоях внимания. |
| Параллельное обучение означает параллельную генерацию неизвестных токенов. | Известная запись и сгенерированный префикс задают разные входы. |
| Игрушечная задача устанавливает рейтинг архитектур для всех данных. | Изучите задачу, разбиение, бюджет, правило выбора и протокол оценки. |
Необязательные упражнения
Упражнения требуют рассуждений за пределами разобранных примеров; ответы здесь не приведены.
- Измените позицию считывания. В скалярной RNN с тремя шагами и нулевыми смещениями замените потери только на конечном выходе на \(\mathcal L=\tfrac12(\widehat y_1-y_1)^2+\tfrac12(\widehat y_2-y_2)^2\), где \(\widehat y_t=w_oh_t\). Выведите два прямых вклада головы и полученное \(g_1^h\). Объясните, как меняется градиент общего \(w_o\).
- Разделите границы состояний и градиентов. Для скалярной RNN с тождественной активацией и \(w_h=-0.8\) вычислите \(\partial h_{s+5}/\partial h_s\) — множитель передачи чувствительности назад через пять переходов. Каковы его знак и модуль? Затем объясните, почему ограниченные состояния tanh сами по себе не определяют модуль градиента.
- Изучите маску до вычисления. У одного запроса три оценки \((0,\log2,\log3)\) и скалярные значения \((2,-1,4)\). Вычислите выход без ограничений. Обозначьте источники \(j=0,1,2\). Затем исключите \(j=2\) (третий источник), заново нормализуйте и вычислите выход с маской. Объясните, почему простое обнуление уже нормализованного веса даёт другой результат.
- Измените число голов. Используйте три головы с \(d_k=2\), \(d_v=4\), входной шириной \(D=5\) и семью позициями. Укажите размеры Q/K/V, каждой матрицы оценок, конкатенации, хранимой выходной проекции и её правого множителя. Является ли это стандартной конфигурацией равного разделения
nn.MultiheadAttention? - Найдите два обходных пути. Запишите выход pre-norm блока при тождественно нулевой ветви внимания. Затем обнулите и ветвь MLP. Обязательно ли отдельный конечный LayerNorm вернёт неизменное исходное представление? Сформулируйте различие между блоком и стеком.
- Проверьте оценку. Отчёт выбирает seed с лучшей тестовой точностью воспроизведения подсказки и включает заполненные строки запросов в пулинг вектора последовательности. Найдите две проблемы и предложите отдельные исправления. Укажите, какая дополнительная оценка нужна для утверждения обобщения на задержки, не использованные в обучении.
Дальнейшее чтение и исполняемые сопутствующие материалы
- Goodfellow, Bengio и Courville, Deep Learning, глава 10: рекуррентные вычисления и обучение на последовательностях.
- Pascanu, Mikolov и Bengio (2013): трудности рекуррентных градиентов и обрезка.
- Vaswani и др., Attention Is All You Need: исходный encoder–decoder Transformer, масштабированное внимание, несколько голов и позиционное кодирование. Его post-norm схема отличается от нашего основного pre-norm разбора.
- Xiong и др., On Layer Normalization in the Transformer Architecture: почему расположение нормализации важно для оптимизации.
- Dosovitskiy и др., An Image Is Worth 16x16 Words: связь с энкодером фрагментов изображения.
- Практикум недели 06: исполняемые расчёты рекурсии и внимания, вмешательства в подсказку робота, сравнение на отложенных данных и необязательная диагностика прогнозирования.
Небольшие таблицы расчётов главы устанавливают, как составляются операции. Эксперименты практикума проверяют, использует ли обученный вариант информацию, необходимую задаче. Различайте эти две формы свидетельств при чтении описания модели или проектировании сравнения.