Неделя 07 · Обучение по данным: правдоподобие, байесовский вывод и скрытые переменные
English · Русский
Рисунки, интерактивные схемы и их элементы управления сохранены в исходном виде, с английскими надписями. Текст главы и подписи к рисункам переведены; формулы и Python-код сохранены без изменений.
Датчик дождя может ошибаться, а повторные измерения могут различаться. Как наблюдения помогают разобраться в этих ошибках и улучшить предсказания? Для этого нужно различать зарегистрированный исход и модель исходов, которые могли бы наблюдаться.
В предыдущих главах для обучения использовались среднеквадратичная ошибка и перекрёстная энтропия. Почему именно эти функции потерь? Ответ даёт вероятностная модель: зададим возможные наблюдения и зависимость их вероятностей от модели, а затем найдём параметры, которые лучше всего объясняют данные. Возникает и следующий вопрос: какая неопределённость остаётся после подбора параметров?
В этой главе мы свяжем функции потерь, основанные на правдоподобии, с байесовским выводом о параметрах, а затем — с выводом о скрытом коде изображения. Каждая целевая функция будет следовать из модели наблюдений, априорного распределения или явно указанного приближения.
Результаты обучения:
- различать вероятностную массу, плотность, правдоподобие и апостериорную неопределённость;
- выводить функции потерь классификации и регрессии из заданных моделей наблюдений;
- объяснять, когда маргинальное правдоподобие можно считать константой и как гауссовское априорное распределение приводит к L2-штрафу;
- различать неопределённость параметров и шум наблюдений;
- объяснять роль dropout и вариационного автоэнкодера (VAE) в вероятностном выводе.
Предварительные знания и сопутствующие материалы. Предполагается знакомство с основами алгебры и циклом обучения из главы недели 04; в дальнейших выводах используются математический анализ и матричное умножение. Лекция недели 07 даёт визуальный обзор. В практическом занятии байесовская регрессия, dropout и небольшой VAE исследуются в исполняемых экспериментах.
Обозначения. Заглавные буквы, например \(R,S,X,Y\), обозначают случайные величины; строчные — их возможные или зарегистрированные значения. Запись \(p(y)\) используется для функции вероятностей или плотности; нужный смысл указывается рядом. Событие — это множество исходов. Вероятность события \(A\) обозначается \(P(A)\); для функции \(p\) мы уточняем, является ли она функцией вероятностей дискретной величины или плотностью.
| Обозначение | Значение в этой главе |
|---|---|
| \(R,S\); \(\rho\) | Бинарные переменные дождя и сигнала датчика; вероятность успеха в распределении Бернулли |
| \(\mu,\sigma^2\) | Среднее и дисперсия рассматриваемого распределения |
| \(\mathbb E\), \(\operatorname{Var}\) | Математическое ожидание и дисперсия; распределение усреднения указывается явно |
| \(\mathcal D=\{(x_i,y_i)\}_{i=1}^n\), \(\theta\) | Наблюдаемые пары «вход — целевое значение» (\(n\) примеров с индексом \(i\)) и параметры модели |
| \(\Lambda(\theta;\mathcal D)\) | Правдоподобие: наблюдения фиксированы, проверяемые параметры меняются |
| \(L_i\), \(L=\sum_i L_i\), \(\bar L=L/n\) | Потери для одного наблюдения, сумма и среднее |
Сохраняем принятые в курсе обозначения: \(\phi\) для активации и \(L\) для потерь; в предыдущих главах отдельные целевые функции также обозначались \(\mathcal L\). Запись \(p(y\mid x,\theta)\) явно указывает заданные параметры, но не предполагает, что они случайны. Апостериорное распределение параметров будет введено отдельно. «Шляпка» обозначает оценку или предсказание, черта сверху — среднее. Символы \(\sum\) и \(\prod\) означают сумму и произведение по указанному индексу. Логарифмы \(\ln\) — натуральные; \(\exp(a)=e^a\). Специальные обозначения и формы тензоров вводятся рядом с соответствующими расчётами. В частности, предсказанная вероятность и предсказанное вещественное среднее будут различаться по смыслу.
Вероятность описывает то, чего мы не знаем
Отведём на это повторение около 15 минут. Перейдём от частот к правилам вероятности, различим массу и плотность и научимся описывать распределение с помощью среднего и дисперсии (Bishop 2006 г., разд. 1.2–1.2.2).
Дождь и датчик: совместная, маргинальная и условная вероятности, правило Байеса
Представим устройство, которое подаёт сигнал о дожде. Иногда оно срабатывает в сухой день, а иногда пропускает дождь. Записывая сигнал вместе с фактической погодой, можно изучить эти ошибки: как часто датчик срабатывает при дожде и насколько его сигнал должен изменить наше представление о вероятности дождя?
Пусть \(R=1\) означает дождь, а \(S=1\) — сигнал; ноль означает сухую погоду или отсутствие сигнала. Для сопоставления с лекцией запишем \(Y=R\), \(X=S\). В следующей синтетической таблице оба значения относятся к одному дню.
|
Погода Y = R |
Нет сигнала X = S = 0 |
Сигнал X = S = 1 |
Итого по строке |
|---|---|---|---|
|
Сухо Y = 0 |
54\(n_{00}\) | 6\(n_{01}\) | 60\(r_0\) |
|
Дождь Y = 1 |
16\(n_{10}\) | 24\(n_{11}\) · дождь + сигнал | 40\(r_1\) |
| Итого по столбцу | 70\(c_0\) | 30\(c_1\) | 100\(N\) |
Маргинальное распределение погоды: \(p(y=0)=r_0/N=0.60\);
\(p(y=1)=r_1/N=0.40\).
Маргинальное распределение сигнала: \(p(x=0)=c_0/N=0.70\);
\(p(x=1)=c_1/N=0.30\).
Представим, что один из записанных дней выбирается равновероятно. Тогда доля — точная вероятность в этой конечной модели; для оценки вероятностей в генеральной совокупности по выборке нужны дополнительные предположения. Таблица не доказывает независимость дней и ничего не устанавливает о качестве реального прогноза.
Совместная вероятность задаёт оба исхода: \(p(y_i,x_j)=n_{ij}/N\). Суммирование ячеек исключает одну переменную: \(p(x_j)=\sum_i p(y_i,x_j)=c_j/N\). Это маргинализация, или правило суммы. Здесь индексы \(i,j\) обозначают категории таблицы; далее \(i\) будет нумеровать наблюдения в наборе данных.
Вертикальная черта в \(p(y_i\mid x_j)\) означает «при условии»: рассматриваем только дни со значением сигнала \(x_j\). Среди этих \(c_j\) дней погода \(y_i\) наблюдалась \(n_{ij}\) раз. Поэтому условная вероятность равна \(n_{ij}/c_j\), если \(c_j>0\). Умножим её на вероятность попасть в эту группу:
\[ \underbrace{p(y_i\mid x_j)}_{n_{ij}/c_j} \underbrace{p(x_j)}_{c_j/N} =\frac{n_{ij}}{N}=p(y_i,x_j). \]
Это сокращение объясняет правило произведения. Если вместо столбца ограничиться строкой погоды, получим \(p(x_j\mid y_i)=n_{ij}/r_i\). Приравняем два разложения одной совместной вероятности и разделим на положительное \(p(x_j)\):
\[ p(y_i\mid x_j)=\frac{p(x_j\mid y_i)p(y_i)}{p(x_j)}. \]
Правило Байеса обновляет информацию. До получения сигнала вероятность дождя равна \(0.4\) (априорная вероятность). Сигнал зарегистрирован; его вероятность при дожде составляет \(24/40=0.6\). Полная вероятность сигнала равна
\[ p(x=1)=0.6(0.4)+0.1(0.6)=0.3, \]
Здесь сложены варианты с дождём и без дождя. Обновлённая (апостериорная) вероятность дождя равна \(0.6(0.4)/0.3=0.8=24/30\). Знание сигнала меняет группу дней, по которой мы считаем долю. Обновление относится к доступной информации; события не обязательно происходят в таком порядке. «Сигнал при дожде» (\(0.6\)) и «дождь при сигнале» (\(0.8\)) отвечают на разные вопросы.
Для независимости требовалось бы \(p(x,y)=p(x)p(y)\) для каждой пары; здесь \(0.24\ne0.3(0.4)\). Несовместные события, в отличие от независимых, не могут произойти одновременно. Дождь и сигнал могут.
Масса и плотность вероятности описывают разные типы исходов
Функция вероятностей (probability mass function, PMF) присваивает каждому дискретному исходу вероятность \(p(y)\), причём \(p(y)\ge0\) и \(\sum_y p(y)=1\). Распределение Бернулли имеет исходы 0 и 1 с вероятностями \(1-\rho\) и \(\rho\). Категориальное распределение задаёт вероятности \(C\) взаимоисключающих классов; сумма компонент вектора вероятностей равна единице.
На Рисунок 1 они сопоставлены с непрерывным нормальным, или гауссовским, распределением. Его плотность вероятности (probability density function, PDF) с параметрами среднего \(\mu\), дисперсии \(\sigma^2>0\) и стандартного отклонения (SD) \(\sigma=\sqrt{\sigma^2}\) равна
\[ p(y)=\frac{1}{\sqrt{2\pi}\,\sigma} \exp\!\left[-\frac{(y-\mu)^2}{2\sigma^2}\right]. \]
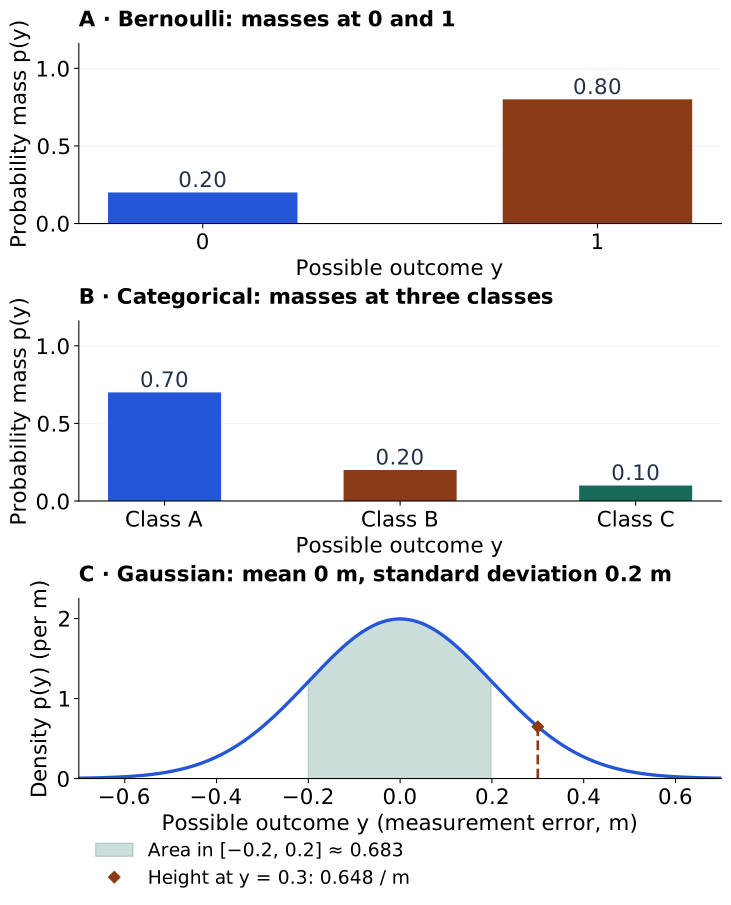
Также будем писать \(Y\sim\mathcal N(\mu,\sigma^2)\): \(\sim\) означает «имеет распределение», а \(\mathcal N\) — нормальное распределение с указанными средним и дисперсией. Интегралы без пределов берутся по всей области значений переменной. Плотность неотрицательна, её интеграл равен единице. Для границ интервала \(a\le b\) вероятность определяется площадью:
\[ \int p(y)\,dy=1,\qquad P(a\le Y\le b)=\int_a^b p(y)\,dy. \]
Пик гауссовской плотности составляет около \(1.995\) на метр; вероятность заштрихованного интервала равна \(0.683\). Плотность может превышать единицу, а её единицы измерения обратны единицам измеряемой величины. Вероятность отдельной точной точки в этой непрерывной модели равна нулю; округлённое измерение соответствует интервалу. Позднее сеть будет задавать параметры этих семейств для каждого входа.
Те же правила — теперь для плотностей. Для нормированной совместной модели
\[ p(x,y)=p(y\mid x)p(x)=p(x\mid y)p(y). \]
Правило Байеса даёт \(p(y\mid x)=p(x\mid y)p(y)/p(x)\) при положительном конечном \(p(x)\). Зафиксируем \(x\) и проинтегрируем по возможным \(y\). Поскольку условная плотность интегрируется в единицу,
\[ \begin{aligned} p(x)&=p(x)\underbrace{\int p(y\mid x)\,dy}_{1}\\ &=\int p(x\mid y)p(y)\,dy\\ &=\int p(x,y)\,dy. \end{aligned} \]
Знаменатель — совместная модель после исключения \(y\), непрерывный аналог суммирования ячеек таблицы. Для дискретной \(y\) используется сумма. Так маргинализация снова получается из той же нормированной совместной модели; условная плотность не является отношением вероятностей точечных событий, равных нулю.
Математическое ожидание и дисперсия описывают распределение
Для числового исхода \(Y\) математическое ожидание взвешивает возможные значения по их вероятности или плотности. Если первый момент существует,
\[ \begin{aligned} \mu=\mathbb E[Y]&=\sum_y y\,p(y) &&\text{(discrete)},\\ \mu=\mathbb E[Y]&=\int y\,p(y)\,dy &&\text{(continuous)}. \end{aligned} \]
При конечном втором моменте дисперсия усредняет квадраты отклонений:
\[ \begin{aligned} \operatorname{Var}(Y)&=\sum_y(y-\mu)^2p(y) &&\text{(discrete)},\\ \operatorname{Var}(Y)&=\int(y-\mu)^2p(y)\,dy &&\text{(continuous)}. \end{aligned} \]
Раскрывая квадрат, получаем \(\mathbb E[Y^2]-2\mu\mathbb E[Y]+\mu^2=\mathbb E[Y^2]-\mu^2\). Для исходов Бернулли \(\mathbb E[Y]=0(1-\rho)+1\rho=\rho\) и \(Y^2=Y\), поэтому \(\operatorname{Var}(Y)=\rho(1-\rho)\). Среднее \(0.8\) не обязано быть возможным наблюдением. Среднее произвольных числовых идентификаторов категорий не имеет содержательного смысла.
На гауссовской панели среднее равно \(0\) м, дисперсия — \(0.04\) м², а стандартное отклонение — \(\sqrt{\operatorname{Var}(Y)}=0.2\) м. Математическое ожидание модели усредняет возможные исходы; выборочное среднее \(n^{-1}\sum_i y_i\) усредняет зарегистрированные наблюдения.
Остановимся на минуту. Какие высоты на рисунке являются вероятностями? Для каких нужна площадь? Что должна выдавать сеть, чтобы задать каждое распределение? Далее зафиксируем наблюдения и будем менять параметры модели, чтобы определить правдоподобие.
От наблюдаемого набора данных к целевой функции обучения
Набор данных содержит наблюдения; вероятностная модель описывает, как они могли возникнуть. Подбор параметров связывает эти два объекта: какие параметры дают наблюдаемым данным наибольшее правдоподобие? (Bishop 2006 г., разд. 1.2.5).
Совместная вероятность предшествует предположению о независимости
Последовательно применяя правило произведения для двух переменных, получаем цепное правило вероятности для произвольных величин \(x_1,\ldots,x_n\):
\[ p(x_1,\ldots,x_n) =p(x_1)\prod_{k=2}^n p(x_k\mid x_1,\ldots,x_{k-1}). \]
Здесь \(x_k\) — произвольные величины; формула не предполагает независимости признаков. Применим то же правило к совместной вероятности или плотности \(n\) пар «вход — целевое значение»:
\[ \begin{aligned} p(x_{1:n},y_{1:n}\mid \theta) &=p(x_1,y_1\mid \theta)\\ &\quad\times\prod_{i=2}^n p(x_i,y_i\mid x_{1:i-1},y_{1:i-1},\theta). \end{aligned} \]
Здесь \(x_{1:n}=(x_1,\ldots,x_n)\); для целевых значений запись аналогична. Независимость пока не предполагалась. Если пары независимы, предыдущие пары можно удалить из каждого набора условий. Если они ещё и одинаково распределены, все пары описываются одним законом выборки. Это предположения iid — independent and identically distributed. Они дают
\[ \begin{aligned} p(x_{1:n},y_{1:n}\mid \theta) &=\prod_{i=1}^n p(x_i,y_i\mid \theta)\\ &=\prod_{i=1}^n p(y_i\mid x_i,\theta)p(x_i\mid \theta). \end{aligned} \]
Независимость относится к разным парам; она не делает вход независимым от собственного целевого значения. Повторные измерения одного объекта или соседние моменты времени могут нарушать это условие.
В обучении с учителем обычно сразу задают условную модель, фиксируя наблюдаемые входы. При указанной выше условной факторизации
\[ p(y_{1:n}\mid x_{1:n},\theta)=\prod_{i=1}^n p(y_i\mid x_i,\theta). \]
Для экспериментально заданных входов это также может быть предположением модели, не требующим описывать распределение входов. Общее правило не обязательно даёт одинаковые распределения целей при разных входах: ожидаемое показание датчика может зависеть от \(x_i\). Если начинать с совместной целевой функции, исключение множителя входов сохраняет оптимизацию лишь тогда, когда этот множитель не зависит от подбираемых параметров. Сам факт наблюдения входов этого не гарантирует.
Максимальное правдоподобие и его отрицательный логарифм
Определим правдоподобие: \(\Lambda(\theta;\mathcal D)=p(y_{1:n}\mid x_{1:n},\theta)\). Наблюдения фиксированы, а проверяемые параметры меняются. Правдоподобие оценивает объяснения этих данных; это не нормированное распределение вероятностей по \(\theta\).
Оценивание методом максимального правдоподобия (maximum likelihood estimation, MLE) выбирает параметры, максимизирующие правдоподобие. \(\arg\max\) возвращает наборы параметров, максимизирующие выражение, а \(\arg\min\) — минимизирующие. Символ \(\in\) означает «принадлежит множеству». При положительном правдоподобии логарифм строго возрастает, поэтому следующие цели выбирают одни и те же максимумы или минимумы:
\[ \begin{aligned} \widehat\theta_{\mathrm{MLE}} &\in\arg\max_\theta\Lambda(\theta;\mathcal D)\\ &=\arg\max_\theta\sum_{i=1}^n\ln p(y_i\mid x_i,\theta)\\ &=\arg\min_\theta\left[-\sum_{i=1}^n\ln p(y_i\mid x_i,\theta)\right]. \end{aligned} \]
Если оптимальных решений несколько, запись допускает любое из них. Логарифм превращает произведение в сумму, а знак минус — максимизацию в минимизацию. Этот отрицательный логарифм правдоподобия (negative log likelihood, NLL) равен \(L=\sum_i L_i\), где \(L_i=-\ln p(y_i\mid x_i,\theta)\). Непосредственное вычисление логарифмических оценок также позволяет избежать численного обнуления (underflow) при перемножении множества очень малых вероятностей. Среднее \(\bar L=L/n\) имеет те же минимизаторы без регуляризации, но градиенты делятся на \(n\). Оценки с натуральным логарифмом измеряются в натах.
Для отдельной синтетической упорядоченной последовательности \((1,0,0,1,0,0,0,1,0,0)\) предположим iid-наблюдения Бернулли с постоянной вероятностью дождя \(\rho\). Три дождливых и семь сухих исходов дают
\[ \Lambda(\rho)=\rho^3(1-\rho)^7,\qquad \frac{d\ln\Lambda}{d\rho}=\frac3\rho-\frac7{1-\rho}. \]
Приравнивая производную к нулю, получаем \(\widehat\rho=3/10\); логарифм правдоподобия строго вогнут на \((0,1)\), а само правдоподобие равно нулю на обоих концах. Эта последовательность отличается от предыдущей таблицы из 100 дней. Если наблюдается только число дождей, получается \(\binom{10}{3}\rho^3(1-\rho)^7\): биномиальный коэффициент \(\binom{10}{3}=120\) считает последовательности с тремя единицами. Этот не зависящий от параметра множитель не меняет MLE.
MLE — один из основных методов частотного оценивания. В этой интерпретации параметры — фиксированные неизвестные величины; оценки меняются между гипотетическими повторными наборами данных. Частотная статистика включает и другие оценки и процедуры описания неопределённости. Байесовский вывод тоже использует правдоподобие, но сочетает его с априорным распределением, к которому мы перейдём позднее.
Потери классификации следуют из дискретных моделей наблюдений
Вернёмся к дискретным панелям на Рисунок 1. Выберем семейство распределений; сеть задаст его параметры для каждого входа. Распределение описывает возможные целевые значения, а наблюдаемая метка выбирает вероятность, которую нужно оценить. Её отрицательный логарифм и даёт потери (Bishop 2006 г., разд. 2.1–2.2).
Бернулли: от двух случаев к бинарной перекрёстной энтропии
Для бинарной цели сеть с обучаемыми параметрами \(\theta\) преобразует вход \(x_i\) в скалярный логит \(z_i\). Сигмоида превращает этот логит в вероятность успеха распределения Бернулли:
\[ \widehat y_i=\operatorname{sigmoid}(z_i) =\frac{1}{1+e^{-z_i}} =P(y_i=1\mid x_i,\theta). \]
Здесь \(P(y_i=1\mid x_i,\theta)\) обозначает вероятность метки один для заданного входа и весов до рассмотрения зарегистрированной метки. Скаляр \(\widehat y_i\) задаёт обе вероятности: \(1-\widehat y_i\) и \(\widehat y_i\). Это параметр распределения; \(y_i\) — зарегистрированная метка. На Рисунок 2 проследите путь от выхода сети к распределению, а затем к оценке наблюдаемой метки.
Parameters θ determine the network logit zᵢ. The observed label yᵢ is not a network input. One scalar ŷᵢ specifies both bars.
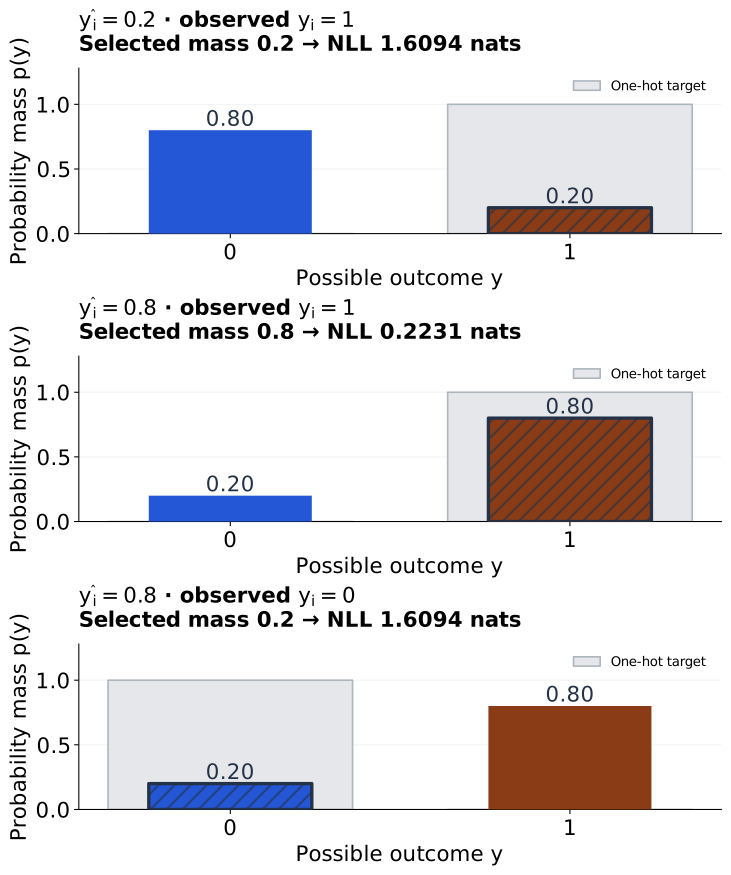
Pale gray: one-hot target (0, 1). Colored bars: model probabilities.
The sweep compares candidate predictions at a fixed input xᵢ; it is not a training trace. Changing yᵢ selects a different illustrative observation. Hatching and ▲ mark the selected outcome.
Reduced motion is enabled: use the slider or probability buttons to compare states.
Сначала запишем выбор как две инструкции: если \(y_i=1\), вернуть \(\widehat y_i\); если \(y_i=0\), вернуть \(1-\widehat y_i\). Кусочная функция вероятностей и запись с показателями степеней выражают те же инструкции:
\[ \begin{aligned} p(y_i\mid x_i,\theta) &=\begin{cases} \widehat y_i,&y_i=1,\\ 1-\widehat y_i,&y_i=0 \end{cases}\\ &=\widehat y_i^{\,y_i}(1-\widehat y_i)^{1-y_i}. \end{aligned} \]
Для метки один показатели \((1,0)\) выбирают \(\widehat y_i\); для метки ноль показатели \((0,1)\) выбирают \(1-\widehat y_i\). При условной независимости подставим эту функцию вероятностей в произведение по набору данных и возьмём отрицательный логарифм:
\[ \begin{aligned} \Lambda(\theta;\mathcal D) &=\prod_i\widehat y_i^{\,y_i}(1-\widehat y_i)^{1-y_i},\\ L_{\mathrm{BCE}}(\theta) &=-\sum_i\left[y_i\ln\widehat y_i +(1-y_i)\ln(1-\widehat y_i)\right]. \end{aligned} \]
Это сумма бинарной перекрёстной энтропии (binary cross-entropy, BCE); для среднего разделите на \(n\). При \(\widehat y_i=0.8\) метка один даёт \(0.2231\) ната, а метка ноль — \(1.6094\) ната. Вывод использует \(0<\widehat y_i<1\); потери на концах определяются пределами. Нулевая вероятность наблюдаемой метки даёт бесконечные потери; вероятность один даёт нулевые. Пороговое решение о классе — отдельная операция.
Категориальное распределение: от одного наблюдаемого класса к перекрёстной энтропии
Когда наблюдается ровно один из \(C\) классов, выходная голова выдаёт \(C\) логитов \(z_{i,c}\) для \(c=0,\ldots,C-1\). Их вектор обозначим \(z_i=(z_{i,0},\ldots,z_{i,C-1})\). Softmax преобразует его в вектор вероятностей; \(j\) в знаменателе — ещё один индекс класса, по которому выполняется суммирование:
\[ \widehat y_{i,c}=\frac{e^{z_{i,c}}}{\sum_{j=0}^{C-1}e^{z_{i,j}}}, \qquad \sum_c\widehat y_{i,c}=1. \]
На Рисунок 3 показан тот же путь для трёх вероятностей. Определим one-hot-цель: \(y^{\mathrm{one\text{-}hot}}_{i,c}=1\), если \(y_i=c\), и ноль иначе. Ровно одна компонента равна единице. Поэтому
\[ p(y_i\mid x_i,\theta) =\prod_c\widehat y_{i,c}^{\,y^{\mathrm{one\text{-}hot}}_{i,c}} =\widehat y_{i,y_i}. \]
Произведение выбирает одну вероятность; оно не утверждает независимость индикаторов взаимоисключающих классов. Перемножим вероятности по условно независимым примерам и возьмём отрицательные логарифмы:
\[ \begin{aligned} \Lambda(\theta;\mathcal D) &=\prod_i\prod_c\widehat y_{i,c}^{\,y^{\mathrm{one\text{-}hot}}_{i,c}},\\ L_{\mathrm{CE}} &=-\sum_i\sum_c y^{\mathrm{one\text{-}hot}}_{i,c}\ln\widehat y_{i,c}\\ &=-\sum_i\ln\widehat y_{i,y_i}. \end{aligned} \]
zᵢ,₁
zᵢ,₂
Three predictions and three observed one-hot values enter the observation model; the target is used for scoring, not fed into the network.
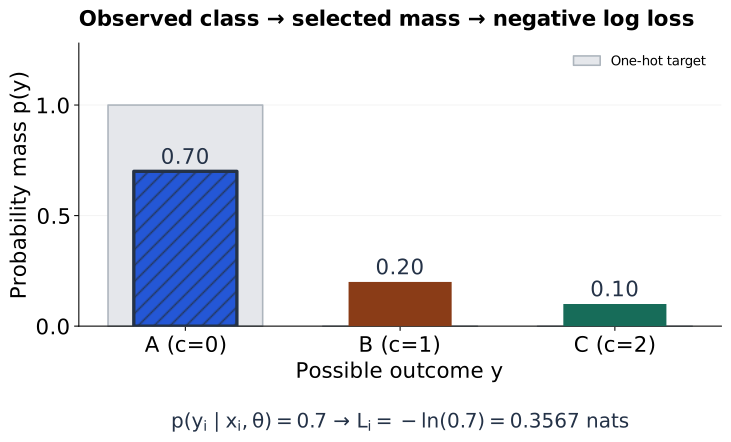
Для средней CE разделите на \(n\). Вероятности остальных классов входят в расчёт через нормировку Softmax. Если одновременно могут присутствовать несколько меток, нужны бинарные модели наблюдений, обычно по одному слагаемому Бернулли на метку.
Перекрёстная энтропия оценивает одно распределение с помощью другого: \(H(q,p)=-\sum_c q_c\ln p_c\). Здесь \(q\) — наблюдаемое one-hot-распределение, а \(p\) — предсказание; усреднение по наблюдениям даёт эмпирическую среднюю перекрёстную энтропию. BCE применяет то же определение к двум исходам.
Для численной устойчивости используйте объединённые функции потерь непосредственно на логитах (PyTorch contributors, б. д.-a, б. д.-b). В этом примере на CPU размер батча \(B=2\):
import torch
from torch.nn import functional as F

# Binary: logits and floating targets both have shape (B, 1).
z_binary = torch.tensor([[1.3862944], [1.3862944]])
y_binary = torch.tensor([[1.0], [0.0]])
bce = F.binary_cross_entropy_with_logits(
    z_binary, y_binary, reduction="mean"
)

# Categorical: logits (B, C); integer class indices (B,).
z_class = torch.tensor([[2.0, 0.0, -1.0], [0.0, 1.0, 2.0]])
y_class = torch.tensor([0, 2], dtype=torch.long)
ce = F.cross_entropy(z_class, y_class, reduction="mean")
assert bce.ndim == ce.ndim == 0
Бинарный логит приблизительно равен \(\ln4\), что даёт вероятность \(0.8\). Эти невзвешенные потери усредняют два примера. One-hot-запись объясняет алгебру; в коде категориального случая используются целочисленные метки. Не применяйте сигмоиду или Softmax перед объединёнными функциями потерь: они выполняют эти преобразования внутри. Гауссовская регрессия, к которой мы переходим далее, начинается с плотности и приводит к гауссовскому NLL или масштабированной квадратичной ошибке.
Потери регрессии следуют из гауссовских моделей наблюдений
Для вещественных целей сеть может выдавать среднее гауссовского распределения вместо вероятностей классов. Та же схема правдоподобия теперь даёт квадратичную ошибку — и объясняет, когда одной квадратичной ошибки недостаточно (Bishop 2006 г., разд. 1.2.5).
Условная плотность при одном входе
На практическом занятии показания генерируются по правилу \(y=0.3+2x+\epsilon\), где \(\epsilon\sim\mathcal N(0,0.25^2)\). В учебном эксперименте этот генератор известен; обучаемая модель должна оценить неизвестную функцию среднего \(\mu(x;\theta)\). Точка с запятой отделяет вход \(x\) от подбираемых параметров \(\theta\). Гауссовский закон шума — предположение модели, а не следствие большого числа наблюдений.
Голова среднего выдаёт вещественный выход сети \(z_i\) с тождественным выходным преобразованием: \(\widehat y_i=z_i=\mu(x_i;\theta)\). В отличие от логита классификации, этот выход непосредственно представляет среднее. Это ожидаемое показание, поэтому его смысл отличается от вероятности класса. При фиксированном стандартном отклонении \(\sigma\) он задаёт
\[ p(y\mid x_i,\theta)=\frac1{\sqrt{2\pi}\,\sigma} \exp\!\left[-\frac{(y-\widehat y_i)^2}{2\sigma^2}\right]. \]
Здесь \(y\) пробегает возможные показания; зарегистрированное \(y_i\) выбирает одну высоту плотности. На Рисунок 4 выберите наблюдение, затем измените кандидатное среднее. Левая панель фиксирует вход вертикальной направляющей; правая показывает возможные целевые значения вдоль этого среза, развёрнутые на горизонтальную ось. Обе панели относятся к одному наблюдению.
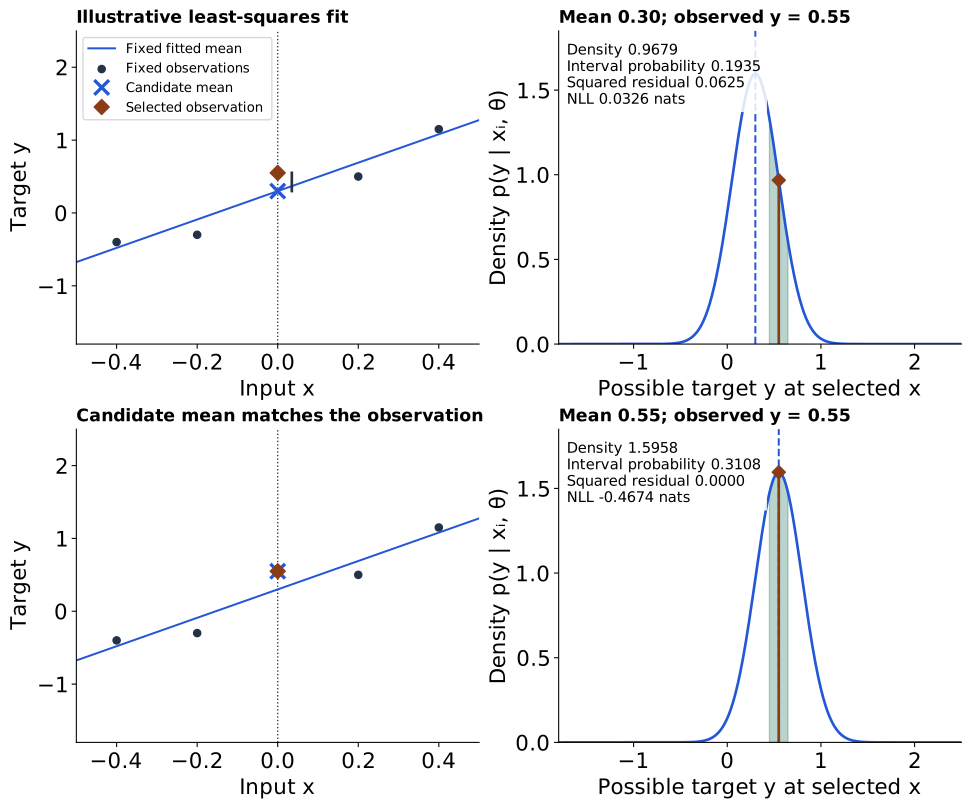
● fixed observations · ◆ selected yᵢ · × candidate mean · dashed blue: mean · green area: interval probability. The right panel displays the target values along the left panel’s vertical guide.
Choosing an observation resets the offset to the fitted mean. The mean sweep holds that observation and σ fixed. It compares local predictions; it is not a training trace or a new globally fitted curve. The isolated cross may move away from the fixed fitted line.
Reduced motion is enabled: use the slider and comparison buttons.
Изначально выбрана точка \((0,0.55)\); подобранное среднее равно \(0.30\), а \(\sigma=0.25\). Плотность составляет около \(0.9679\), вероятность показания в \([0.45,0.65]\) — около \(0.1935\). Сдвиг среднего к \(0.55\) увеличивает их до \(1.5958\) и \(0.3108\). Вероятность самой точки в этой непрерывной модели по-прежнему нулевая. В отличие от дискретной вероятности плотность может превышать единицу, поэтому гауссовский NLL может быть отрицательным. Его численное значение зависит от единиц измерения цели.
Для условно независимых наблюдений составим правдоподобие набора данных и возьмём его отрицательный логарифм:
\[ \Lambda(\theta;\mathcal D)=\prod_i p(y_i\mid x_i,\theta), \qquad L=-\ln\Lambda=\sum_i L_i. \]
Запишем \(\sigma_i^2\), чтобы допустить свою дисперсию для каждого входа. Нормирующий множитель и экспонента гауссовской плотности дают
\[ \begin{aligned} L_i&=-\ln p(y_i\mid x_i,\theta)\\ &=\frac{(y_i-\widehat y_i)^2}{2\sigma_i^2} +\frac12\ln\sigma_i^2+\frac12\ln(2\pi). \end{aligned} \]
Квадратичное слагаемое непосредственно возникает из показателя гауссовской экспоненты. Логарифм дисперсии возникает из нормировки; это часть той же модели наблюдений.
Общая дисперсия даёт масштабированную квадратичную ошибку
Гомоскедастичность означает, что дисперсия наблюдений одинакова при всех входах: \(\sigma_i^2=\sigma^2\). Если при подборе среднего эта общая дисперсия фиксирована, усреднение даёт
\[ \begin{aligned} \operatorname{MSE}&=\frac1n\sum_i(y_i-\widehat y_i)^2,\\ \bar L&=\frac{\operatorname{MSE}}{2\sigma^2} +\frac12\ln\sigma^2+\frac12\ln(2\pi). \end{aligned} \]
Последние два слагаемых постоянны по \(\theta\), а \(1/(2\sigma^2)>0\). Поэтому минимизация среднего NLL даёт то же подобранное среднее, что и минимизация MSE, хотя значения целевых функций и масштабы градиентов различаются. Фиксированные неодинаковые дисперсии вместо этого дают взвешенную квадратичную ошибку с весом \(1/\sigma_i^2\).
Общая дисперсия не обязательно известна. Если она обучается, нужно сохранить логарифмическое слагаемое. При фиксированных подобранных средних и положительной MSE дифференцирование среднего NLL по \(v=\sigma^2\) даёт
\[ \frac{\partial\bar L}{\partial v} =-\frac{\operatorname{MSE}}{2v^2}+\frac1{2v}=0 \quad\Longrightarrow\quad \widehat{\sigma^2}_{\mathrm{MLE}}=\operatorname{MSE}. \]
Это оценка по правдоподобию, а не оценка остаточной дисперсии с поправкой на число степеней свободы. Если все остатки нулевые, никакая положительная неограниченная дисперсия не максимизирует правдоподобие: оно неограниченно растёт при стремлении дисперсии к нулю.
Зависимая от входа дисперсия даёт гетероскедастическую функцию потерь
Гетероскедастичность означает, что дисперсия наблюдений зависит от входа. Добавим выходную голову дисперсии рядом с головой среднего. Две головы предсказывают среднее и логарифм дисперсии:
\[ x_i\longrightarrow\text{network} \longrightarrow \begin{cases} \widehat y_i=\mu(x_i;\theta),\\ s_i=s(x_i;\theta),\quad \sigma_i^2=e^{s_i}>0. \end{cases} \]
Оба выхода — параметры распределения; ни один не является случайно выбранной целью. Подставляя их в гауссовский NLL, получаем
\[ L_i=\frac12\left[e^{-s_i}(y_i-\widehat y_i)^2+s_i+\ln(2\pi)\right]. \]
Увеличение дисперсии уменьшает вес остатка, но повышает стоимость логарифма дисперсии. Без \(s_i\) модель могла бы уменьшать потери простым раздуванием дисперсии. При фиксированном среднем
\[ \frac{\partial L_i}{\partial s_i} =\frac12\left[1-e^{-s_i}(y_i-\widehat y_i)^2\right]. \]
Для ненулевого остатка равновесие достигается при дисперсии, равной его квадрату; общая сеть обычно не может независимо выбирать дисперсию каждого примера. При точном совпадении неограниченная дисперсия может схлопнуться. Положительная нижняя граница предотвращает такое вырождение: например, можно использовать \(\sigma_i^2=\sigma_{\min}^2+\operatorname{softplus}(v_i)\) и считать NLL с этой фактической дисперсией. Здесь \(\sigma_{\min}>0\) — выбранное минимальное стандартное отклонение, \(\operatorname{softplus}(v)=\ln(1+e^v)\), а \(v_i\) — неограниченный выход головы, а не логарифм дисперсии.
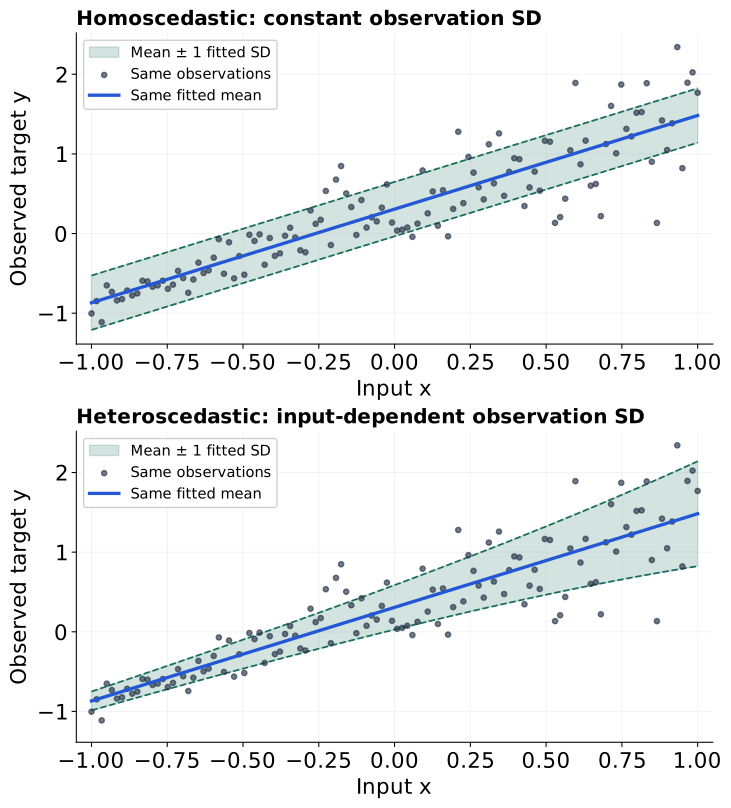
На Рисунок 5 это различие видно для данных с растущим шумом. Чтобы выделить разброс, на обеих панелях сохраняется одно среднее по методу наименьших квадратов: минимизация гауссовского NLL подбирает общую SD на верхней панели и линейный по \(x\) логарифм дисперсии на нижней. Полоса переменной ширины лучше описывает меняющийся разброс этого набора данных; это не обязательно улучшает кривую среднего или MSE. В сети дополнительная голова дисперсии обучается отображать вход в разброс, обычно совместно с головой среднего. Предсказанный разброс описывает шум наблюдений при условии подобранных весов; сам по себе он не представляет неопределённость этих весов. В коде массивы целей, средних и дисперсий для каждого входа должны иметь одинаковую форму, например \((B,1)\), чтобы избежать непреднамеренного broadcasting. Суммируйте слагаемые по наблюдениям либо явно укажите усреднение.
Теперь путь от модели наблюдений к потерям одинаков во всех трёх случаях:
| Возможные целевые значения | Выход модели | NLL одного наблюдения |
|---|---|---|
| Бинарные \(\{0,1\}\) | Вероятность сигмоиды \(\widehat y_i\) | BCE |
| Один из \(C\) классов | Вектор Softmax \(\widehat y_{i,c}\) | Категориальная CE |
| Вещественные | Среднее; фиксированная общая дисперсия | Масштабированная квадратичная ошибка + константа |
| Вещественные | Среднее и зависимая от входа дисперсия | Гауссовский NLL с логарифмом дисперсии |
Остаётся выбрать, что сохранять после обучения: один набор весов или распределение правдоподобных весов. Это приводит к байесовскому обучению.
Байесовское обучение обновляет распределение неизвестных величин
Одни данные могут поддерживать несколько правдоподобных наборов параметров. Байесовское обучение представляет эту неопределённость распределением параметров и обновляет его с помощью правдоподобия. Точечная оценка всё ещё может быть полезна; решение сохранить только её — отдельный выбор (Bishop 2006 г., разд. 1.2.3–1.2.6).
Априорное распределение, правдоподобие, апостериорное распределение и маргинальное правдоподобие
Зафиксируем наблюдаемые входы \(X=(x_1,\ldots,x_n)\) и цели \(\mathbf y=(y_1,\ldots,y_n)\). Выберем условную модель и собственное априорное распределение \(p(\theta)\): нормированное распределение, выражающее предположения о параметрах до использования этих целей. Правдоподобие \(p(\mathbf y\mid X,\theta)\) — то же самое, что использовалось для BCE, CE или гауссовской регрессии. Правило Байеса даёт
\[ \underbrace{p(\theta\mid\mathcal D)}_{\text{posterior}} =\frac{\overbrace{p(\mathbf y\mid X,\theta)}^{\text{likelihood}} \overbrace{p(\theta)}^{\text{prior}}} {\underbrace{p(\mathbf y\mid X)}_{\text{evidence}}}. \]
Маргинальное правдоподобие (evidence) суммирует правдоподобие данных по всем наборам параметров, взвешивая их априорной плотностью:
\[ p(\mathbf y\mid X) =\int p(\mathbf y\mid X,\vartheta)p(\vartheta)\,d\vartheta. \]
Здесь \(\vartheta\) — вспомогательная переменная интегрирования для всего вектора параметров. Предполагаем, что evidence положительно и конечно. Деление на него нормирует апостериорное распределение. Последнее может сохранять разброс или несколько мод; выборка из него исследует правдоподобные наборы параметров. Градиентные обновления, напротив, перемещают один подбираемый набор. Мы не обязаны считать, что физическая система заново выбирает веса для каждого измерения.
Когда маргинальное правдоподобие является константой?
Константа означает независимость от переменной, которую сейчас меняют. При фиксированных данных, модели и настройках априорного распределения интеграл evidence уже исключил проверяемое \(\theta\). Следовательно,
\[ p(\theta\mid\mathcal D)\propto p(\mathbf y\mid X,\theta)p(\theta). \]
Символ \(\propto\) означает «пропорционально» с общим нормирующим множителем. Это следствие модели, а не предположение о равной вероятности всех наблюдений. Фиксация наблюдений не устраняет зависимость правдоподобия от параметров.
Следующие различия встретятся снова. Последние две строки предваряют VAE: \(x\) — наблюдаемое изображение, \(u\) — его скрытый код, а \(\theta\) — веса декодера.
| Выражение и операция | Можно исключить? | Причина |
|---|---|---|
| Evidence \(p(\mathbf y\mid X)\) при оптимизации апостериорного распределения по \(\theta\) | Да, для argmax | Модель и априорное распределение фиксированы; нет зависимости от проверяемого \(\theta\) |
| То же evidence для нормированных апостериорных вероятностей или сравнения моделей/априорных настроек | Как правило, нет | Нормировка требует его; при смене модели или априорных настроек оно может меняться |
| Множитель входов \(p(X\mid \theta)\) при переходе от совместного обучения к условному | Только при независимости от параметров; либо условная цель задаётся сразу | Наблюдаемые входы сами по себе не делают множитель константой |
| Evidence изображения \(p(x\mid \theta)\) при выводе \(u\) с фиксированным декодером | Постоянно по \(u\) | Все кандидатные коды имеют общий нормировочный множитель |
| Evidence изображения \(p(x\mid \theta)\) при обучении декодера \(\theta\) | Нет | Зависит от декодера; это маргинальное правдоподобие |
Аналогично в байесовской классификации evidence фиксированного входа общее для всех рассматриваемых классов, но для нормированных вероятностей классов оно всё равно нужно. Исключение нормирующего множителя из оптимизации не решает задачи интегрирования, необходимые для сохранения и использования апостериорного распределения.
MAP и гауссовское априорное распределение дают L2-штраф
Максимальная апостериорная оценка (maximum a posteriori, MAP) выбирает моду апостериорного распределения. Взяв отрицательные логарифмы правила Байеса, получаем
\[ \begin{aligned} -\ln p(\theta\mid\mathcal D) &=\sum_i L_i(\theta)-\ln p(\theta)\\ &\quad+\ln p(\mathbf y\mid X). \end{aligned} \]
Evidence постоянно по проверяемым весам, поэтому MAP минимизирует NLL данных плюс отрицательный логарифм априорной плотности. Пусть \(d\) — число координат весов, а \(\tau\) — их априорное стандартное отклонение. Для \(d\) независимых координат \(\theta_j\sim\mathcal N(0,\tau^2)\), \(j=1,\ldots,d\), с фиксированным \(\tau>0\) запишем \(\|\theta\|_2^2=\sum_j\theta_j^2\) для квадрата евклидовой нормы. Тогда
\[ \begin{aligned} p(\theta)&=(2\pi\tau^2)^{-d/2} \exp\!\left[-\frac{\|\theta\|_2^2}{2\tau^2}\right],\\ -\ln p(\theta)&=\frac{\|\theta\|_2^2}{2\tau^2} +\frac d2\ln(2\pi\tau^2). \end{aligned} \]
Последнее слагаемое постоянно по весам, но стало бы существенным при изменении \(\tau\). Таким образом, знакомый штраф за квадрат L2-нормы возникает из гауссовского априорного распределения:
\[ \boxed{\quad\text{likelihood}\times\text{prior} \ \xrightarrow{-\ln}\ \sum_i L_i+\frac{\|\theta\|_2^2}{2\tau^2}\quad} \]
На Рисунок 6 показан конкретный пример. Три наблюдения \(y=(1,2,3)\) имеют общий скалярный параметр среднего: \(y_i\mid\theta\sim\mathcal N(\theta,1)\). MLE равно их среднему, \(2\). Приравняем к нулю производную суммы NLL данных и априорного штрафа:
\[ \begin{aligned} 0&=(n+1/\tau^2)\theta-\sum_i y_i,\\ \widehat\theta_{\mathrm{MAP}} &=\frac{\sum_i y_i}{n+1/\tau^2}. \end{aligned} \]
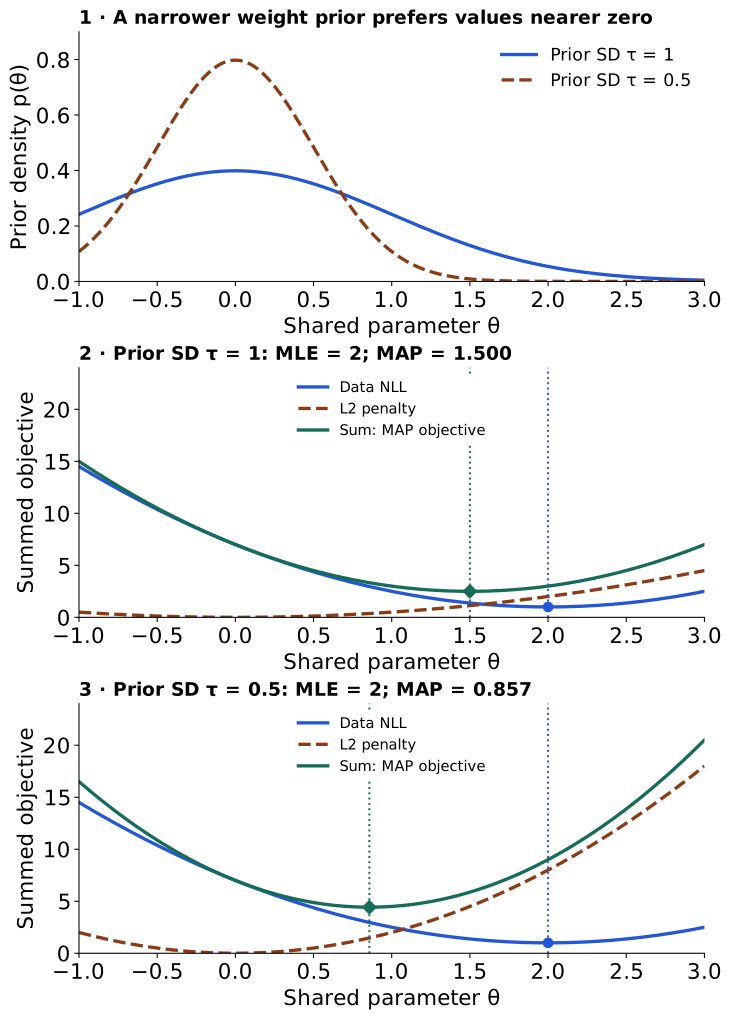
Это априорное распределение действует на общий параметр; \(\tau^2\) отличается от дисперсии шума наблюдений \(\sigma^2\). MAP сохраняет один набор параметров, а не апостериорный разброс; мода не обязана совпадать с апостериорным средним.
Способ агрегирования меняет коэффициент. Деление всей MAP-цели на \(n\) либо её масштабирование с использованием гауссовской связи при фиксированной дисперсии из Общая дисперсия даёт масштабированную квадратичную ошибку сохраняет оптимальное решение:
| Соглашение о потерях данных | Штраф, дающий тот же MAP-результат |
|---|---|
| Сумма NLL \(\sum_i L_i\) | \(\|\theta\|_2^2/(2\tau^2)\) |
| Среднее NLL \(\bar L\) | \(\|\theta\|_2^2/(2n\tau^2)\) |
| MSE без множителя \(1/2\) | \(\sigma^2\|\theta\|_2^2/(n\tau^2)\) |
Строка MSE предполагает фиксированную общую \(\sigma^2\). Тот же априорный штраф можно добавить к BCE и CE, учитывая их соглашение о NLL. Явно укажите, какие параметры имеют это априорное распределение, в том числе штрафуются ли смещения.
Этот пример на CPU включает в \(\theta=(b,w)\) и свободный член, и наклон и использует единичную дисперсию наблюдений. Опущенная гауссовская нормировка постоянна по этим весам:
import torch

x = torch.tensor([[-1.0], [0.0], [1.0]])
y = torch.tensor([[1.0], [2.0], [3.0]])
theta = torch.tensor([0.2, 0.4], requires_grad=True)  # b, w
prediction = theta[0] + theta[1] * x               # (B, 1)
n_train, tau = len(y), 0.5
mean_nll = 0.5 * (y - prediction).square().mean()
l2 = theta.square().sum() / (2 * n_train * tau**2)
loss = mean_nll + l2
loss.backward()
assert torch.isfinite(loss) and torch.isfinite(theta.grad).all()
Для мини-батчевых оценок этой усреднённой цели n_train остаётся размером всей обучающей выборки, а не размером батча \(B\). Такой явный штраф в функции потерь в общем случае не эквивалентен отделённому weight decay в AdamW (Loshchilov и Hutter 2019 г.). Далее сравним точечную оценку с сохранением апостериорного распределения и предсказанием по нему.
Точное обновление вероятности бинарного исхода
Вернёмся к отдельной последовательности из десяти событий в Максимальное правдоподобие и его отрицательный логарифм: три дождливых и семь сухих исходов. Здесь \(\mathcal D\) обозначает эти десять исходов. Предположим независимые исходы Бернулли с одной постоянной неизвестной частотой дождя \(\rho\). Это синтетическая модель, а не утверждение, что реальная погода независима по дням.
Зададим неизвестной вероятности бета-априорное распределение. Его положительные параметры формы \(\alpha\) и \(\beta\) определяют плотность на \(0<\rho<1\):
\[ p(\rho)\propto\rho^{\alpha-1}(1-\rho)^{\beta-1}. \]
Выберем \(\alpha=2\), \(\beta=3\), что даёт априорное среднее \(2/(2+3)=0.4\). Умножение на правдоподобие упорядоченной последовательности даёт
\[ \begin{aligned} p(\rho\mid\mathcal D) &\propto\underbrace{\rho^3(1-\rho)^7}_{\text{likelihood}} \underbrace{\rho^{2-1}(1-\rho)^{3-1}}_{\text{prior}}\\ &=\rho^{5-1}(1-\rho)^{10-1}. \end{aligned} \]
Это ядро \(\operatorname{Beta}(5,10)\); нормировка определяет полное апостериорное распределение. Мы выбрали семейство априорных распределений, которое после обновления остаётся в том же семействе, — сопряжённое априорное распределение (Bishop 2006 г., разд. 2.1.1). Сравним три характеристики:
| Характеристика | Значение | Что она сохраняет |
|---|---|---|
| MLE | \(3/10=0.3\) | Максимум правдоподобия |
| Внутренняя мода апостериорного распределения, MAP | \((5-1)/(5+10-2)=4/13\) | Максимум апостериорной плотности |
| Апостериорное среднее | \(5/(5+10)=1/3\) | Среднее по апостериорному распределению |
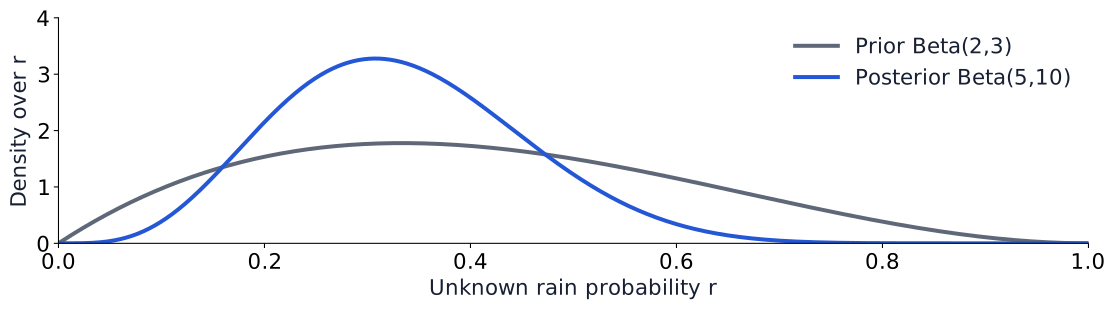
Сохраняя всю кривую на Рисунок 7, можно усреднять предсказание по правдоподобным частотам. Обозначим через \(Y_*\) исход одного нового события Бернулли. Нижний индекс \(*\) означает новое или будущее наблюдение, а не один из обучающих примеров; это метка, а не умножение. То же соглашение применяется к \(x_*\), \(y_*\) и другим величинам при новом входе. Тогда
\[ \begin{aligned} P(Y_*=1\mid\mathcal D) &=\int_0^1\rho\,p(\rho\mid\mathcal D)\,d\rho\\ &=\mathbb E[\rho\mid\mathcal D]=\frac13. \end{aligned} \]
Среднее возникает из этого предсказательного интеграла, а не из выбора наиболее вероятного параметра. Апостериорная плотность неизвестной вероятности и предсказательная вероятность дождя отвечают на разные вопросы.
Байесовская регрессия: неопределённость весов и будущих измерений
У прямой две неизвестные вместо одной частоты дождя. Возьмём \(n=20\) синтетических наблюдений из практического занятия, известную SD шума \(\sigma=0.25\) и априорную SD \(\tau=1.5\). Пусть \(\theta=(b,w)^\top\) содержит свободный член \(b\) и наклон \(w\); верхний индекс \(\top\) транспонирует строку в столбец и наоборот. Для расчёта составим матрицу плана \(X\) со строками \([1,x_i]\): форма \(X\) равна \((n,2)\), \(\theta\) — \((2,1)\), столбца целей \(\mathbf y\) — \((n,1)\). В ноутбуке векторы представлены одномерными массивами NumPy.
Обозначим через \(I_k\) единичную матрицу \(k\times k\) с единицами на диагонали и нулями вне неё. Предположим
\[ \theta\sim\mathcal N(0,\tau^2I_2),\qquad \mathbf y\mid X,\theta\sim\mathcal N(X\theta,\sigma^2I_n). \]
Априорное распределение задаётся и свободному члену, и наклону. Перемножение даёт апостериорное распределение, пропорциональное
\[ \exp\!\left[-\frac12\left( \frac{\|\mathbf y-X\theta\|_2^2}{\sigma^2} +\frac{\theta^\top\theta}{\tau^2}\right)\right]. \]
Раскроем квадрат остатка:
\[ \begin{aligned} \|\mathbf y-X\theta\|_2^2 &=\mathbf y^\top\mathbf y-2\theta^\top X^\top\mathbf y\\ &\quad+\theta^\top X^\top X\theta. \end{aligned} \]
Собрав слагаемые, определим матрицу точности \(A\) формы \((2,2)\) и столбец \(m\) формы \((2,1)\) следующей линейной системой. Отрицательная степень скаляра означает обратную величину, например \(\sigma^{-2}=1/\sigma^2\):
\[ A=\tau^{-2}I_2+\sigma^{-2}X^\top X, \qquad Am=\sigma^{-2}X^\top\mathbf y. \]
Выделение полного квадрата преобразует зависящее от параметров выражение в
\[ \begin{aligned} \theta^\top A\theta-2\theta^\top Am &=(\theta-m)^\top A(\theta-m)-m^\top Am. \end{aligned} \]
Последнее слагаемое постоянно по \(\theta\). Обозначим апостериорную ковариационную матрицу через \(S_\theta=A^{-1}\); \(A^{-1}\) означает обратную матрицу. Здесь \(\mathcal N(\theta;m,S_\theta)\) — гауссовская плотность в точке \(\theta\) со средним \(m\) и ковариационной матрицей \(S_\theta\). Узнав нормированную гауссовскую форму, получаем
\[ \begin{aligned} p(\theta\mid\mathcal D)&=\mathcal N(\theta;m,S_\theta),\\ S_\theta&=A^{-1},\qquad m=S_\theta\sigma^{-2}X^\top\mathbf y. \end{aligned} \]
\(S_\theta\) — апостериорная ковариационная матрица: диагональные элементы описывают неопределённость свободного члена и наклона; внедиагональные — их совместную изменчивость. Матрица точности обратна ковариационной. В этой модели априорная точность и точность данных складываются. Собственное гауссовское априорное распределение делает \(A\) положительно определённой. Среднее этого апостериорного распределения совпадает с модой, поэтому \(m\) также даёт решение ridge/MAP. Сохранив только \(m\), мы теряем \(S_\theta\) (Bishop 2006 г., разд. 3.3).
Для нового входа \(x_*\) пусть \(y_*\) — будущее зашумлённое целевое значение. Определим вектор-строку \(a_*=[1,x_*]\) и функцию среднего \(f_*=a_*\theta\). Тогда
\[ \mathbb E[y_*\mid x_*,\mathcal D]=a_*m, \]
\[ \operatorname{Var}(y_*\mid x_*,\mathcal D) =\underbrace{a_*S_\theta a_*^\top}_{\text{uncertainty in the mean}} +\underbrace{\sigma^2}_{\text{observation noise}}. \]
Это формула полной дисперсии: усредним условную дисперсию шума, затем добавим дисперсию условного среднего. Один набор весов из апостериорного распределения задаёт целую правдоподобную прямую; будущее зашумлённое показание добавляет ещё один источник вариации.
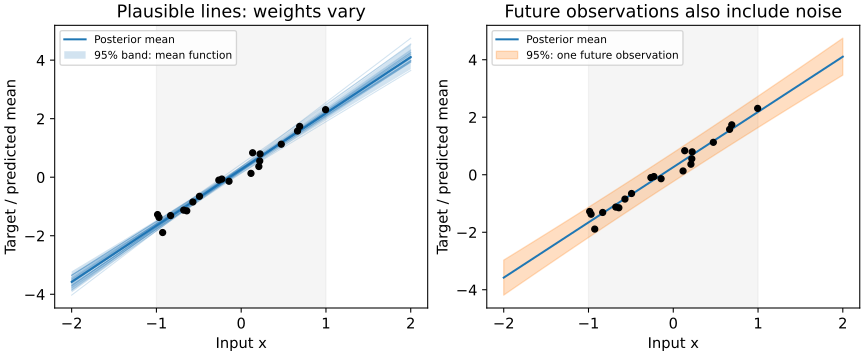
Рисунок 8 разделяет два вида неопределённости. Эти интервалы не являются одновременными полосами для всей кривой и не дают гарантий при сдвиге распределения. В расчёте регрессии из практического занятия показанные уравнения вычисляются решением линейных систем. Точный гауссовский ответ опирается на среднее, линейное по весам, гауссовский шум и гауссовское априорное распределение; нелинейная нейросеть обычно лишается этой замкнутой формы.
От точного вывода к приближённому предсказанию нейросети
В предыдущих примерах можно было получить нормированные апостериорные распределения и выполнить предсказательные расчёты. Что усложняется, если тот же вероятностный подход применить к большой нейросети?
Почему точный байесовский вывод становится трудным
Множество весов взаимодействует через нелинейные слои, поэтому произведение правдоподобия и априорной плотности редко сводится к знакомой нормированной плотности. Правдоподобные параметры могут образовывать коррелированные области или разделённые моды. Evidence интегрирует по всем ним; для предсказания требуется ещё одно взвешенное усреднение:
\[ \begin{aligned} p(y_*\mid x_*,\mathcal D) =\int &p(y_*\mid x_*,\theta)\\ &\times p(\theta\mid\mathcal D)\,d\theta. \end{aligned} \]
Препятствие — не сама непрерывность: предыдущая непрерывная регрессионная модель допускала точное решение. Сложность создаёт сочетание размерности, формы апостериорного распределения и повторного интегрирования.
Методы Монте-Карло по цепям Маркова строят зависимые выборки, нацеленные на апостериорное распределение; они могут использовать ненормированную плотность, хотя её полноценное исследование бывает дорогим. Вариационный вывод вместо этого подбирает удобное аппроксимирующее распределение. Поэтому недоступный нормировочный множитель не делает все байесовские вычисления невозможными. Эти методы имеют вычислительные издержки или погрешности приближения; ни один автоматически не исправляет неверно заданную модель наблюдений (Bishop 2006 г., разд. 10.1).
Монте-Карло dropout: предсказания со случайными масками
Пусть \(T\) — число стохастических проходов. Верхние индексы \((t)\) нумеруют выборки, \(t=1,\ldots,T\), а не обозначают степени. Предположим, что мы можем получать приближённые наборы весов \(\theta^{(1)},\ldots,\theta^{(T)}\). Предсказательный интеграл превращается в среднее Монте-Карло соответствующих распределений наблюдений. Ярин Гал и Зубин Гахрамани показали, как обучение с dropout и стохастическое предсказание допускают приближённую байесовскую интерпретацию (Gal и Ghahramani 2016 г., разд. 3–4). В их конструкции маски dropout задают ограниченное семейство распределений эффективных весов сети; целевая функция связывает качество описания данных и регуляризацию с вариационным выводом.
Это даёт практический переход: обучать с dropout, а затем оставлять dropout-слои активными при повторных предсказаниях. Это не обосновывает добавление dropout в произвольную уже обученную сеть. Практическое занятие иллюстрирует механизм стохастического предсказания; оно не воспроизводит полностью согласованные априорное распределение и регуляризацию из статьи и не демонстрирует калиброванные апостериорные вероятности.
Для скалярной регрессии предсказания среднего с масками \(\widehat y_*^{(t)}\) дают эмпирическое среднее \(\bar y_*\) и дисперсию по маскам \(v_{\mathrm{masks}}\):
\[ \bar y_*=\frac1T\sum_t\widehat y_*^{(t)},\qquad v_{\mathrm{masks}}=\frac1T\sum_t(\widehat y_*^{(t)}-\bar y_*)^2. \]
Этот эмпирический разброс не включает шум наблюдений. Для приближения полной предсказательной дисперсии нужно добавить среднюю условную дисперсию шума. Для классификации усредняйте вероятности каждого прохода, а не логиты перед применением сигмоиды или Softmax.
Эта функция соответствует зарегистрированным модулям torch.nn.Dropout практического занятия и вещественному выходу среднего. Остальные слои остаются в режиме оценки (PyTorch contributors, б. д.-c):
import torch

def dropout_predictions(model, x, passes=100):
    assert passes > 1
    model.eval()
    try:
        for layer in model.modules():
            if isinstance(layer, torch.nn.Dropout):
                layer.train()
        with torch.no_grad():
            draws = torch.stack([model(x) for _ in range(passes)])
    finally:
        model.eval()
    return draws.mean(0), draws.var(0, unbiased=False)
При форме входа \((B,1)\) и скалярного выхода \((B,1)\) собранные предсказания имеют форму \((T,B,1)\); оба возвращаемых массива имеют форму \((B,1)\). Для дисперсии используется указанное выше эмпирическое соглашение \(1/T\). Режим оценки восстанавливается, даже если предсказание завершилось ошибкой.
При чтении раздела практического занятия о dropout учитывайте два ограничения. Независимые маски для разных строк батча означают, что один изображённый проход не обязательно является одним согласованным апостериорным образцом функции на всех входах. Кроме того, нелинейная MLP и точная модель прямой относятся к разным семействам функций; их графики не позволяют ранжировать методы вывода. Разброс по маскам не гарантирует роста неопределённости вне обучающего диапазона, калибровки или устойчивости.
VAE выполняет приближённый байесовский вывод о скрытых кодах
До сих пор неопределёнными величинами были частота дождя или общие веса регрессии. Вариационный автоэнкодер (variational autoencoder, VAE) вводит ненаблюдаемый код каждого изображения. Его байесовский вывод относится к этому коду; обычный VAE в данной главе по-прежнему обучает точечные оценки весов сети (Kingma и Welling 2014 г.).
Порождаем изображение в прямом направлении, восстанавливаем код в обратном
Здесь обозначения меняются: \(x\) теперь обозначает целое наблюдаемое изображение, а не скалярный вход регрессии. Пусть \(u\in\mathbb R^d\) — его скрытый код: \(\mathbb R^d\) — пространство вещественных векторов с \(d\) координатами, а \(d\) теперь означает размерность скрытого пространства. Обозначим через \(\theta\) веса декодера, через \(\psi\) — веса энкодера. Кингма и Веллинг используют \(z\) и \(\phi\) вместо наших \(u\) и \(\psi\); мы сохраняем \(\phi\) для функции активации курса.
Порождающая модель описывает прямой процесс (\(I_d\) — единичная матрица \(d\times d\)):
\[ \begin{aligned} u&\sim p(u)=\mathcal N(0,I_d),\\ x\mid u,\theta&\sim p(x\mid u,\theta),\\ p(x,u\mid \theta)&=p(x\mid u,\theta)p(u). \end{aligned} \]
Декодер задаёт параметры распределения наблюдаемого изображения. При заданном изображении вывод задаёт обратный вопрос: какие коды могли его породить? По правилу Байеса
\[ \begin{aligned} p(u\mid x,\theta)&=\frac{p(x\mid u,\theta)p(u)}{p(x\mid \theta)},\\ p(x\mid \theta)&=\int p(x\mid u,\theta)p(u)\,du. \end{aligned} \]
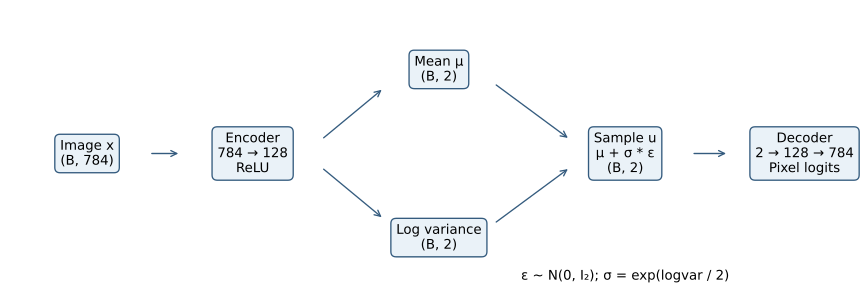
Нелинейный декодер обычно затрудняет точное вычисление этого интеграла и апостериорного распределения. Вместо точного решения энкодер выдаёт вектор средних \(\mu_u(x)\) и вектор логарифмов дисперсий \(\ell_u(x)\) для удобного приближения. Оператор \(\operatorname{diag}\) помещает вектор на диагональ матрицы; экспонента применяется к каждой координате:
\[ q(u\mid x,\psi)=\mathcal N\!\left( u;\mu_u(x),\operatorname{diag}(\exp(\ell_u(x)))\right). \]
Здесь \(\ell_u\) — вектор логарифмов дисперсий, а не логарифмов стандартных отклонений. Гауссовское приближение не означает, что точное апостериорное распределение гауссовское. Один общий энкодер сопоставляет разным изображениям их собственные распределения; такое повторное использование называется амортизированным выводом (amortized inference).
| Модель | Что наблюдается | О какой неизвестной величине идёт вывод | Какое распределение сохраняется |
|---|---|---|---|
| Байесовская регрессия | Обучающие пары | Общие веса \(\theta\) | \(p(\theta\mid\mathcal D)\) |
| Рассматриваемый VAE | Изображение \(x\) | Его код \(u\) | Приближение \(q(u\mid x,\psi)\) |
Априорное распределение, модель наблюдений и апостериорная цель делают этот вывод байесовским. Одна лишь случайность в узком месте сети такой интерпретации не обеспечивает. Апостериорное распределение по \(\theta\) или \(\psi\) здесь не сохраняется.
От правила Байеса к нижней вариационной границе
Как обучать приближение и декодер? Здесь \(q\) и \(p\) — две сравниваемые плотности, а \(\mathbb E_q\) означает усреднение по выборкам из \(q\). Определим дивергенцию Кульбака — Лейблера (KL) между двумя плотностями на одном пространстве:
\[ D_{\mathrm{KL}}(q\|p)=\mathbb E_q[\ln q(u)-\ln p(u)]\geq0. \]
Она измеряет направленное различие, а не симметричное расстояние. Предполагаем, что следующие интегралы конечны, а \(p\) положительна всюду, где \(q\) имеет ненулевую массу. Начнём с различия относительно апостериорного распределения и подставим правило Байеса:
\[ \begin{aligned} &D_{\mathrm{KL}}(q(u\mid x,\psi)\|p(u\mid x,\theta))\\ &\quad=\mathbb E_q[\ln q(u\mid x,\psi)-\ln p(u\mid x,\theta)]\\ &=\mathbb E_q[\ln q(u\mid x,\psi)-\ln p(u)\\ &\qquad-\ln p(x\mid u,\theta)+\ln p(x\mid \theta)]. \end{aligned} \]
Evidence изображения \(p(x\mid \theta)\) постоянно по \(u\), поэтому его логарифм выходит из математического ожидания. Перестановка слагаемых даёт ключевое тождество:
\[ \begin{aligned} \ln p(x\mid \theta) &=\mathcal E(\theta,\psi;x)\\ &\quad+D_{\mathrm{KL}}(q(u\mid x,\psi)\|p(u\mid x,\theta)),\\[2pt] \mathcal E(\theta,\psi;x) &=\underbrace{\mathbb E_q[\ln p(x\mid u,\theta)]}_{\text{expected reconstruction log likelihood}}\\ &\quad-\underbrace{D_{\mathrm{KL}}(q(u\mid x,\psi)\|p(u))}_{\text{discrepancy to the prior}}. \end{aligned} \]
Неотрицательность апостериорной дивергенции делает \(\mathcal E\) нижней границей логарифма evidence (evidence lower bound, ELBO). Её можно оптимизировать без вычисления интеграла evidence (Kingma и Welling 2014 г., разд. 2.2). Обратите внимание на две разные дивергенции: KL относительно апостериорного распределения — зазор до логарифма evidence; KL относительно априорного распределения — вычислимое слагаемое внутри границы. Даже при совпадении \(q\) с точным апостериорным распределением априорная KL не обязана обращаться в ноль.
При фиксированном декодере улучшение \(q\) приближает эту границу к фиксированному evidence. Совместное обучение меняет и \(\theta\), поэтому меняется само evidence. При оптимизации весов декодера его нельзя отбросить как константу. Наконец, граница относится к точному математическому ожиданию: одна оценка реконструкции по Монте-Карло может оказаться выше логарифма evidence, не нарушая тождества.
Репараметризация связывает границу с обучаемыми сетями
Чтобы дифференцировать через случайный код, для каждого изображения сгенерируем независимый стандартный гауссовский шум \(\epsilon\) и запишем выборку как
\[ \epsilon\sim\mathcal N(0,I_d),\qquad u=\mu_u(x)+\exp(\ell_u(x)/2)\odot\epsilon. \]
\(\odot\) означает поэлементное умножение. Если в одном обратном проходе считать выбранное \(\epsilon\) фиксированным, \(u\) становится дифференцируемой функцией обеих голов энкодера. Новые прямые проходы генерируют новый шум. Градиенты достигают головы среднего, головы логарифма дисперсии и декодера; множитель \(1/2\) превращает логарифм дисперсии в логарифм стандартного отклонения.
Далее \(j\) нумерует пиксели, а \(k\) — координаты скрытого кода. В практическом занятии пиксели MNIST пороговым преобразованием приводятся к \(x_j\in\{0,1\}\). Декодер выдаёт 784 логита, задавая условно независимые пиксели Бернулли с вероятностями \(\widehat x_j(u)\). Предположение о независимости выполняется при заданном коде; общий случайный код всё ещё может делать пиксели маргинально зависимыми. Как и в Бернулли: от двух случаев к бинарной перекрёстной энтропии, отрицательный логарифм правдоподобия даёт
\[ \begin{aligned} -\ln p(x\mid u,\theta) =-\sum_{j=1}^{784}\big[&x_j\ln\widehat x_j(u)\\ &+(1-x_j)\ln(1-\widehat x_j(u))\big]. \end{aligned} \]
Это сумма пиксельных BCE, а не произвольно выбранная мера расстояния между изображениями. Для диагонального гауссовского энкодера и стандартного нормального априорного распределения другое слагаемое имеет замкнутую форму:
\[ D_{\mathrm{KL}}(q(u\mid x,\psi)\|p(u)) =\frac12\sum_{k=1}^d\left[ \mu_{u,k}^2+\exp(\ell_{u,k})-1-\ell_{u,k}\right]. \]
Поэтому минимизация отрицательной ELBO означает ожидаемую BCE реконструкции плюс эту априорную KL. В практическом занятии ожидание оценивается по одному коду на изображение; слагаемые суммируются по пикселям и координатам кода, а затем усредняются по изображениям батча. Оба слагаемых имеют коэффициент один. Усреднение BCE по пикселям без изменения KL изменило бы их относительный вес и целевую функцию.
При размере батча \(B\) формы изображений и логитов равны \((B,784)\); формы среднего и логарифма дисперсии — \((B,2)\) в двумерном примере. Каждое суммированное слагаемое имеет форму \((B,)\) до итогового усреднения по батчу. Двухкомпонентная функция потерь и проверки градиентов практического занятия реализуют этот расчёт с численно устойчивой BCE на логитах.
Для реконструкции декодирование среднего кода энкодера удобно для визуализации, но в общем случае отличается от усреднения декодированных выходов. Для генерации выберите новый код из априорного распределения и декодируйте вероятности пикселей; при желании сгенерируйте по ним бинарные пиксели. Малая ошибка реконструкции сама по себе не доказывает качество априорных образцов или интерпретируемость координат скрытого пространства.
Частотный и байесовский подходы: что меняется?
Обоим подходам нужна обоснованная модель наблюдений. BCE, категориальная CE и гауссовский NLL регрессии возникли из этой модели ещё до введения априорного распределения. Различается обращение с неизвестными величинами и неопределённостью. Таблица сравнивает конкретные рассмотренные методы, а не все методы каждой статистической традиции.
| Вопрос | Частотное MLE | MAP | Сохраняемое байесовское апостериорное распределение |
|---|---|---|---|
| Как рассматриваются веса? | Фиксированные неизвестные параметры | Поиск одной апостериорной моды | Неопределённость представляется распределением |
| Что определяет результат? | Правдоподобие | Правдоподобие и априорное распределение | Правдоподобие и априорное распределение |
| Что сохраняется? | Один максимизирующий набор | Один максимизирующий набор | Точное или приближённое апостериорное распределение |
| Как предсказывается новый исход? | Модель наблюдений при подобранных весах | Модель наблюдений при MAP-весах | Усреднение моделей наблюдений по апостериорному распределению |
| Какая неопределённость доступна непосредственно? | Изменчивость модели наблюдений | Изменчивость модели наблюдений | Шум наблюдений и неопределённость параметров |
| Какие вычисления нужны здесь? | Оптимизация | Оптимизация со штрафом | Интегрирование, выборка или приближение |
Частотный анализ также оценивает неопределённость оценивания, например с помощью доверительных интервалов или бутстрепа. Он не ограничивается точечными предсказаниями. Частотная 95%-я доверительная процедура накрывает фиксированный истинный параметр в 95% повторных наборов данных при своих предположениях. 95%-я байесовская вероятностная область (credible region) содержит 95% апостериорной вероятности при условии наблюдаемых данных, модели и априорного распределения. Ни одна интерпретация не гарантирует надёжность при сдвиге распределения или неверной спецификации модели (Bishop 2006 г., разд. 1.2.3).
MAP связывает два вычислительных подхода: гауссовское априорное распределение весов даёт знакомые потери с L2-регуляризацией, причём коэффициент определяется способом агрегирования потерь. Однако один MAP-набор не даёт предсказательного интеграла или апостериорной ковариации. В свою очередь, приближённое распределение полезно лишь настолько, насколько адекватны его предположения и само приближение.
Читая целевую функцию обучения, задавайте три вопроса: Что наблюдается? Что неизвестно? Что сохраняется? В бинарной классификации сеть задаёт распределение меток. Байесовская регрессия дополнительно сохраняет неопределённость общих весов. Dropout предоставляет ограниченный механизм приближённого вывода. VAE выводит распределение скрытого кода каждого изображения, обучая при этом точечные значения весов сети. Эти различия объясняют и происхождение функций потерь, и смысл выходов обученной модели.
Вопросы и упражнения (необязательные)
Эти вопросы возвращают к выводам главы; обучать VAE для них не требуется.
Внимательно прочитайте условие. Используя Таблица 1, вычислите \(P(R=1\mid S=0)\) и \(P(S=0\mid R=1)\). Сформулируйте словами, что означает каждый знаменатель. Почему ответы описывают разные вопросы о датчике?
Выведите правила выбора. Проверьте выражение Бернулли \(\widehat y^{\,y}(1-\widehat y)^{1-y}\) для обеих меток. Перенесите рассуждение на one-hot-цель с тремя классами и выведите средний NLL набора данных. Укажите предположение о независимости наблюдений.
Корректно обучите дисперсию. Зафиксируйте ненулевой остаток регрессии. Что произойдёт, если модель минимизирует только квадрат остатка, делённый на предсказанную дисперсию? Объясните роль логарифма дисперсии в гауссовском NLL. Почему плотность в одном точном целевом значении не равна вероятности этого значения?
Сохраните масштаб априорного штрафа. Начните с суммы NLL плюс \(\|\theta\|^2/(2\tau^2)\) для \(n\) обучающих примеров. Перепишите ту же цель со средним NLL. Для равномерно выбранного мини-батча размера \(B\) дайте несмещённую оценку этой усреднённой цели и укажите, где появляются \(n\) и \(B\).
Разделите два интервала. В линейно-гауссовском примере запишите дисперсию неопределённого среднего при \(x_*\) и дисперсию будущего показания в этой точке. Объясните, что добавляется, почему и какой интервал останется шире при очень малой неопределённости параметров.
Найдите байесовский вывод. Для VAE назовите наблюдаемую переменную, скрытую неизвестную величину, обучаемые веса и приближённое апостериорное распределение. Какая KL в тождестве ELBO задаёт зазор, а какая входит в целевую функцию обучения? Если бы энкодер совпадал с точным апостериорным распределением, обратились бы обе KL в ноль? Обоснуйте ответ через их аргументы.