Неделя 05 · Обучение визуальным представлениям: локальные признаки, общие веса и свёрточные сети
Вертикальная граница может находиться слева, в центре или справа на изображении. Её положение меняется, но локальное соотношение тёмных и светлых пикселей остаётся тем же. Полезная модель должна повторно использовать это соотношение, а не изучать его заново для каждого положения.
На неделе 04 мы разобрали механизм обучения представлений: аффинные преобразования, нелинейные активации, функцию потерь, обратное распространение и обновление параметров. Свёрточные нейронные сети (convolutional neural networks, CNN) сохраняют этот механизм, но задают структуру аффинных преобразований. Каждый выход раннего слоя использует локальную окрестность, а одни и те же параметры применяются во многих пространственных позициях. Так модель выражает предположения: соседние измерения связаны, а похожие локальные структуры повторяются.
Сначала уточним эти предположения на изображениях и небольших примерах. Затем выведем, как общие параметры получают градиент от всех своих применений. Разберём пространственную геометрию, глубокие архитектуры, нормализацию и перенос обучения. В конце сравнение моделей на сигналах поможет оценить, полезна ли такая структура для конкретной задачи.
Результаты обучения
После изучения главы вы сможете:
- объяснять и вычислять свёрточные представления, явно указывая оси тензоров, локальные связи и общие параметры;
- выводить градиенты общих весов, определять формы тензоров и число параметров;
- рассуждать о дополнении границ, шаге, пулинге, рецептивных полях и сдвигах;
- объяснять остаточное обучение и нормализацию, включая градиенты, оси и состояние;
- выбирать и проверять аугментации, перенос с фиксированными признаками и дообучение;
- интерпретировать сравнение моделей, различая решения по валидационной выборке, выводы по тесту и более широкие утверждения.
Необходимые знания и сопутствующие материалы
Предполагается знакомство с матричным умножением, производными скалярных функций, прямым проходом и цепным правилом из недели 04. В главе недели 04 объясняется, почему производные перемножаются вдоль пути и складываются в точках слияния путей. Знания обработки изображений не требуются.
Лекция недели 05 даёт визуальную последовательность объяснений. Практикум по свёрткам раскрывает вычисления и проверяет их средствами PyTorch. Здесь мы используем часть его рисунков и примеров, развивая рассуждение в тексте. Переход от ручного вычисления отклика к сканированию вдохновлён главой fastai о свёртках; примеры и рисунки курса созданы независимо.
Почему структура изображения меняет модель
Что измеряли Хьюбел и Визел?
Зрительный нейрон может по-разному реагировать на разные части сцены. В исследовании 1959 года Дэвид Хьюбел и Торстен Визел регистрировали активность отдельных клеток зрительной коры кошек под лёгкой анестезией, предъявляя световые стимулы. Изменение положения и ориентации стимула меняло отклик некоторых клеток (Hubel и Wiesel 1959 г.).
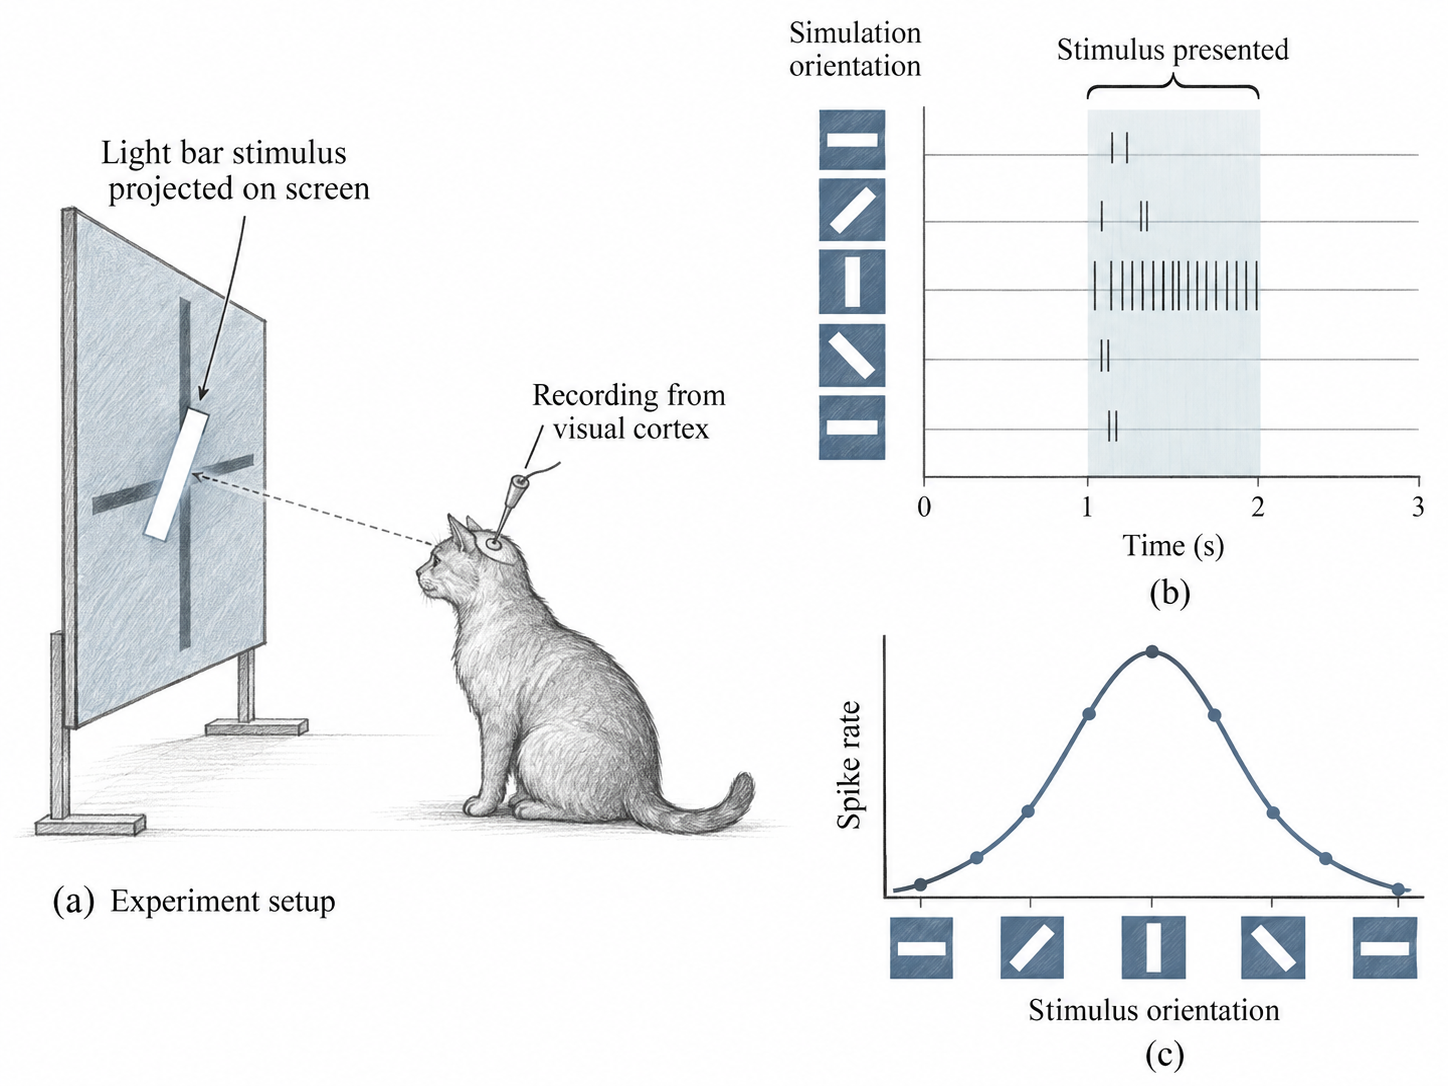
Различим два вопроса. Где стимул может влиять на клетку? Эта область называется её рецептивным полем. Какой рисунок вызывает сильный отклик внутри этой области? Это избирательность: полоска одной ориентации может давать более сильный отклик, чем та же полоска после поворота.
Отсюда возникает инженерный вопрос: можно ли построить вычисление, чувствительное к определённому соотношению соседних пикселей? Небольшое окно с весами даёт простой ответ. Применять совершенно одинаковые веса во всех позициях — дополнительный выбор архитектуры. Биологический эксперимент мотивирует локальную избирательность, но не устанавливает точное правило разделения параметров CNN.
От избирательного отклика к искусственному детектору
Сравним яркость справа и слева в небольшом фрагменте. Вычтем значения слева и прибавим значения справа. На однородном фрагменте вклады сократятся; граница от тёмного к светлому даст положительный отклик; обращение границы изменит знак. Мы задали локальный вопрос без обучения модели.
Другой вариант — присвоить всем пикселям одинаковые положительные веса с суммой один. Получим локальное среднее. Пиксели остались прежними, а выбор коэффициентов изменил измеряемое свойство. Фиксированные фильтры, заданные вручную, позволяют понять операцию до обучения коэффициентов по данным.
Каналы описывают что, пространственные оси — где
В полутоновом изображении каждой позиции соответствует одна интенсивность. В RGB-изображении — три измерения: красное, зелёное и синее. Это каналы одного изображения. Батч содержит несколько изображений, у каждого из которых свои каналы и пространственные координаты.
Используем расположение осей, в котором батч идёт первым:
\[ \mathbf X\in\mathbb R^{B\times C_{\mathrm{in}}\times H\times W}. \]
\(\mathbb R\) обозначает действительные числа: \(\mathbf X\) — вещественный тензор с указанными размерами осей. Жирные символы обозначают векторы, матрицы и тензоры целиком; обычные символы с индексами — отдельные элементы. \(B\) — число примеров, \(C_{\mathrm{in}}\) — число входных каналов, \(H,W\) — высота и ширина. Обычная \(W\) означает ширину, а жирная \(\mathbf W\) — тензор параметров. Если различать вход и выход не требуется, число каналов обозначается \(C\). Библиотеки отображения часто используют порядок \((H,W,C)\) для одного изображения. В PyTorch каналы идут перед пространственными осями: \((C,H,W)\) для изображения и \((B,C,H,W)\) для батча. Перестановка осей не меняет смысл значений.
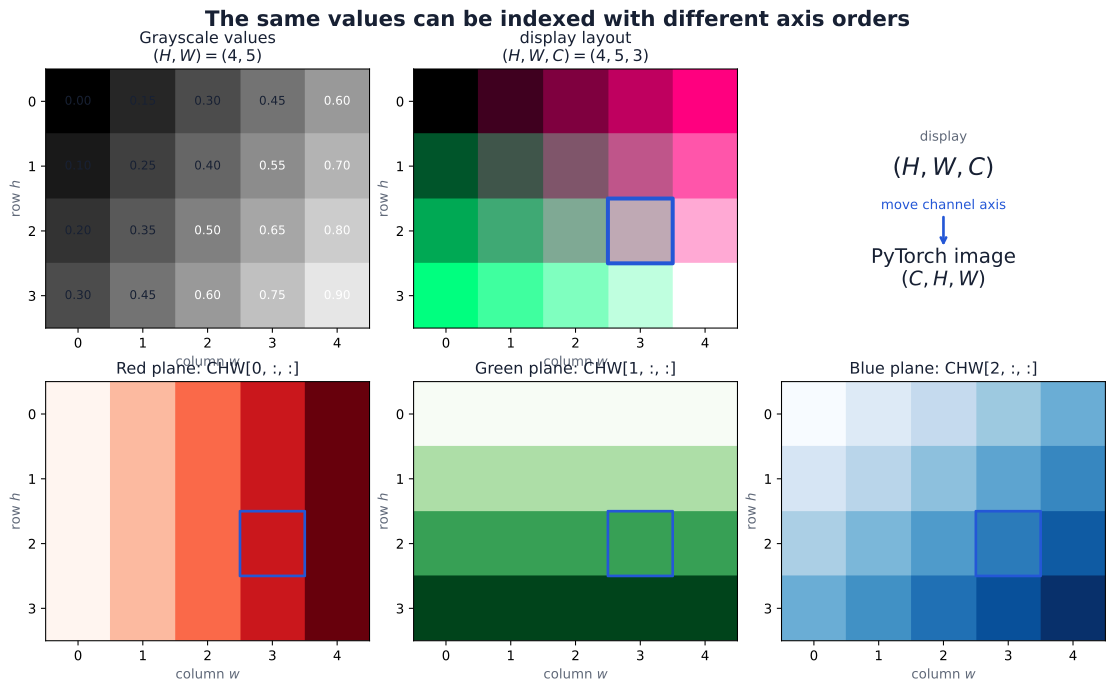
При переходе от \((H,W,C)\) к \((B,C,H,W)\) нужна перестановка осей; простое изменение формы обычно её не выполняет. В сцене практикума о тензорах изображений можно проследить один пиксель при таком преобразовании.
Локальность и общие веса задают разные ограничения
Полносвязный слой может назначить каждому выходу независимо настраиваемый коэффициент для каждого входного значения. Развёртка изображения в вектор позволяет применить такой слой, но архитектура не выделяет соседние пиксели особо. Пространственные связи могут быть выучены по данным, однако они не заложены в схему соединений.
Локальность ограничивает один выход небольшой пространственной окрестностью. Разделение параметров (parameter sharing, использование общих весов) применяет один набор коэффициентов во многих окрестностях. Эти ограничения независимы: локально связанный слой мог бы использовать разные коэффициенты в разных позициях. Свёртка объединяет локальность и общие веса, задавая один и тот же локальный вопрос во всех положениях окна.
От локального вычисления к свёрточному слою
Фиксированное ядро задаёт локальный отклик со знаком
Начнём с одного канала и окна \(3\times3\). Ядро назначает коэффициент каждой относительной позиции внутри окна. Перемножение соответствующих элементов и сложение произведений дают один скалярный отклик.
Локальное усреднение также называют размытием. Фильтр границ присваивает противоположные знаки разным сторонам окна. Прежде чем читать матрицы, предположите, какая операция даст ноль на постоянном фрагменте. Рассмотрим три ядра:
\[ \begin{aligned} \mathbf W_{\mathrm{mean}} &=\frac{1}{9} \begin{bmatrix}1&1&1\\1&1&1\\1&1&1\end{bmatrix},\\[3pt] \mathbf W_{\mathrm{horizontal}} &=\begin{bmatrix}-1&-1&-1\\0&0&0\\1&1&1\end{bmatrix},\\[3pt] \mathbf W_{\mathrm{vertical}} &=\begin{bmatrix}-1&0&1\\-1&0&1\\-1&0&1\end{bmatrix}. \end{aligned} \]
Первое вычисляет локальное среднее. Второе сравнивает нижнюю строку с верхней, третье — правый столбец с левым. Для контрастных ядер знак отражает направление перехода: переход от тёмного к светлому вниз или вправо даёт положительный отклик при выбранных коэффициентах. Обратный переход меняет знак.
Пусть \(\mathbf P\) — выбранный в практикуме фрагмент, содержащий значения пикселей одного окна:
\[ \mathbf P= \begin{bmatrix} 0&0&0\\ 1&1&1\\ 1&1&1 \end{bmatrix}, \]
Обозначим скалярные отклики трёх ядер через \(R_{\mathrm{mean}},R_{\mathrm{horizontal}},R_{\mathrm{vertical}}\):
\[ \begin{aligned} R_{\mathrm{mean}}&=6/9=2/3,\\ R_{\mathrm{horizontal}}&=(-1)(0+0+0)+(1)(1+1+1)=3,\\ R_{\mathrm{vertical}}&=(0-0)+(1-1)+(1-1)=0. \end{aligned} \]
Нулевой отклик вертикального фильтра означает, что вклады слева и справа сократились. Это не означает, что фрагмент пуст. Разные ядра измеряют разные соотношения между одними и теми же значениями.
Сканирование превращает локальные отклики в карты
Пусть \(a,c\) — строка и столбец выхода, \(u,v\) — относительные смещения внутри ядра. \(k_H,k_W\) — высота и ширина ядра, \(W_{u,v}\) — коэффициент, \(X_{a+u,c+v}\) — соответствующее значение изображения. Все координатные индексы начинаются с нуля. При шаге один, без дополнения и смещения отклик равен
\[ R_{a,c} =\sum_{u=0}^{k_H-1}\sum_{v=0}^{k_W-1} W_{u,v}X_{a+u,c+v}. \]
Координата выхода задаёт левый верхний угол окна во входе без дополнения. У окна \(3\times3\) на учебном изображении \(7\times7\) допустимы начала от 0 до 4 по каждой оси. Каждое ядро даёт карту отклика \(5\times5\). Выбранный выше фрагмент начинается в строке 1, столбце 2, поэтому его отклики находятся в позиции \((1,2)\) соответствующих карт.
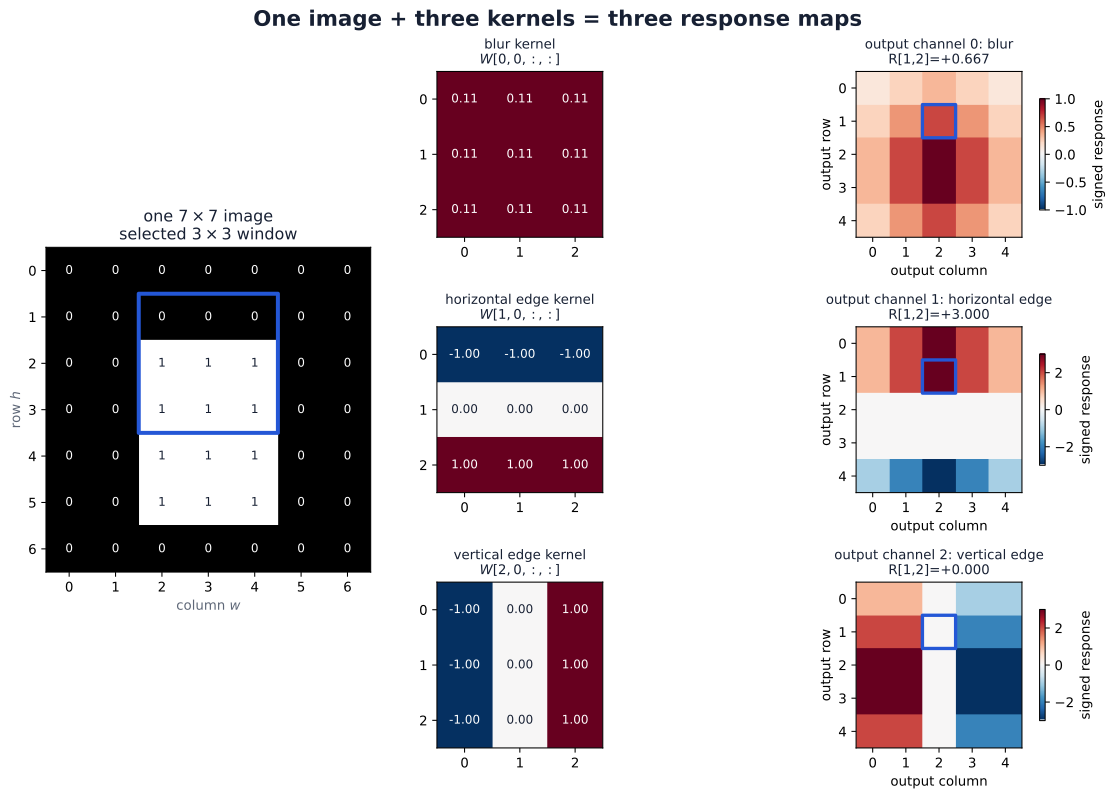
Повторение этого локального вычисления составляет основу свёртки: ядро хранит локальные веса, а ответы при сканировании образуют карту отклика. Коэффициенты не меняются при движении окна. Карта показывает ответы разных окрестностей на один фиксированный вопрос. Это значения со знаком; они не обязаны лежать между нулём и единицей. Цветовая шкала отображения не меняет их численный смысл.
В математическом определении свёртки координаты ядра обращаются. Здесь коэффициенты используются в сохранённом порядке; такая операция называется взаимной корреляцией (cross-correlation). В PyTorch и литературе по глубокому обучению её называют свёрткой. Мы следуем этому соглашению, явно отмечая отсутствие переворота ядра. См. определение Conv2d в PyTorch.
Один выходной фильтр объединяет все входные каналы
Цветное изображение даёт три согласованных измерения в каждом пикселе: красное, зелёное и синее. Выберем одно пространственное окно. Оно содержит красный, зелёный и синий фрагменты с одинаковыми координатами. Как получить из них один отклик?
Полный фильтр содержит по одному срезу ядра на входной канал. Совместим красный фрагмент с красным срезом, перемножим соответствующие элементы и сложим. Повторим для зелёного и синего. Сумма трёх вкладов и одного смещения даст одну преактивацию. Значения срезов могут различаться: фильтр способен сравнивать и цвета, и пространственные позиции.
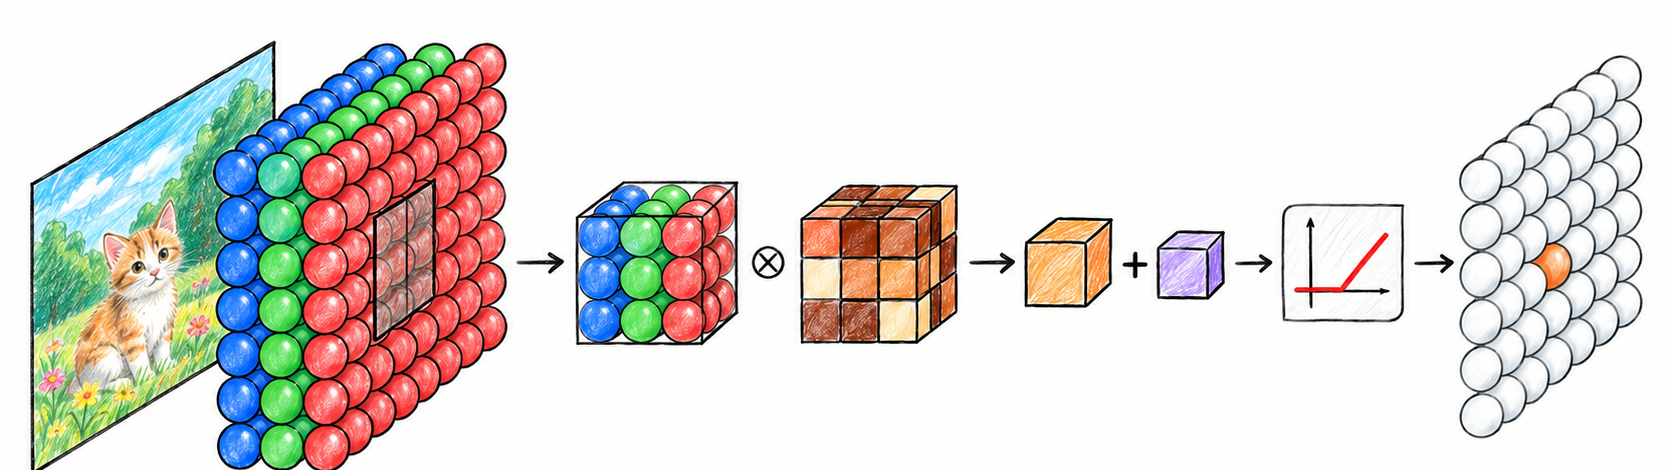
Читайте рисунок слева направо. Знак умножения означает поэлементные произведения и их сумму по всему фрагменту, а не три отдельных выхода. Маленький куб после него изображает один скаляр. Прибавление смещения завершает аффинную операцию; красный график — ReLU, заменяющая отрицательные преактивации нулями. Перемещение полного фильтра по высоте и ширине заполняет одну карту. По оси каналов фильтр не скользит.
Для RGB-окна \(3\times3\) один фильтр содержит три среза по девять коэффициентов. У второго фильтра — другой полный набор срезов и собственное смещение. Сканирование обоими фильтрами даёт две выходные карты, форму весов \((2,3,3,3)\) и число параметров
\[ 2\cdot3\cdot3\cdot3+2=56. \]
Первая ось считает выходные фильтры, вторая — входные каналы, две последние — пространственные смещения. Три размера случайно равны 3, но означают разное. В цветном примере практикума разобраны два заданных вручную фильтра на фотографии Chelsea: вертикальный яркостный контраст и сравнение локального среднего тёплых цветов с синим.
RGB-свёртка содержит четыре выходных фильтра. Видит ли каждый только один цвет? Сколько выходных карт получится?
Показать объяснение
Каждый обычный фильтр объединяет все три входных канала с помощью трёх срезов. Один полный фильтр даёт одну карту, поэтому четыре фильтра дадут четыре карты. Число входных каналов и число выходных фильтров описывают разные свойства.
От цветов к обученным картам признаков
После первого слоя входные каналы уже не обязательно соответствуют красному, зелёному и синему. Это карты предыдущего слоя — разные выученные измерения в каждой позиции. Следующий фильтр может объединять отклик одного канала с соседними откликами других. Вычисление остаётся прежним, меняется смысл входных данных.
Пусть скрытый слой получает восемь входных карт и должен выдать шестнадцать выходных. Каждый из шестнадцати фильтров содержит восемь пространственных срезов. Число входных каналов показывает, сколько измерений объединяет фильтр; число выходных — сколько разных фильтров применяется. Ни одно из них не равно по определению числу классов. Карта признаков (feature map) — общее название карты канала. Здесь картой отклика называем результат фиксированного фильтра, а картой активаций — обученное представление после активации.
Общий аффинный слой и формы тензоров
Теперь соберём индексную запись. Функция \(\phi\) — поэлементная активация, применяемая после аффинного вычисления. В этом выводе опустим верхний индекс слоя: \(\mathbf h\) — входное представление, \(\mathbf z\) — выходная преактивация, \(\mathbf W,\mathbf b\) — параметры. Обозначим дополненный вход через \(\widetilde{\mathbf h}\). При симметричном нулевом дополнении ширины \(p_H,p_W\) исходная координата \((q,t)\) переходит в \((q+p_H,t+p_W)\), а позиции за пределами изображения заполнены нулями.
Для обычной свёртки без группировки с соседними элементами ядра (groups=1, dilation=1):
\[ \begin{aligned} z_{n,o,a,c} &=b_o+ \sum_{i=0}^{C_{\mathrm{in}}-1} \sum_{u=0}^{k_H-1} \sum_{v=0}^{k_W-1} W_{o,i,u,v}\, \widetilde h_{n,i,a s_H+u,c s_W+v},\\ h^{\mathrm{out}}_{n,o,a,c} &=\phi(z_{n,o,a,c}). \end{aligned} \]
\(n\) выбирает пример в батче от 0 до \(B-1\); \(o\) — выходной фильтр; \(i\) — входной канал; \(s_H,s_W\) — шаги между началами окон. \(a,c\) задают пространственные координаты выхода; \(b_o\) — одно смещение выходного канала \(o\). Три суммы объединяют все входные каналы и все позиции локального окна. Одни и те же \(W_{o,i,u,v}\) и \(b_o\) используются для каждого примера и каждой вычисляемой позиции.
\(C_{\mathrm{out}}\) — число выходных фильтров, \(H_{\mathrm{out}},W_{\mathrm{out}}\) — высота и ширина выхода. Верхний индекс \(\mathrm{out}\) обозначает выходное представление. Формы тензоров:
\[ \begin{aligned} \mathbf h&\in\mathbb R^{B\times C_{\mathrm{in}}\times H\times W},\\ \mathbf W&\in\mathbb R^{C_{\mathrm{out}}\times C_{\mathrm{in}}\times k_H\times k_W},\\ \mathbf b&\in\mathbb R^{C_{\mathrm{out}}},\\ \mathbf z,\mathbf h^{\mathrm{out}} &\in\mathbb R^{B\times C_{\mathrm{out}}\times H_{\mathrm{out}}\times W_{\mathrm{out}}}. \end{aligned} \]
Отсюда следует число параметров:
\[ N_{\mathrm{parameters}} =C_{\mathrm{out}}C_{\mathrm{in}}k_Hk_W+C_{\mathrm{out}} \]
при наличии смещений. Размер батча и пространственные размеры выхода сюда не входят. Большее число окон означает больше применений каждого параметра, а не больше независимо настраиваемых параметров.
Различие между \(\mathbf z\) и \(\mathbf h^{\mathrm{out}}\) существенно: отклик со знаком до ReLU отличается от представления после удаления отрицательных значений.
Почему общие веса экономят параметры
Рассмотрим полутоновое изображение \(28\times28\) и выход из восьми карт \(28\times28\). Полносвязный слой имеет 784 входа и \(8\cdot28\cdot28=6272\) выхода. С отдельным смещением у каждого выхода число параметров равно
\[ 784\cdot6272+6272=4{,}923{,}520. \]
Обычная свёртка с той же формой выхода, восемью фильтрами \(3\times3\), шагом один и одним нулевым пикселем дополнения с каждой стороны имеет
\[ 8\cdot1\cdot3\cdot3+8=80 \]
параметров. Дополнение позволяет вычислять окна у границы; его геометрия разобрана в разделе о пространстве. Восемь смещений используются во всех позициях, как и веса фильтров.
Входные и выходные размеры слоёв совпадают, но классы функций различаются. Полносвязный слой может обрабатывать один рисунок в разных местах с несвязанными коэффициентами. Свёртка требует повторного использования локального правила. Экономия параметров следует из ограничения; сама по себе она не доказывает ни точность, ни скорость работы.
Это ограничение — индуктивное смещение (inductive bias), предпочтение модели до предъявления обучающих примеров. Оно полезно, когда соседние измерения взаимодействуют, а локальные структуры повторяются. Оно может мешать, если абсолютное положение меняет смысл рисунка или порядок признаков произволен. Архитектурное предположение необходимо проверить на валидационных данных.
Как прочитать операцию PyTorch математически
В полутоновом примере практикума с тремя ядрами вход имеет форму \((1,1,7,7)\), веса — \((3,1,3,3)\), результат — \((1,3,5,5)\):
import torch.nn.functional as F

# image_hw: (7, 7); kernel_bank: (3, 3, 3)
image_batch = image_hw[None, None, :, :]
weights = kernel_bank[:, None, :, :]
responses = F.conv2d(image_batch, weights, bias=None)
assert responses.shape == (1, 3, 5, 5)
Этот фрагмент передаёт фиксированные веса функциональной операции. Обучаемый модуль nn.Conv2d сам хранит веса и необязательные смещения. Например, nn.Conv2d(3, 2, kernel_size=3) содержит 56 параметров из RGB-примера. Обратное распространение может обучать их коэффициенты; активация остаётся отдельной операцией. Соглашения о формах и вычислениях описаны в документации Conv2d.
Выходной канал — отклик одного полного фильтра во всех позициях. Его индекс не задаёт автоматически цвет или класс. У классификатора на десять классов не обязано быть десять каналов в каждом скрытом слое; \(K\) обозначает число классов, \(C\) — число каналов.
Обучение общих параметров
Прямое вычисление нам уже знакомо. Обучение меняет коэффициенты так, чтобы карты помогали решать задачу. Одно обновление общих весов меняет локальный вопрос во всех позициях.
Цикл обучения остаётся знакомым
Модель \(f_\theta\) преобразует вход в предсказание, а \(\theta\) объединяет обучаемые параметры. Для мини-батча \(\mathcal B\) из \(B\) примеров запишем целевую функцию:
\[ \mathcal L_{\mathcal B} =\frac{1}{B}\sum_{n\in\mathcal B}\ell_n, \qquad \ell_n=L\!\left(f_\theta(\mathbf x_n),y_n\right). \]
\(n\) — индекс примера, \(\mathbf x_n\) — его вход, \(y_n\) — целевое значение; \(\sum\) складывает потери по батчу. Это уточняет общее обозначение потерь \(L\) из недели 04: \(\ell_n\) — потери одного примера, \(\mathcal L_{\mathcal B}\) — средняя целевая функция обновления. Прямой проход, расчёт потерь, обратный проход и оптимизатор сохраняют свои роли. Свёртка меняет способ построения представлений.
Для слоя \(\ell\) сохраним различие между преактивацией и представлением:
\[ \begin{aligned} \mathbf z^{(\ell)} &=\operatorname{Conv}\!\left( \mathbf h^{(\ell-1)};\mathbf W^{(\ell)},\mathbf b^{(\ell)} \right),\\ \mathbf h^{(\ell)}&=\phi\!\left(\mathbf z^{(\ell)}\right), \qquad \mathbf h^{(0)}=\mathbf X. \end{aligned} \]
\(\ell\) — индекс слоя, \(\mathbf W^{(\ell)}\) и \(\mathbf b^{(\ell)}\) — веса и смещения, \(\mathbf z^{(\ell)}\) — преактивации, \(\mathbf h^{(\ell)}\) — представление после функции активации \(\phi\). Входное представление \(\mathbf h^{(0)}\) равно тензору \(\mathbf X\); \(\operatorname{Conv}\) обозначает свёртку с заданными параметрами. Верхние индексы в скобках нумеруют слои, а не задают степени.
При фиксированных параметрах свёртка со смещением аффинна по входу. Нелинейность вносит активация. Обучение меняет элементы \(\mathbf W^{(\ell)}\) и \(\mathbf b^{(\ell)}\) с помощью той же целевой функции и цепного правила, что и в полносвязной сети.
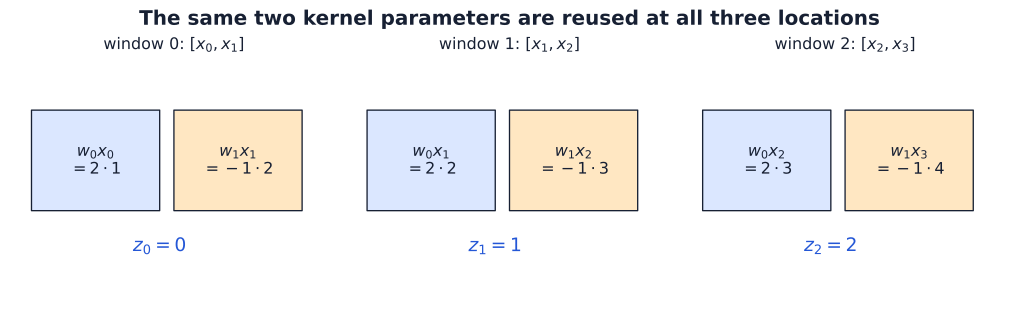
Одни и те же два веса в каждой позиции
В простейшем обучаемом примере используем один одномерный входной канал:
\[ \mathbf x=\begin{bmatrix}1&2&3&4\end{bmatrix}^{\!\top}, \qquad \mathbf w=\begin{bmatrix}w_0&w_1\end{bmatrix}^{\!\top} =\begin{bmatrix}2&-1\end{bmatrix}^{\!\top}. \]
\(x_t\) — значение в позиции \(t\), \(w_0,w_1\) — два общих коэффициента ядра. Верхний индекс \(\top\) превращает строку в столбец; это не индекс времени. При шаге один, без дополнения, смещения и активации три преактивации равны
\[ \begin{aligned} z_0&=w_0x_0+w_1x_1=2(1)-1(2)=0,\\ z_1&=w_0x_1+w_1x_2=2(2)-1(3)=1,\\ z_2&=w_0x_2+w_1x_3=2(3)-1(4)=2. \end{aligned} \]
Каждая строка использует те же два параметра. Общие веса — ограничение на тождественность параметров, а не совпадение начальных значений: обновление \(w_0\) меняет его вклад в каждой позиции.
Цепное правило складывает вклады всех применений
Чтобы увидеть производные, зададим вспомогательный скаляр:
\[ J=z_0+z_1+z_2. \]
\(J\) — название этого пробного скаляра, \(t\) — индекс выходной позиции. Запись \(\partial J/\partial z_t\) означает производную \(J\) по этому выходу при фиксированных остальных независимых величинах. Это проверка вычисления, а не функция потерь задачи предсказания. Поскольку \(\partial J/\partial z_t=1\) для каждого \(t\), цепное правило даёт
\[ \begin{aligned} \frac{\partial J}{\partial w_0} &=\sum_{t=0}^{2} \frac{\partial J}{\partial z_t} \frac{\partial z_t}{\partial w_0} =x_0+x_1+x_2=6,\\ \frac{\partial J}{\partial w_1} &=\sum_{t=0}^{2} \frac{\partial J}{\partial z_t} \frac{\partial z_t}{\partial w_1} =x_1+x_2+x_3=9. \end{aligned} \]
Это правило сложения ветвей из недели 04 для повторных применений параметра. Каждый путь вносит чувствительность последующих вычислений, умноженную на локальную производную. Вклады всех путей к общему параметру складываются в один элемент градиента.
import torch
import torch.nn.functional as F

x = torch.tensor([1., 2., 3., 4.])
w = torch.tensor([2., -1.], requires_grad=True)
z = F.conv1d(x.reshape(1, 1, 4), w.reshape(1, 1, 2))
J = z.sum()
J.backward()
torch.testing.assert_close(z.flatten(), torch.tensor([0., 1., 2.]))
torch.testing.assert_close(w.grad, torch.tensor([6., 9.]))
Для произвольной скалярной целевой функции \(\mathcal L\) определим \(\delta_t=\partial\mathcal L/\partial z_t\) — чувствительность к выходу \(z_t\). Аналогичный вывод даёт
\[ \frac{\partial\mathcal L}{\partial w_0} =\delta_0x_0+\delta_1x_1+\delta_2x_2, \qquad \frac{\partial\mathcal L}{\partial w_1} =\delta_0x_1+\delta_1x_2+\delta_2x_3. \]
В отличие от простого примера с \(J\), чувствительности могут различаться по величине и знаку. Одни вклады усиливаются, другие сокращаются. Общие веса объединяют их в одно изменение, не позволяя каждой позиции выбирать независимое обновление.
В примере с ядром ширины 2 параметр \(w_0\) используется в трёх позициях. Обратное распространение создаёт для него три независимо настраиваемых градиента или один? Объясните до открытия ответа.
Показать объяснение
Хранятся один параметр и один элемент градиента. Три пути вносят вклады через цепное правило. Для \(J=z_0+z_1+z_2\) это \(1,2,3\), дающие в сумме \(6\). Независимо настраиваемые элементы отменили бы ограничение общих весов.
Дополнительный взгляд: разреженная матрица со связанными элементами
Ту же операцию можно записать как
\[ \mathbf z=A(\mathbf w)\mathbf x, \qquad A(\mathbf w)= \begin{bmatrix} w_0&w_1&0&0\\ 0&w_0&w_1&0\\ 0&0&w_0&w_1 \end{bmatrix}. \]
\(\mathbf z=(z_0,z_1,z_2)^\top\) объединяет выходы, \(A(\mathbf w)\) — эффективная матрица, определяемая компактным ядром. Нули выражают локальность, повторяющиеся имена параметров — общие веса. Если бы шесть ненулевых элементов были независимыми параметрами, получился бы локально связанный слой с отдельным правилом в каждой позиции. Связывая три вхождения \(w_0\) и три вхождения \(w_1\), получаем свёртку.
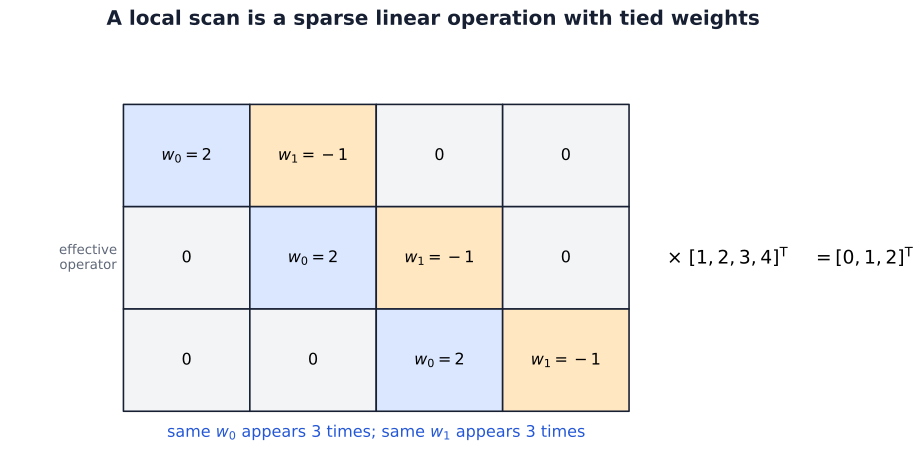
До добавления смещения отображение линейно по входу. Коэффициенты зависят от параметров, поэтому обучение меняет отображение, сохраняя разреженность и связи между элементами. Хранить развёрнутую матрицу для вычисления не требуется.
Правило градиента для батча изображений
Вернёмся к двумерному слою и определим тензор чувствительности преактиваций:
\[ \delta_{n,o,a,c} =\frac{\partial\mathcal L_{\mathcal B}}{\partial z_{n,o,a,c}}. \]
Его форма совпадает с формой \(\mathbf z\). Штрих в \(\phi'(z)\) обозначает скалярную производную активации в точке \(z\). Если за свёрткой следует поэлементная активация, градиент по представлению сначала проходит через её локальную производную:
\[ \delta_{n,o,a,c} =\frac{\partial\mathcal L_{\mathcal B}} {\partial h^{\mathrm{out}}_{n,o,a,c}} \,\phi'(z_{n,o,a,c}). \]
Для коэффициента \(W_{o,i,u,v}\) локальная производная в использующей его позиции равна соответствующему значению дополненного входа. Применим цепное правило ко всем использованиям:
\[ \frac{\partial\mathcal L_{\mathcal B}}{\partial W_{o,i,u,v}} =\sum_{n=0}^{B-1} \sum_{a=0}^{H_{\mathrm{out}}-1} \sum_{c=0}^{W_{\mathrm{out}}-1} \delta_{n,o,a,c}\, \widetilde h_{n,i,a s_H+u,c s_W+v}. \]
Индексы \(o,i,u,v\) фиксированы: производная берётся по одному определённому коэффициенту. Суммы перечисляют его применения по примерам и выходным позициям. Входные каналы здесь не суммируются: \(i\) уже выбрал срез, которому принадлежит коэффициент.
Смещение также общее. Его локальная производная равна единице во всех позициях выходного канала \(o\), поэтому
\[ \frac{\partial\mathcal L_{\mathcal B}}{\partial b_o} =\sum_{n=0}^{B-1} \sum_{a=0}^{H_{\mathrm{out}}-1} \sum_{c=0}^{W_{\mathrm{out}}-1} \delta_{n,o,a,c}. \]
Собрав элементы, получаем градиент весов формы \(\mathbf W\) и градиент смещений формы \(\mathbf b\). Нового принципа дифференцирования не требуется: дополнительные индексы лишь перечисляют применения параметра.
Подробность: усреднение задаётся целевой функцией
Поскольку \(\delta\) определена как производная средней целевой функции батча, множитель усреднения уже входит в неё. Повторное деление градиента на \(B\) внесло бы лишний множитель. Для обычной сети прямого распространения с независимой обработкой примеров можно определить \(d_{n,o,a,c}=\partial\ell_n/\partial z_{n,o,a,c}\). Тогда \(\delta_{n,o,a,c}=d_{n,o,a,c}/B\), и правило принимает вид
\[ \frac{\partial\mathcal L_{\mathcal B}}{\partial W_{o,i,u,v}} =\frac{1}{B}\sum_{n,a,c} d_{n,o,a,c}\, \widetilde h_{n,i,a s_H+u,c s_W+v}. \]
Среднее берётся по примерам. Пространственные вклады продолжают складываться, если целевая функция не задаёт отдельное пространственное усреднение. Ниже появятся операции нормализации, связывающие примеры; общая формула с \(\delta=\partial\mathcal L_{\mathcal B}/\partial\mathbf z\) остаётся верной и в этом случае.
Суммирование вкладов общих весов за один обратный проход — часть производной. Накопление градиентов между несколькими вызовами .backward() — отдельное поведение PyTorch, разобранное на неделе 04. Общие веса не отменяют необходимость очищать сохранённые градиенты перед новым обновлением, когда того требует цикл обучения.
Мы связали локальное вычисление с обучением. Фильтр объединяет окрестность по каналам, сканирование применяет его в разных позициях, а обратное распространение собирает чувствительности в компактный набор параметров. Теперь разберём геометрию: какие окна вычисляются, что происходит на границах и насколько далеко может видеть последовательность локальных операций?
Пространственная геометрия и сдвиги
Прежде чем считать выходы, решим два вопроса: какие значения использовать у границы и на сколько перемещать окно между ответами?
Дополнение задаёт предположение о границе
Внутреннее окно использует наблюдаемые значения. Окну у границы могут понадобиться значения за пределами измеренной области. Свёртка valid исключает такие окна. Дополнение (padding) задаёт недостающие значения по выбранному правилу.
Пусть первые два значения одномерного входа равны 4 и 7. Окну ширины 3 с центром на первом значении нужен элемент слева. Нулевое дополнение даёт \([0,4,7]\). Отражение без повторения крайнего элемента даёт \([7,4,7]\). Усредняющий фильтр вернёт \(11/3\) или \(6\). Измерения и фильтр одинаковы; ответ меняется из-за предположения о границе.
Ширина дополнения определяет количество возможных начал окон, а правило заполнения — содержимое граничных окон. Для ядра ширины 3 с шагом один дополнение по одному значению с каждой стороны сохраняет размер. В общем случае дополнение не обязано сохранять размер.
Нулевое дополнение может позволить сети отличать границы от внутренней области. Общие пространственные веса не устраняют все признаки абсолютного положения. Если граница важна для задачи, правило дополнения — часть спецификации модели.
Шаг выбирает начала окон
Шаг (stride) — расстояние между последовательными началами окон. Шаг один перебирает соседние начала, шаг два пропускает каждое второе по каждой пространственной оси. Веса прежние, но сетка выхода становится грубее. Дополнение меняет доступную область, шаг — места её выборки.
Размер выхода считает допустимые начала окон
Рассмотрим ось длины \(T\), ядро ширины \(k\), симметричное дополнение \(p\) с каждой стороны и шаг \(s\). Элементы ядра соседние: dilation равна единице. Длина дополненного входа равна \(T+2p\). Начала окон: \(0,s,2s,\ldots\). Полное окно ширины \(k\) с началом \(a s\) помещается, если
\[ a s+k\le T+2p. \]
Поэтому наибольший неотрицательный индекс выхода равен \(\lfloor(T+2p-k)/s\rfloor\). Учитывая и начальный индекс ноль, получаем
\[ T_{\mathrm{out}} =\left\lfloor\frac{T+2p-k}{s}\right\rfloor+1. \]
Предполагается \(T+2p\ge k\), то есть помещается хотя бы одно полное окно. Скобки \(\lfloor q\rfloor\) означают наибольшее целое, не превосходящее \(q\). Округление вниз нужно, когда последний возможный старт не совпадает с сеткой шага. Оставшаяся входная позиция сама по себе не создаёт выход: целое окно должно поместиться.
Применим рассуждение независимо к обеим осям изображения:
\[ \begin{aligned} H_{\mathrm{out}}&=\left\lfloor\frac{H+2p_H-k_H}{s_H}\right\rfloor+1,\\ W_{\mathrm{out}}&=\left\lfloor\frac{W+2p_W-k_W}{s_W}\right\rfloor+1. \end{aligned} \]
Это вывод случая dilation один из правила форм Conv2d. Каналы и размер батча не входят в пространственный расчёт.
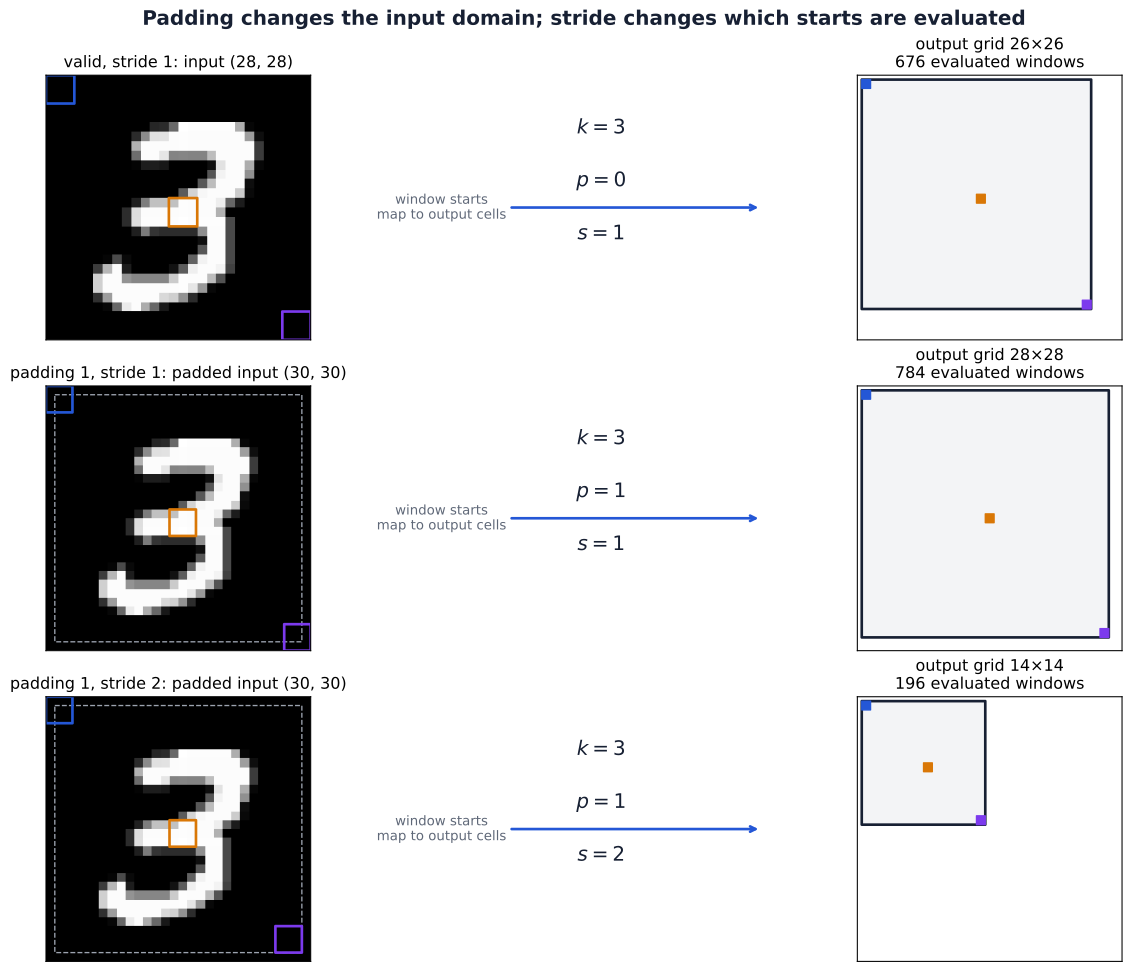
Для изображения \(28\times28\) и ядра \(3\times3\) в практикуме проверяются три случая:
| Дополнение с каждой стороны | Шаг | Начала по дополненной оси | Пространственная форма выхода |
|---|---|---|---|
| \(p=0\) | 1 | \(0,1,\ldots,25\) | \((26,26)\) |
| \(p=1\) | 1 | \(0,1,\ldots,27\) | \((28,28)\) |
| \(p=1\) | 2 | \(0,2,\ldots,26\) | \((14,14)\) |
В двух последних случаях длина дополненной оси равна 30. Начало ноль в дополненных координатах соответствует \(-1\) в исходных. Дополнение меняет и набор окон, и их положение относительно измеренного изображения. Шаг выбирает, какие из этих окон вычисляются.
Общие веса дают эквивариантность к сдвигу
Пусть \(T_{\Delta}\) сдвигает вход на целое смещение \(\Delta=(\Delta_H,\Delta_W)\). \(\Delta_H,\Delta_W\) — смещения по строкам и столбцам, \(T_\Delta\) — операция сдвига. Для идеализированного изображения на всей целочисленной сетке
\[ (T_{\Delta}\mathbf h)_{a,c} =h_{a-\Delta_H,c-\Delta_W}. \]
Для ясности рассмотрим один канал и фильтрацию \(\mathcal C\) с общими весами, смещением и шагом один. Тогда
\[ \begin{aligned} \bigl[\mathcal C(T_{\Delta}\mathbf h)\bigr]_{a,c} &=b+\sum_{u,v}W_{u,v} h_{a+u-\Delta_H,c+v-\Delta_W}\\ &=(\mathcal C\mathbf h)_{a-\Delta_H,c-\Delta_W}. \end{aligned} \]
Суммы перебирают смещения ядра. Сдвинутый вход предъявляет те же локальные значения тем же коэффициентам в соответственно сдвинутой позиции. Поэтому
\[ \mathcal C(T_{\Delta}\mathbf h) =T_{\Delta}(\mathcal C\mathbf h). \]
Это эквивариантность к сдвигу: преобразование входа предсказуемо преобразует выход. Поэлементная активация также коммутирует со сдвигом, поэтому сама ReLU не разрушает это свойство при шаге один. Рассуждение переносится на несколько каналов: каждый локальный вклад следует тому же сдвигу координат.
Реальное изображение конечно. Точное соответствие требует совпадающих окон и совместимого правила границ; обрезка, новое дополнение или выход структуры за пределы изображения могут его нарушить. В области, где сравниваемые окна содержат одинаковые сдвинутые измерения, локальное рассуждение сохраняется.
Инвариантность к сдвигу задаётся другим равенством. Для классификатора \(g\) без пространственных координат на выходе желаемое свойство может иметь вид
\[ g(T_{\Delta}\mathbf X)=g(\mathbf X). \]
Эквивариантная карта сохраняет положение структуры, перемещая её отклик. Инвариантная оценка класса устраняет это различие. Для классификации такая устойчивость может быть полезна; локализации объекта или разметке каждого пикселя обычно нужен выход, следующий за положением. Нужное свойство определяется задачей.
Вдали от границ сдвиг изображения даёт такой же сдвиг карты под общим фильтром с шагом один. Это эквивариантность или инвариантность? Должна ли система локализации оставлять отклик на старом месте?
Показать объяснение
Это эквивариантность: выход следует за сдвигом входа. При инвариантности выход остался бы прежним. Локализации нужна информация о новом положении объекта; неизменные координаты указывали бы старое место. Для классификатора полезными могут быть устойчивые оценки классов после подходящего объединения признаков.
Шаг меняет соответствие при сдвиге
Операция с шагом 2 выбирает начала \(0,2,4,\ldots\). Сдвиг структуры на две входные позиции совмещает её со следующим окном и соответствует одному шагу выхода вдали от границ. Сдвиг на одну позицию меняет совмещение с сеткой выборки.
Простейший контрпример использует ядро ширины один со значением один и шагом 2. Для
\[ \mathbf x=[0,1,0,0,0,0], \]
выход равен \([0,0,0]\). Сдвинем вход на одну позицию вправо, получая \([0,0,1,0,0,0]\); выход станет \([0,1,0]\). Сдвиг нулевого выхода не может дать ненулевой. Поэтому равенство эквивариантности для шага один нельзя переносить на любой однопозиционный сдвиг после прореживания.
Шаг уменьшает число вычисляемых окон и разрешение выхода. Даже при общих весах небольшое изменение положения может стать существенным. В стеке слоёв согласованные входные сдвиги определяются произведением шагов.
Пулинг объединяет область и теряет расположение
Свёртка вычисляет обучаемую взвешенную сумму. Пулинг (pooling) применяет фиксированное обобщение к окну, обычно независимо в каждом канале. Для окна \(2\times2\) без дополнения максимальный и средний пулинг равны
\[ \operatorname{MaxPool}(\mathbf P)=\max_{u,v}P_{u,v}, \qquad \operatorname{AvgPool}(\mathbf P)=\frac{1}{4}\sum_{u,v}P_{u,v}. \]
Обе операции не добавляют обучаемых параметров. Пулинг \(2\times2\) с шагом 2 превращает карту \(28\times28\) в \(14\times14\), сохраняя число каналов. Здесь применим подсчёт полных окон с округлением вниз. У других настроек свои соглашения: например, дополнение max pooling в PyTorch использует минус бесконечность вместо нулей свёртки. См. MaxPool2d.
Max pooling сравнивает значения со знаком, а не модули: если все элементы отрицательны, он выберет наименее отрицательный.
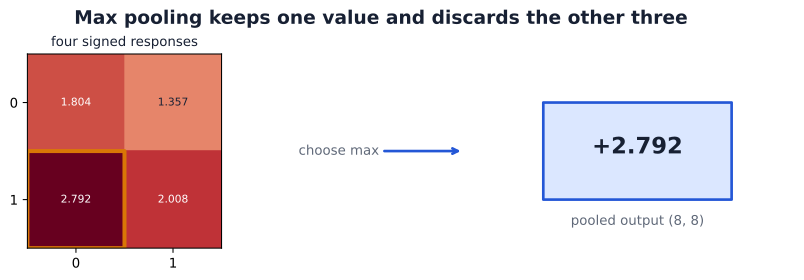
Максимум и среднее не меняются при перестановке элементов внутри одного окна. Внутреннее расположение теряется, но перенос через границу окна может изменить выход. Например, max pooling ширины 2 с шагом 2 переводит \([0,3,2,0]\) в \([3,2]\). Сдвиг вправо на одну позицию даёт \([0,0,3,2]\) и выход \([0,3]\). Локальный пулинг не гарантирует инвариантных предсказаний.
У пулинга есть и обратное вычисление. При единственном максимуме входящая чувствительность передаётся победившему элементу, остальные получают от этого выхода ноль. Среднее четырёх элементов без дополнения распределяет чувствительность поровну — по четверти. При совпадении максимумов возникает недифференцируемость, требующая соглашения реализации. Это те же правила локальных производных и сложения ветвей из недели 04.
Глубина расширяет структурные рецептивные поля
Биологическое рецептивное поле определялось по измеренному отклику. В CNN можно спросить о возможной зависимости ещё до наблюдения отклика. Структурное рецептивное поле описывает область входа, способную влиять на один выход через связи архитектуры. Слой ширины 3 использует три позиции. Следующий локальный слой объединяет несколько таких выходов, расширяя зависимость без глобальных связей в каждом отдельном слое.
В двухслойном одномерном примере первый слой имеет ширину 3 и шаг 1. Его первые два выхода зависят от \(\{0,1,2\}\) и \(\{1,2,3\}\). Второй слой ширины 2 с шагом 2 объединяет эти выходы. Его первый выход зависит от объединения \(\{0,1,2,3\}\): четырёх различных позиций, а не шести. Следующий объединяет позиции 2 и 3 первого слоя, завися от \(\{2,3,4,5\}\).
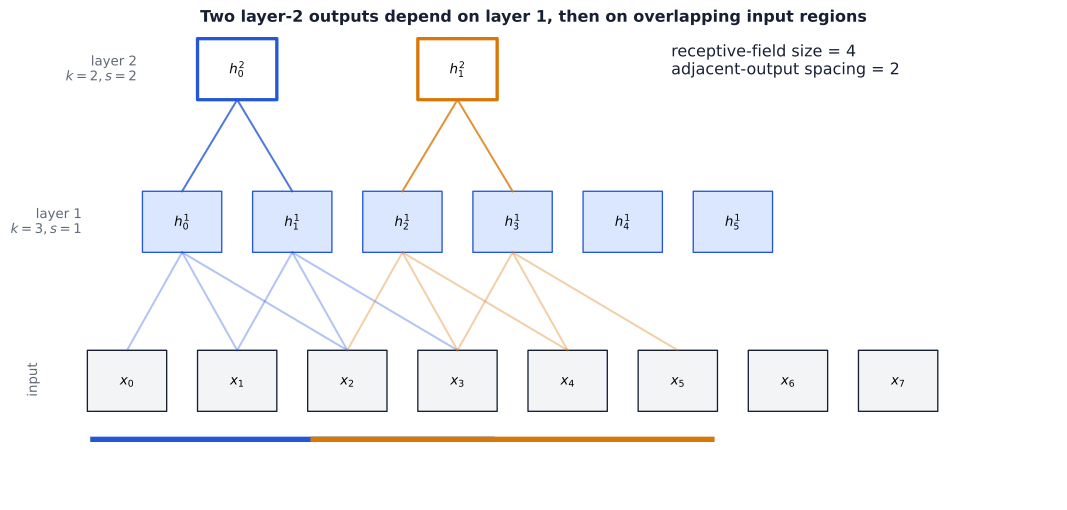
Будем отслеживать две величины по одной оси: \(r_\ell\) — протяжённость рецептивного поля во входных координатах, \(j_\ell\) — расстояние в этих координатах между соседними выходами слоя \(\ell\). Вначале позиция видит себя, поэтому \(r_0=j_0=1\).
Окно ширины \(k_\ell\) охватывает \(k_\ell\) позиций предыдущего слоя. Между первым и последним началами расстояние \((k_\ell-1)j_{\ell-1}\), а последняя позиция уже имеет протяжённость \(r_{\ell-1}\). Шаг \(s_\ell\) умножает расстояние между вычисляемыми началами. Для последовательного локального пути при dilation один:
\[ \begin{aligned} r_\ell&=r_{\ell-1}+(k_\ell-1)j_{\ell-1},\\ j_\ell&=s_\ell j_{\ell-1}. \end{aligned} \]
| Этап | Ширина ядра | Шаг | Протяжённость \(r\) | Расстояние \(j\) |
|---|---|---|---|---|
| Вход | — | — | 1 | 1 |
| Первый слой | 3 | 1 | 3 | 1 |
| Второй слой | 2 | 2 | 4 | 2 |
Здесь зависимости заполняют весь диапазон из четырёх позиций. В общем случае внутри диапазона могут быть пропуски: \(r\) описывает протяжённость, не обязательно число связанных измерений. Дополнение может вывести часть номинального диапазона за измеренное изображение и меняет его положение, не меняя рекуррентную формулу протяжённости. В выводе Araujo, Norris и Sim подробно рассматриваются позиции и более общие графы вычислений; обратная индексация там описывает ту же геометрию другим соглашением.
Структурная доступность не равна измеренному влиянию. Нулевые веса, неактивные ReLU и выбор max pooling могут дать нулевую локальную производную для части связанных входов на конкретном примере. Глобальное объединение и смешивание позиций или примеров требуют более широкого анализа. В частности, обучающий BatchNorm связывает позиции через статистики; одна локальная рекуррентная формула этого не описывает.
Для изображений применяйте формулу отдельно к высоте и ширине. Глубина объединяет локальные свидетельства из всё более крупных областей, а шаг управляет плотностью выборки этих областей.
От локальных признаков к логитам классов
Локальный детектор ещё не классификатор. Нужно объединить локальные признаки, обобщить их по изображению и получить оценки классов. У каждого шага своя роль: свёртки строят карты, активации делают их композицию нелинейной, пулинг уменьшает пространственную детализацию, а голова связывает представление с задачей.
Полная архитектура: формы и параметры
Небольшой классификатор практикума получает полутоновые изображения \(28\times28\). Первая свёртка строит восемь карт активаций; max pooling вдвое уменьшает их пространственные размеры; вторая свёртка строит шестнадцать карт. Глобальное усреднение даёт один скаляр на канал, а обучаемая линейная голова — \(K=10\) логитов.
| Этап | Форма выхода | Обучаемые параметры |
|---|---|---|
| Вход | \((B,1,28,28)\) | 0 |
| Свёртка \(3\times3\), дополнение 1 | \((B,8,28,28)\) | 80 |
| ReLU | \((B,8,28,28)\) | 0 |
| Max pooling \(2\times2\), шаг 2 | \((B,8,14,14)\) | 0 |
| Свёртка \(3\times3\), дополнение 1 | \((B,16,14,14)\) | 1168 |
| ReLU | \((B,16,14,14)\) | 0 |
| Глобальное усреднение | \((B,16,1,1)\) | 0 |
| Развёртка каждого примера | \((B,16)\) | 0 |
| Линейная голова | \((B,10)\) | 170 |
Вторая свёртка показывает роль входных каналов. У неё шестнадцать фильтров, каждый объединяет восемь входных каналов:
\[ 16(8\cdot3\cdot3+1)=1168. \]
Всего у модели 1 418 обучаемых параметров. Пулинг и активации меняют вычисление без добавления обучаемых коэффициентов.
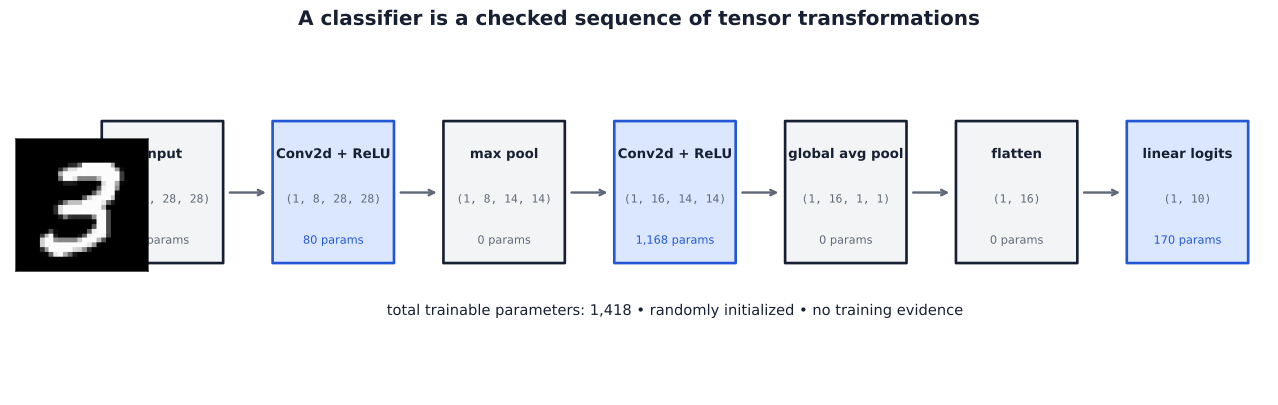
Следующая композиция реализует те же операции, что и модель практикума:
import torch
from torch import nn

torch.manual_seed(202606)
model = nn.Sequential(
    nn.Conv2d(1, 8, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.MaxPool2d(kernel_size=2, stride=2),
    nn.Conv2d(8, 16, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.AdaptiveAvgPool2d((1, 1)),
    nn.Flatten(start_dim=1),
    nn.Linear(16, 10),
)
logits = model(torch.zeros(2, 1, 28, 28))
assert logits.shape == (2, 10)
assert sum(p.numel() for p in model.parameters()) == 1418
Нулевой вход делает это проверкой формы. Веса ещё не обучены. Flatten(start_dim=1) сохраняет отдельную ось батча; развёртка всех осей ошибочно объединила бы примеры в один вектор.
Глобальное усреднение связывает карты с логитами
Пусть конечный тензор активаций имеет форму \((B,C,H',W')\), где \(H',W'\) — пространственные размеры. Глобальное среднее строит вектор \(\mathbf g_n\in\mathbb R^C\) для каждого примера:
\[ g_{n,o}=\frac{1}{H'W'} \sum_{a=0}^{H'-1}\sum_{c=0}^{W'-1}h_{n,o,a,c}. \]
Каждый канал усредняется отдельно. Операция сохраняет обобщённую силу отклика, но отбрасывает положение откликов внутри карты. AdaptiveAvgPool2d((1,1)) даёт ровно одну пространственную ячейку на канал; см. форму адаптивного выхода.
Для примера, представленного вектором-столбцом, обучаемая голова вычисляет
\[ \mathbf z_n^{\mathrm{head}} =\mathbf W^{\mathrm{head}}\mathbf g_n+\mathbf b^{\mathrm{head}}, \qquad \mathbf W^{\mathrm{head}}\in\mathbb R^{K\times C}. \]
Каждый класс получает обученную комбинацию сводных признаков каналов. Каналы не являются метками классов: здесь шестнадцать признаков и десять логитов. Для батча голова возвращает \((B,K)\) в соответствии с расположением примеров по строкам из недели 04. Логиты можно напрямую передать многоклассовой кросс-энтропии из той главы; дополнительная ReLU или Softmax после линейной головы для этой функции потерь не требуется.
Перестановка пространственных элементов карты не меняет её среднее. Если преобразование входа только переставляет значения каждой конечной карты, вектор и логиты не изменятся. Однако сдвиг входа может менять сами значения из-за границ и выборки с шагом. Инвариантность среднего к перестановке карты — условный путь к устойчивости, а не гарантия для любого сдвинутого изображения.
Среднее не восстанавливает утраченное расположение. Карты с одинаковыми средними по каналам могут иметь максимальные отклики в разных областях, но давать одинаковые логиты. Для классификации это может быть полезно; задаче с точной локализацией нужно сохранять пространственную информацию в другой части архитектуры.
Проследим локальный охват до глобальной операции
Применим рекуррентную формулу к одной оси небольшой CNN, пропуская поэлементные ReLU, которые не расширяют структурный охват:
| Этап | Ширина ядра | Шаг | Протяжённость \(r\) | Расстояние \(j\) |
|---|---|---|---|---|
| Вход | — | — | 1 | 1 |
| Первая свёртка | 3 | 1 | 3 | 1 |
| Max pooling | 2 | 2 | 4 | 2 |
| Вторая свёртка | 3 | 1 | 8 | 2 |
Одна позиция последней свёртки имеет номинальный охват \(8\times8\), а соседние позиции разделены двумя исходными пикселями. У границ часть охвата приходится на дополнение. Шестнадцать каналов в позиции объединяют разные выученные соотношения в одной пространственной области.
Классификатор не ограничен таким фрагментом. Глобальное среднее использует все \(14\times14\) позиций каждого конечного канала, собирая признаки по изображению. В этой архитектуре объединение локальных зависимостей покрывает весь измеренный вход. Речь идёт о возможных связях: на конкретном примере ReLU и победители max pooling могут оставить часть пикселей с нулевым локальным градиентом.
Для обученной иерархии недостаточно прямого прохода
Глубина позволяет поздним фильтрам объединять предыдущие представления, а не вновь анализировать исходные интенсивности. Ранний канал может откликаться на локальный контраст; следующий фильтр объединяет несколько каналов и соседние позиции. Это объясняет возможность иерархии признаков, но не присваивает каждому каналу понятное имя и не доказывает полезность признаков необученной сети.
В следующем примере используется MobileNetV3-Small, предобученная на ImageNet. Цифра 3 повторена в трёх каналах, приведена к нужному размеру и нормализована для этой модели. На каждой глубине выбраны шесть каналов по среднему модулю активации. Это отдельная предобученная модель, а не небольшой классификатор выше.
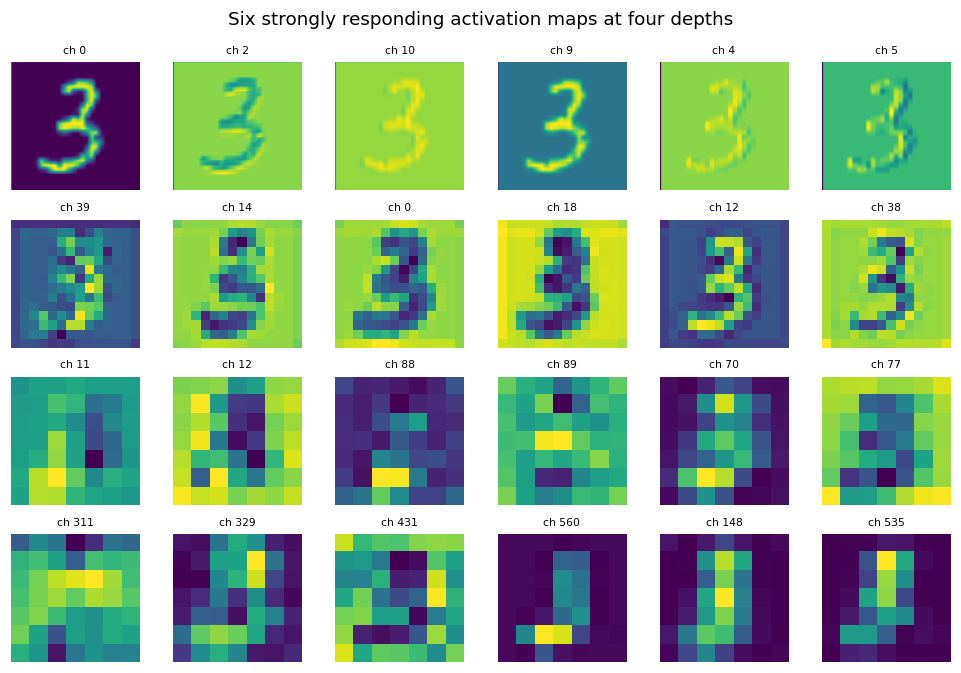
Ранние карты сохраняют мелкие детали, поздние имеют меньшее разрешение и другие рисунки отклика. Высокая активация сама по себе не означает детектор определённой части объекта. Показаны выбранные каналы; яркость отдельно отображаемых карт не является калиброванным сравнением силы откликов. Рукописная цифра также отличается от естественных изображений предобучения.
Проверка формы устанавливает согласованность вычисления. Карта активаций показывает отклик конкретной модели. Оценка на отложенных данных проверяет предсказания. Это разные вопросы о представлении.
Та же конструкция работает в других размерностях
Число в Conv1d, Conv2d и Conv3d считает оси скольжения локального ядра, а не полный ранг входного тензора. Каналы по-прежнему обозначают разные измерения или выученные признаки в каждой позиции.
| Операция | Оси батча | Пространственные оси | Пример |
|---|---|---|---|
| Conv1d | \((B,C,T)\) | Одна | Многоканальный дискретный сигнал |
| Conv2d | \((B,C,H,W)\) | Две | RGB-изображение |
| Conv3d | \((B,C,D,H,W)\) | Три | Объём или сетка видео |
\(D\) здесь — третья пространственная протяжённость, например глубина объёма или время видео; это обозначение локально для таблицы. Многоканальный временной ряд может использовать Conv1d: ось каналов объединяется внутри фильтра, а не сканируется как пространственная. Фильтр Conv3d перемещается по трём пространственным координатам и в каждой окрестности объединяет все каналы.
Архитектурная гипотеза прежняя: соседние значения взаимодействуют, полезное локальное правило повторяется в разных местах. Позже проверим её на одномерной синтетической задаче MNIST-1D. Сначала разберём другой вопрос: как сохранить возможность обучения при увеличении глубины свёрточной композиции?
Как обучать более глубокие модели
AlexNet: согласованная система решений
Небольшая CNN показала путь от локальных признаков к классификатору. Масштабирование требует решений об оптимизации, регуляризации и вычислениях. AlexNet объединила пять свёрточных и три полносвязных слоя с ReLU, обучением на GPU, аугментацией, weight decay и dropout. Результат на ImageNet в 2012 году продемонстрировал практическую ценность большой свёрточной модели на крупной размеченной выборке (Krizhevsky и др. 2012 г.).
У решений разные роли. На положительной области производная ReLU равна единице: там нет малых производных насыщенной сигмоиды. На отрицательной области ReLU всё ещё блокирует градиент. Аугментация меняет обучающие примеры; weight decay ограничивает рост параметров; dropout случайно подавляет активации при обучении. Их действие оценивается вместе с данными и процедурой обучения. Успешная историческая конфигурация описывает конкретный эксперимент, а не обязательный набор компонентов для любой зрительной задачи.
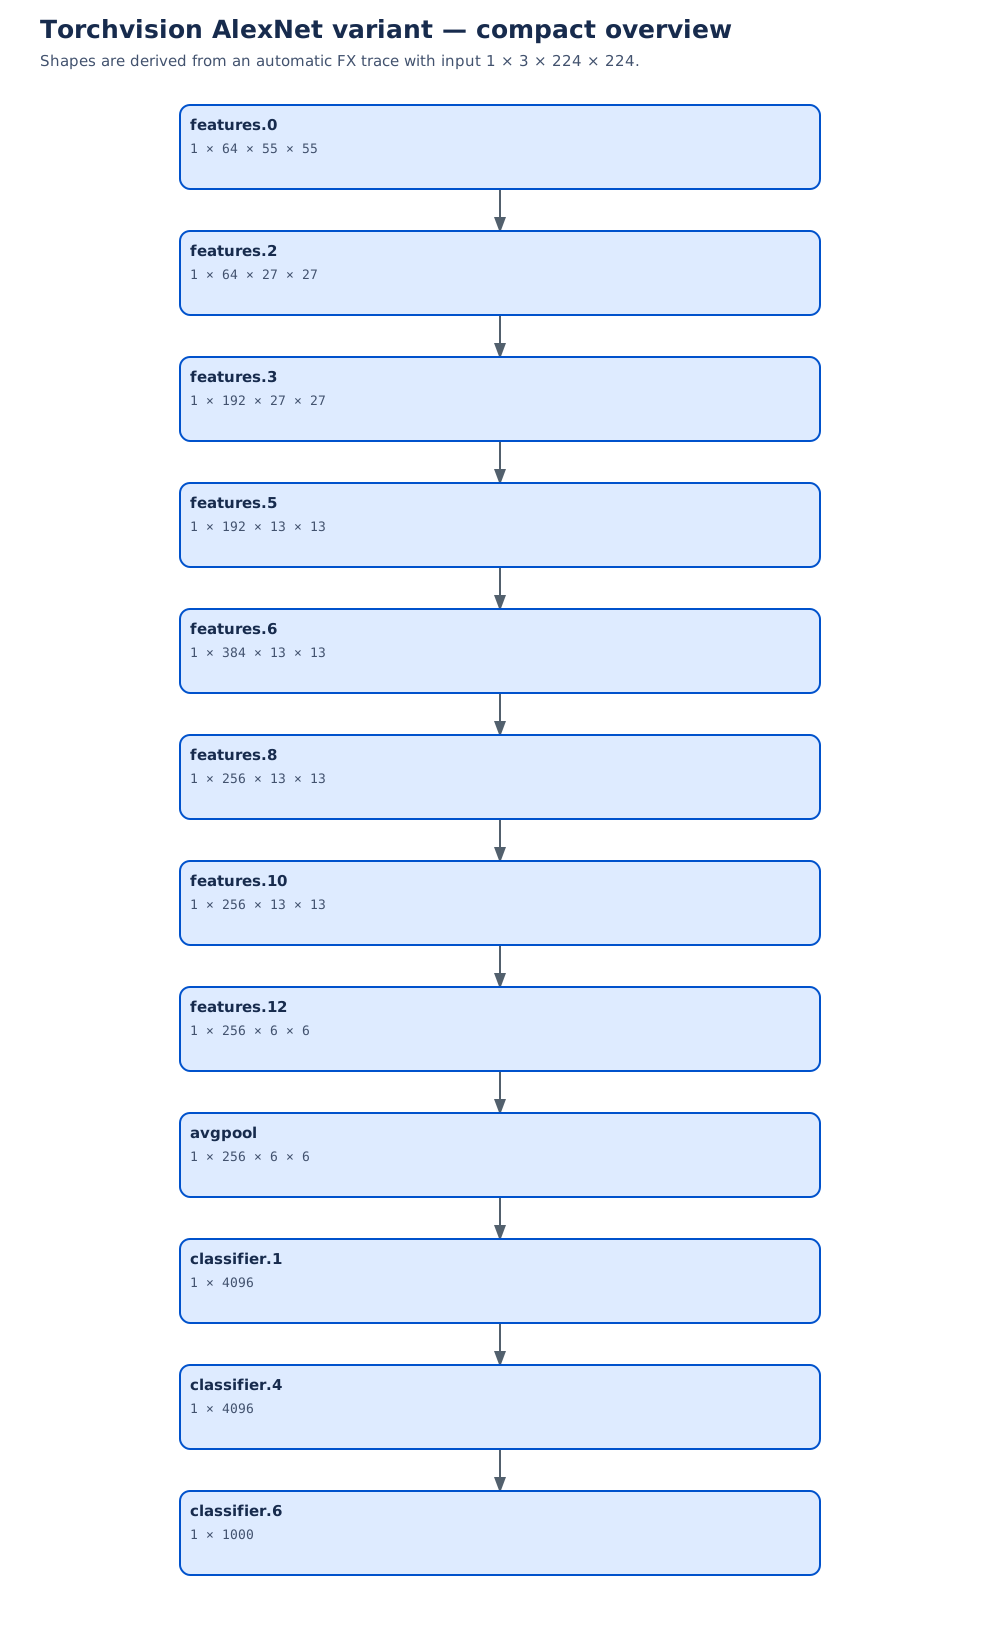
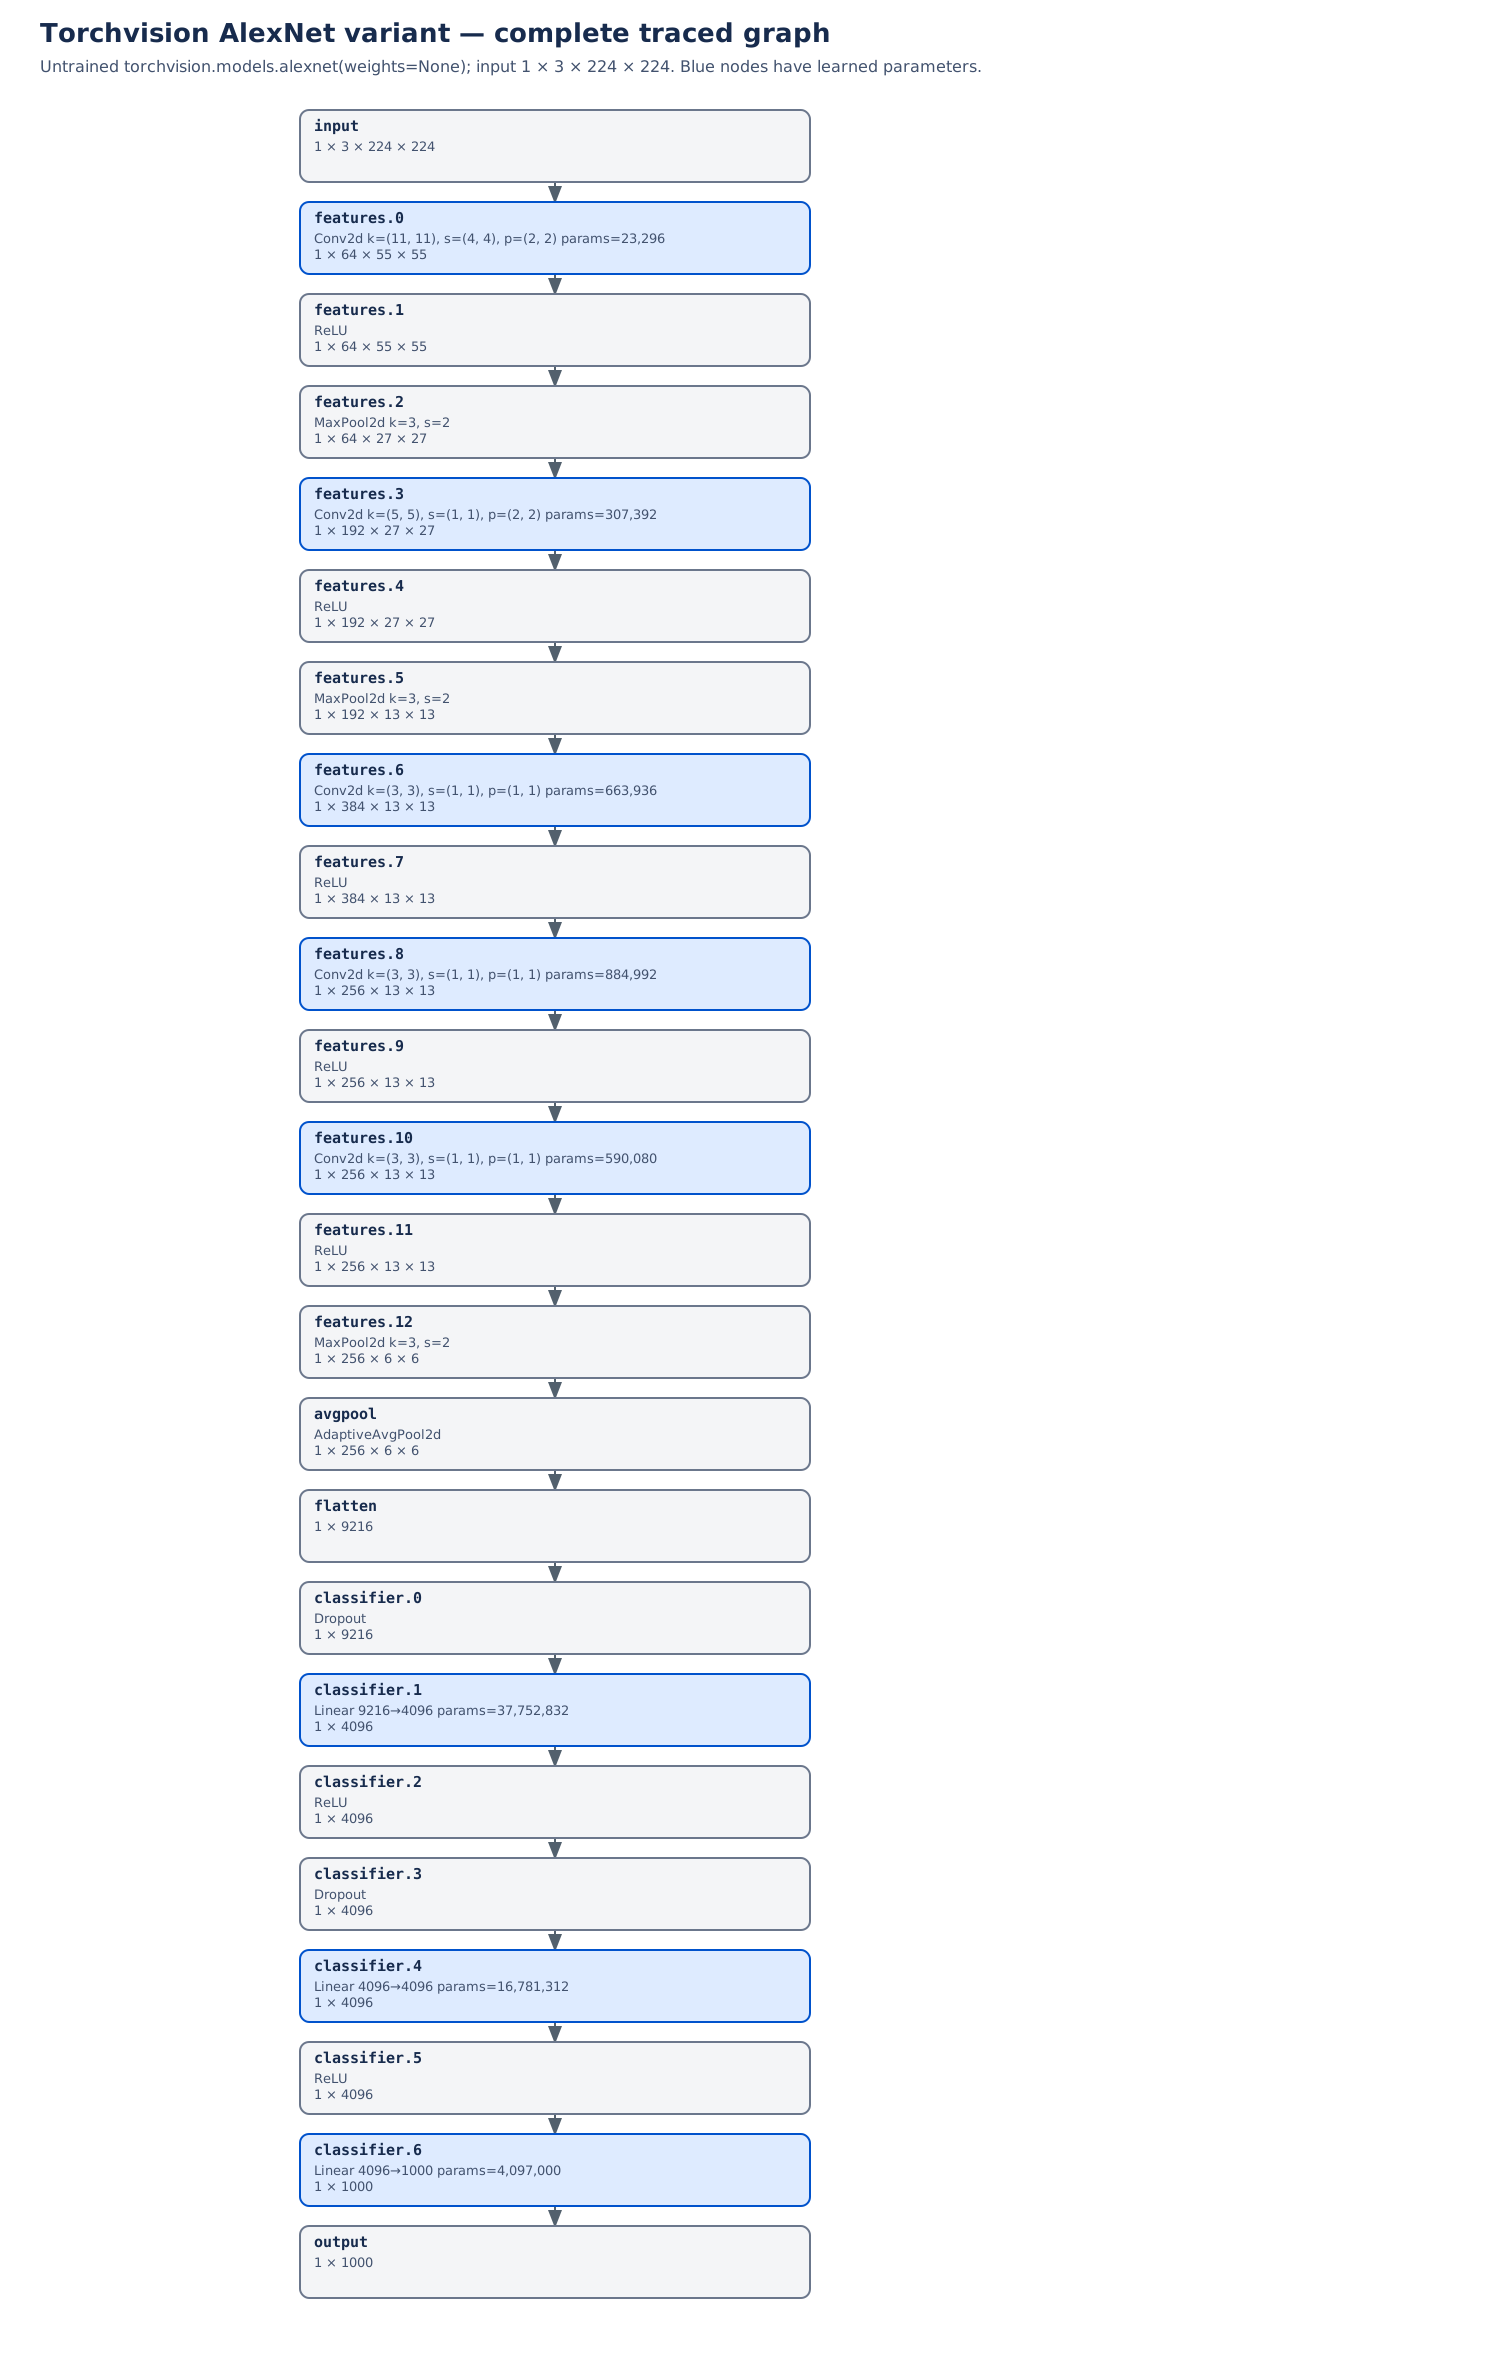
Полный граф AlexNet показывает отдельные операции и число параметров. Это библиотечный вариант из практикума, а не точное воспроизведение исходной модели для двух GPU:
| Деталь | Исходная статья | Вариант Torchvision |
|---|---|---|
| Числа каналов пяти свёрток | 96, 256, 384, 384, 256 | 64, 192, 384, 256, 256 |
| Локальная нормализация отклика | Есть | Нет |
| Историческое разделение по GPU | Ограничивало часть связей каналов | Соответствующего разделения нет |
Историческая модель описана в статье, показанная реализация — в исходном коде Torchvision. Локальная нормализация отклика отличается от BatchNorm ниже; похожие названия не делают операции взаимозаменяемыми.
Проблема деградации
Большая выразительная способность не гарантирует, что оптимизатор найдёт лучшее решение. Статья ResNet показала деградацию: у некоторых глубоких обычных сетей обучающая ошибка была выше, чем у более мелких (He и др. 2016 г.). Это отличается от простого переобучения, когда качество на обучении улучшается, а на отложенных данных ухудшается.
Почему это удивительно? Допустим, дополнительные блоки имеют совместимые формы и способны представить тождественное отображение на получаемых представлениях. Скопируем преобразования мелкой модели, а новым блокам поручим пропускать вход без изменений. Глубокая сеть вычислит ту же функцию. При этих предположениях не худшее решение существует; найти его — отдельная задача оптимизации. Условие существенно: блок, меняющий размерность или необратимо теряющий информацию, не может просто скопировать все входные координаты.
Обычная последовательность требует выучить пропускание через параметры преобразований. Остаточное обучение явно добавляет прямой путь. Вопрос становится таким: насколько блок должен изменить свой вход?
Выучить поправку к входу
Для блока с одинаковыми формами входа и выхода определим
\[ \mathbf y=\mathbf x+F(\mathbf x;\theta_F). \]
\(\mathbf x\) — вход блока, \(\mathbf y\) — сумма, а не целевая метка. \(F\) — обучаемая остаточная ветвь, \(\theta_F\) — её параметры, часть общего \(\theta\). Если желаемое отображение равно \(G(\mathbf x)\), ветви нужно выдать \(G(\mathbf x)-\mathbf x\). Нулевая ветвь делает сумму равной входу.
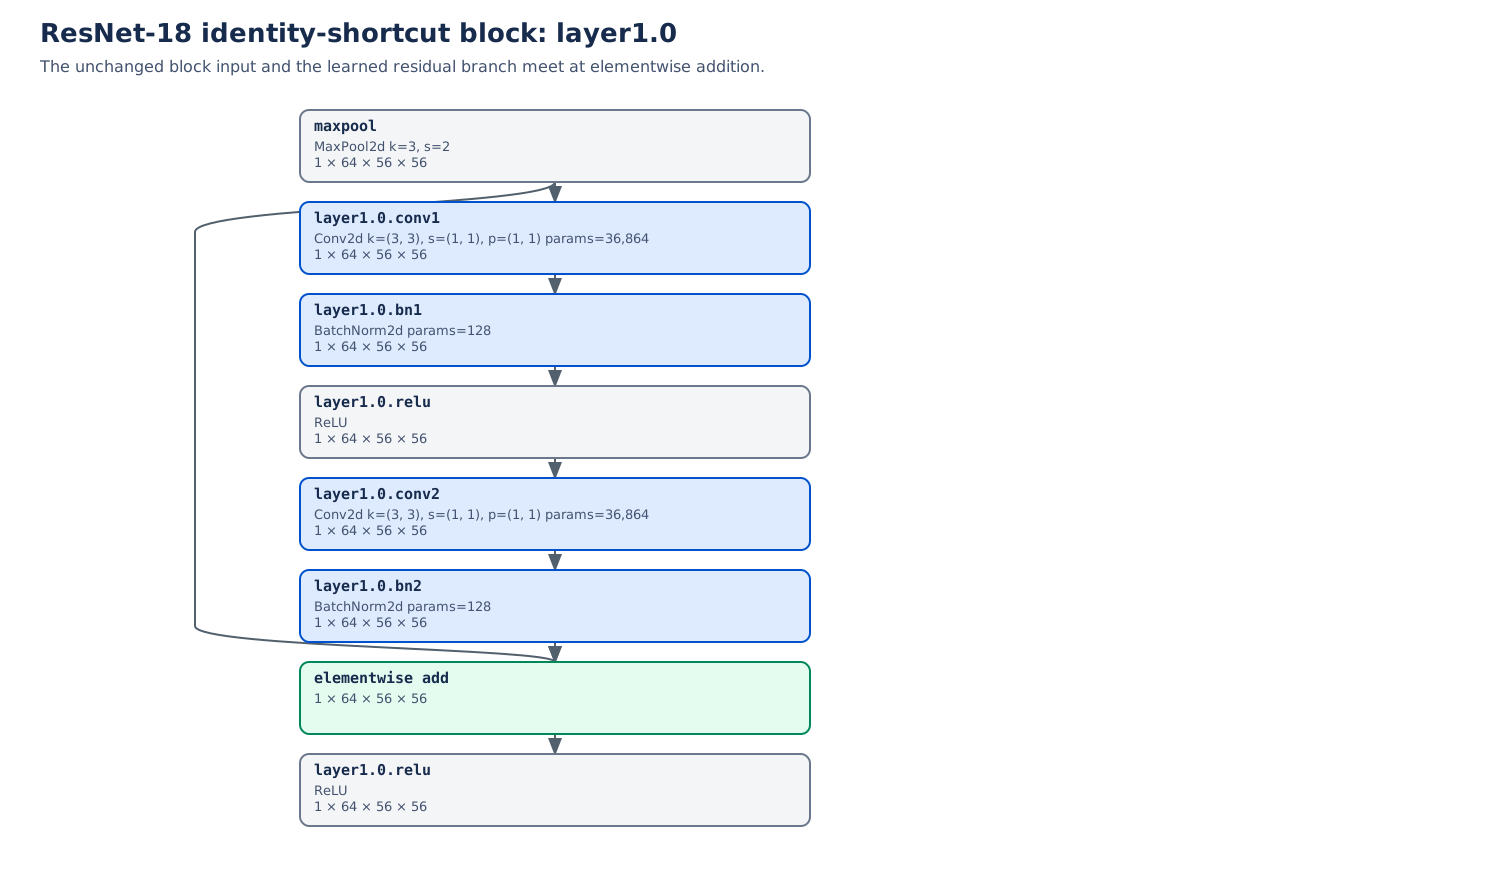
После сложения на схеме стоит ReLU, поэтому полный выход блока — \(\mathbf h=\phi(\mathbf y)\). Нулевая ветвь даёт \(\phi(\mathbf x)\): это равно \(\mathbf x\) на неотрицательных входах, но обрезает отрицательные координаты. Разделение суммы и активации не позволяет ошибочно считать весь блок безусловно тождественным.
Обходной путь и ветвь складываются поэлементно, а не конкатенируются по каналам. Два тензора \((B,64,56,56)\) дают один тензор той же формы. Тождественный путь не добавляет обучаемых параметров, хотя само сложение требует вычислений.
Выведем градиент через оба пути
Для производных развернём соответствующие координаты тензоров в столбцы. Пусть \((\mathbf J_F)_{ij}=\partial F_i/\partial x_j\) — элементы якобиана. Единичная матрица \(\mathbf I\) имеет единицы на диагонали и нули вне её. Для суммы:
\[ \frac{\partial\mathbf y}{\partial\mathbf x} =\mathbf I+\mathbf J_F. \]
\(\nabla_{\mathbf y}\) собирает производные по всем координатам \(\mathbf y\) в градиент-столбец. Если \(\mathbf g_y=\nabla_{\mathbf y}\mathcal L_{\mathcal B}\) — градиент последующих вычислений, цепное правило даёт
\[ \nabla_{\mathbf x}\mathcal L_{\mathcal B} =(\mathbf I+\mathbf J_F)^\top\mathbf g_y =\mathbf g_y+\mathbf J_F^\top\mathbf g_y. \]
Это правило ветвей недели 04: перемножать вдоль пути, затем складывать вклады. Прямой путь вносит \(\mathbf g_y\), минуя внутренние производные ветви. Сама ветвь продолжает получать градиенты и обучаться; обход не отменяет потери и оптимизатор.
Для последующей ReLU определим \(\mathbf D_\phi\) — диагональную матрицу покоординатных производных вне нуля. При \(\mathbf g_h=\nabla_{\mathbf h}\mathcal L_{\mathcal B}\):
\[ \nabla_{\mathbf x}\mathcal L_{\mathcal B} =(\mathbf I+\mathbf J_F)^\top\mathbf D_\phi\mathbf g_h. \]
Вентиль активации действует до разделения градиента между путями. Уже у суммы единичный вклад может сокращаться или усиливаться ветвью. Для скалярной ветви \(F(x)=ax\) производная равна \(1+a\): единице при \(a=0\), нулю при \(a=-1\), трём при \(a=2\). Остаточный путь помогает оптимизации, но не гарантирует сходимость и не устраняет все случаи затухания или взрыва градиентов.
Согласовать формы при смене этапа
При переходе между этапами разрешение часто уменьшается, а число каналов растёт. Тождественный обход не может сложить вход \((B,64,56,56)\) с ветвью \((B,128,28,28)\). Введём обходное отображение \(S\):
\[ \mathbf y=S(\mathbf x)+F(\mathbf x;\theta_F), \qquad \operatorname{shape}(S(\mathbf x)) =\operatorname{shape}(F(\mathbf x)). \]
Упрощённая линейная проекция в статье записана как \(S(\mathbf x)=\mathbf W_s\mathbf x\). В показанном переходе Torchvision это свёртка \(1\times1\) с шагом два и последующая BatchNorm. Она обучает комбинации каналов и выбирает более грубую сетку. Её параметры и состояние нормализации также принадлежат модели.
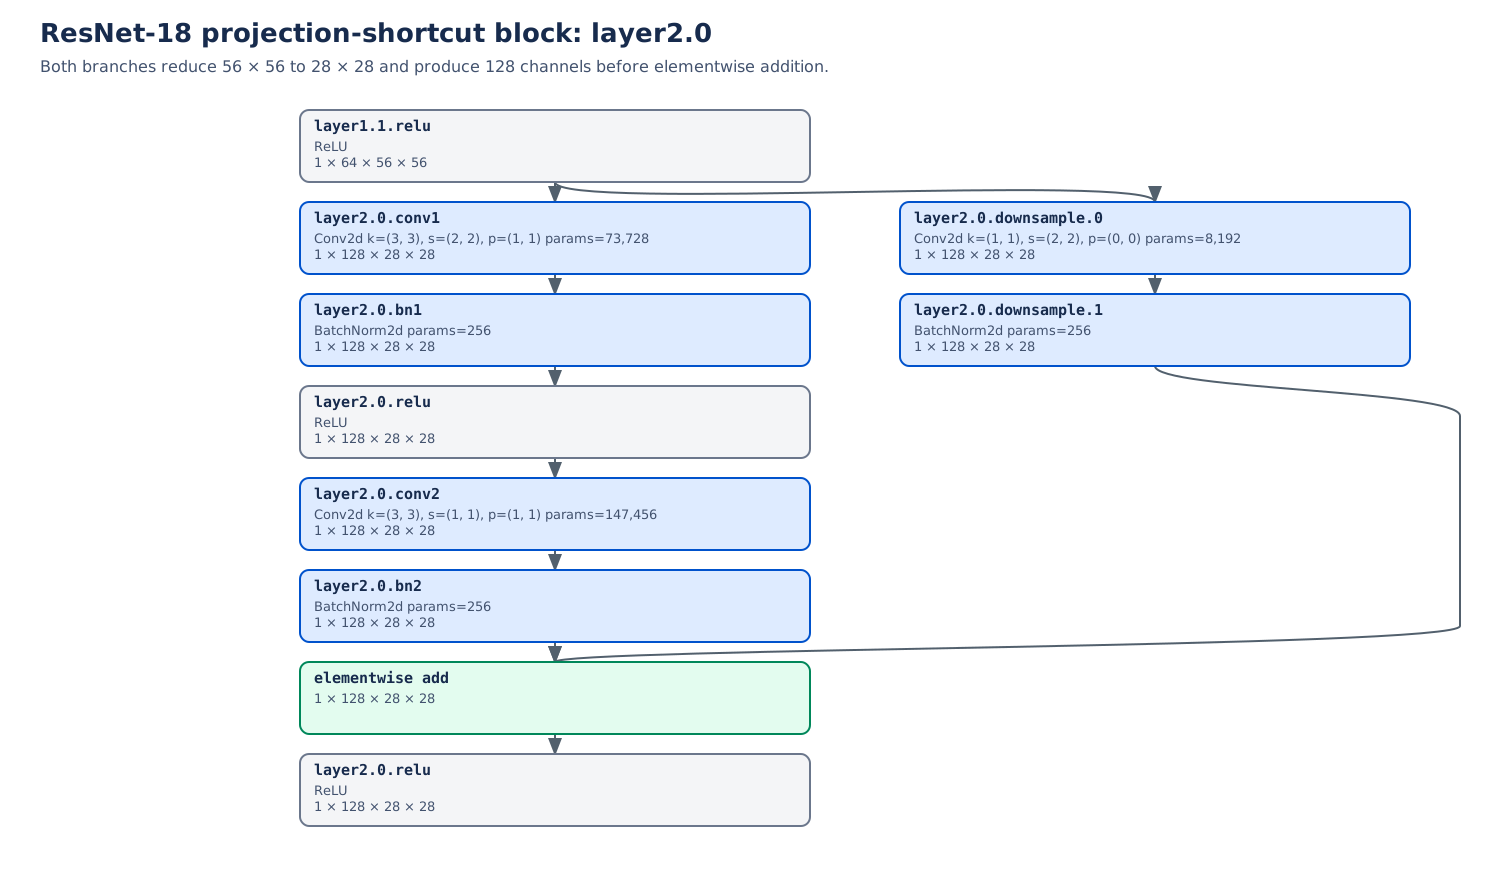
Пусть \(\mathbf J_S\) — якобиан \(S\) с тем же соглашением, что для \(\mathbf J_F\). У суммы блока с проекцией якобиан равен \(\mathbf J_S+\mathbf J_F\), а не \(\mathbf I+\mathbf J_F\). Если размерность меняется, матрица прямоугольная. Называя любой обход тождественным, мы потеряли бы смысл вычисления.
Откройте тождественный блок и блок с проекцией в полном размере. Автоматически построенные графы необученной сети устанавливают формы и связи; они не свидетельствуют о точности классификации.
Повторение блоков внутри этапов
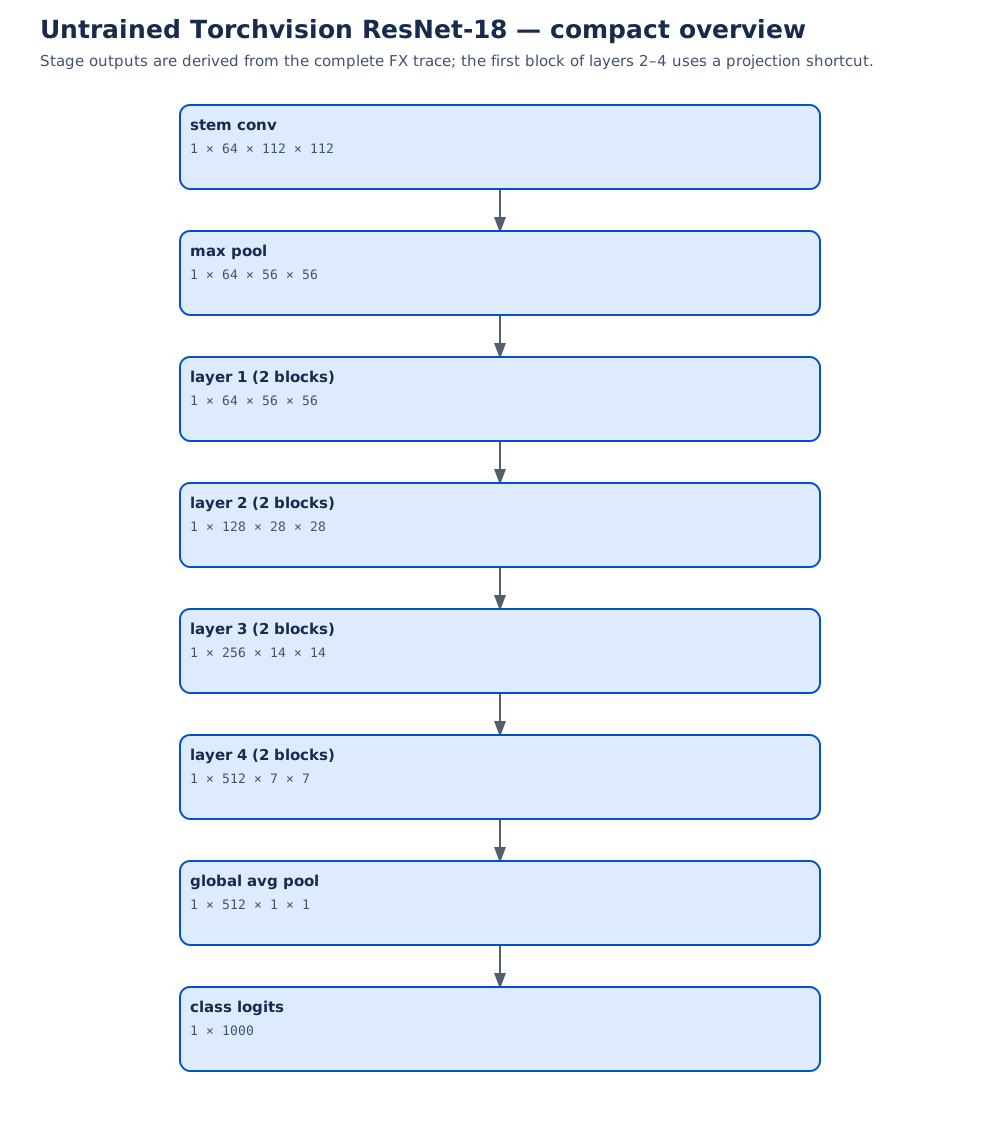
Полный граф ResNet-18 содержит восемь остаточных сложений. Внутри этапа блоки повторяются с одним разрешением. Переходы уменьшают разрешение и увеличивают число каналов, при необходимости используя проекцию. Более глубокие модели повторяют больше блоков или используют bottleneck-ветви: свёртки \(1\times1\) меняют внутреннее число каналов вокруг свёртки \(3\times3\) (He и др. 2016 г.).
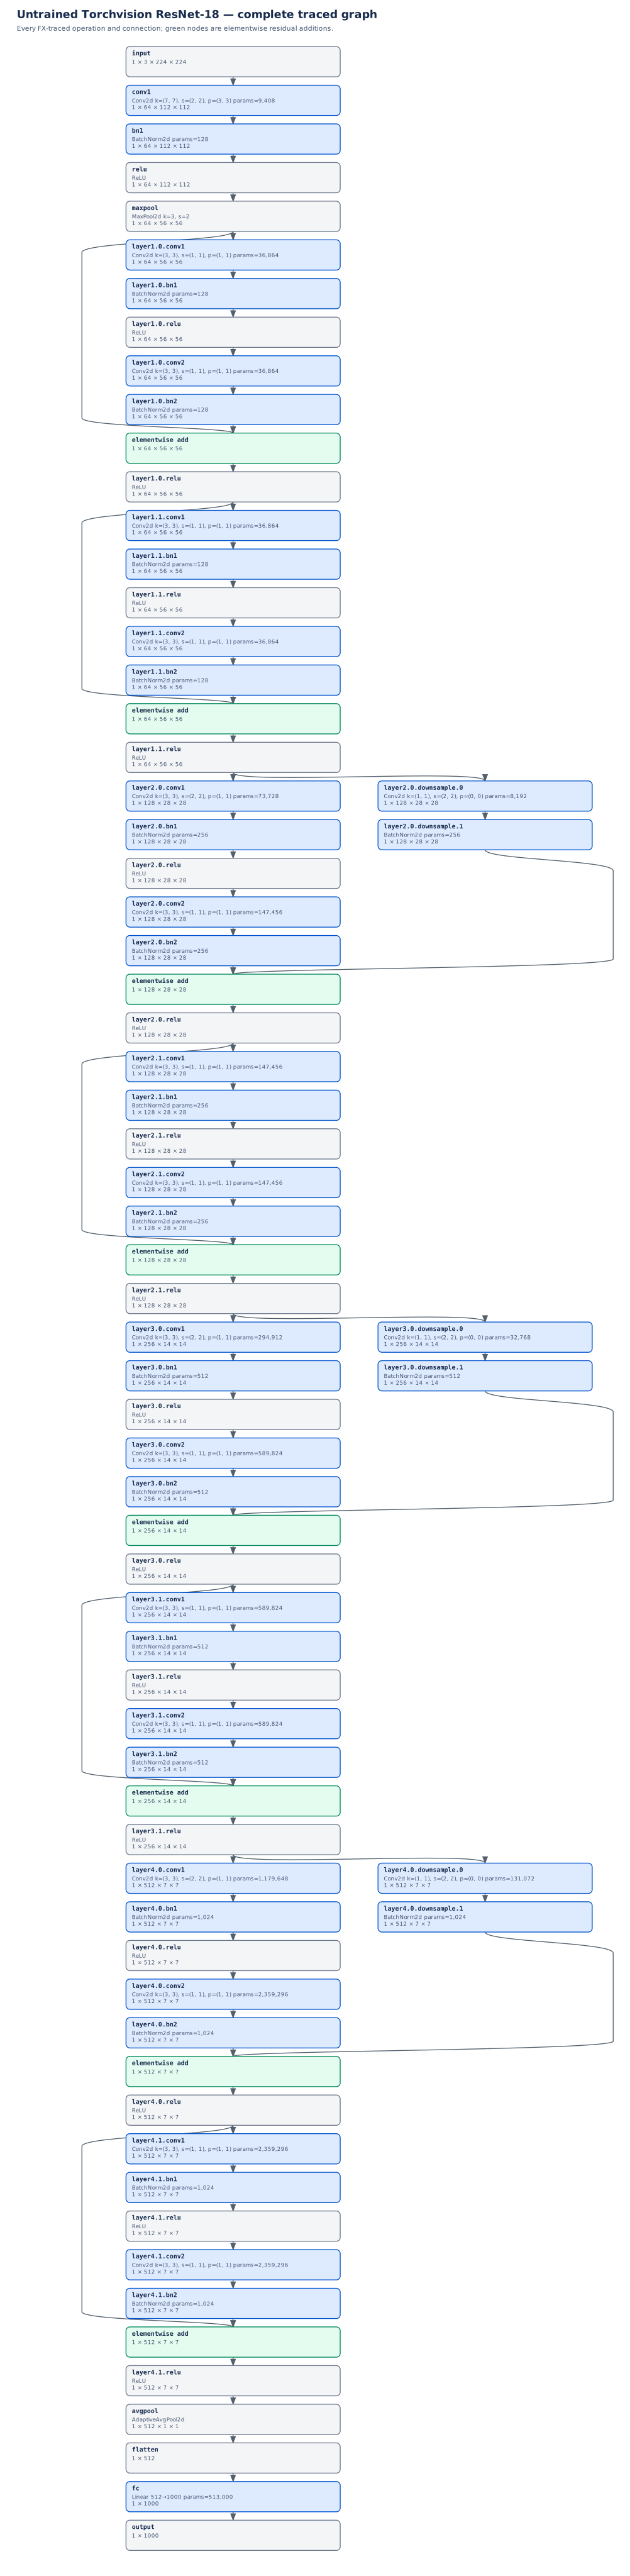
Остаточные пути отвечают за композицию преобразований. Узлы BatchNorm поднимают следующий вопрос: какие значения активаций должны определять масштаб слоя?
Нормализация задаёт оси и состояние
Глубокая сеть многократно преобразует собственные промежуточные входы. Если масштабы активаций меняются, одинаковое обновление параметров может по-разному влиять на последующие вычисления. Нормализация позволяет управляемо центрировать и масштабировать промежуточные значения, сохраняя обучаемые масштаб и сдвиг выхода. Она меняет вычисление при обучении; её пользу нужно проверить на валидации.
Главный вопрос — какие значения используют общие статистики. BatchNorm при обучении группирует значения одного канала по изображениям и позициям. LayerNorm формирует группы внутри примера. Сначала опишем общую операцию, затем последствия выбора групп.
Центрировать, масштабировать, затем обучить масштаб и сдвиг
Пусть \(\mathcal S\) — группа из \(m\) скалярных активаций \(x_j\), а \(j\) нумерует её элементы. Определим среднее \(\mu_{\mathcal S}\) и дисперсию \(\sigma^2_{\mathcal S}\) с делением на размер группы:
\[ \mu_{\mathcal S}=\frac1m\sum_{j\in\mathcal S}x_j, \qquad \sigma^2_{\mathcal S}=\frac1m\sum_{j\in\mathcal S}(x_j-\mu_{\mathcal S})^2. \]
\(\widehat{x}_j\) — нормализованное значение, \(y_j\) — выход, \(\gamma_j,\beta_j\) — обучаемые масштаб и сдвиг. Нормализация с аффинным преобразованием задаётся так:
\[ \widehat{x}_j=\frac{x_j-\mu_{\mathcal S}} {\sqrt{\sigma^2_{\mathcal S}+\epsilon}}, \qquad y_j=\gamma_j\widehat{x}_j+\beta_j, \qquad \epsilon>0. \]
Индексы \(\gamma_j,\beta_j\) здесь условны: метод может использовать общие параметры для многих координат. Это обучаемая часть \(\theta\), а статистики выше вычисляются из активаций. Положительная константа \(\epsilon\) предотвращает нулевой знаменатель и ограничивает масштабирование при малой дисперсии. BatchNorm использует эту конструкцию с группами на основе батча и обучаемым аффинным преобразованием (Ioffe и Szegedy 2015 г.).
Сразу следуют два свойства. Сумма центрированных значений группы равна нулю. Дисперсия нормализованных значений равна
\[ \frac{\sigma^2_{\mathcal S}}{\sigma^2_{\mathcal S}+\epsilon}, \]
и меньше единицы при конечной положительной дисперсии и положительном \(\epsilon\). Постоянная группа даёт нулевые нормализованные значения. Обучаемый аффинный шаг снова меняет среднее и дисперсию; стандартизованный конечный выход не гарантируется.
Нормализация меняет и структуру производных. Так как \(\partial\mu_{\mathcal S}/\partial x_k=1/m\), изменение одного элемента меняет центрирование остальных и обычно масштабирование через дисперсию. Выход координаты может зависеть от всей группы статистик. Группа — выбор архитектуры, а не случайная деталь реализации.
BatchNorm для тензора изображения
Для \(\mathbf X\in\mathbb R^{B\times C\times H\times W}\) обучающий BatchNorm использует одну группу на канал. Пусть \(M=BHW\) — число значений в группе, \(Y\) — выходной тензор после нормализации и аффинного шага. Тогда
\[ \begin{aligned} \mu_c&=\frac1M\sum_{n,a,v}X_{n,c,a,v},\\ \sigma_c^2&=\frac1M\sum_{n,a,v}(X_{n,c,a,v}-\mu_c)^2,\\ Y_{n,c,a,v}&=\gamma_c\frac{X_{n,c,a,v}-\mu_c} {\sqrt{\sigma_c^2+\epsilon}}+\beta_c. \end{aligned} \]
\(n,a,v\) нумеруют примеры, строки и столбцы. Каналы остаются отдельными: большое среднее одного RGB-подобного канала не входит напрямую в среднее другого. Обучаемая пара \((\gamma_c,\beta_c)\) повторяется во всех позициях и примерах. При включённом аффинном шаге обучаемых скаляров \(2C\).
Для группы со значениями \(1,3,5,7\) среднее равно четырём, дисперсия — пяти. При \(\gamma=1\), \(\beta=0\) выход равен \(( -3,-1,1,3)/\sqrt{5+\epsilon}\). Если первый пример даёт \(1,3\), а второй — \(5,7\), изменение второго меняет нормализованные значения первого. Это связь между примерами батча, хотя предшествующая свёртка может обрабатывать их независимо.
Это уточняет расчёт рецептивного поля. При обучении статистики BatchNorm связывают все позиции и примеры канала. Рекуррентная формула свёрток и пулинга описывает локальные пути, но не все зависимости нормализации. При оценке с фиксированными статистиками BatchNorm применяет фиксированное аффинное преобразование каждой координаты.
Скользящие статистики — состояние модели
По умолчанию PyTorch BatchNorm2d(C) сохраняет скользящие оценки среднего и дисперсии при обучении, затем использует их при оценке. Это буферы, а не параметры оптимизатора. Поведение модели зависит и от обученных параметров, и от накопленного состояния.
Оценки обновляются по обучающим батчам; соглашения описаны в документации BatchNorm2d. При нестандартном track_running_stats=False оценка также использует статистики текущего входа.
Три средства управления действуют на разные части процесса:
| Средство | Что меняет | Независимое поведение |
|---|---|---|
model.eval() |
Модули, зависящие от режима, включая BatchNorm и dropout | Запись градиентов может оставаться включённой |
torch.no_grad() |
Запись операций для автоматического дифференцирования | Скользящие статистики обучающего режима продолжают обновляться |
parameter.requires_grad_(False) |
Накопление градиента этим параметром | Режим модуля и обновление буферов остаются независимыми |
Например, обучающий BatchNorm внутри no_grad() продолжает обновлять буферы. И наоборот, прямой проход в режиме оценки можно дифференцировать. Документация autograd различает режим оценки и режимы градиентов. Это различие понадобится при адаптации предобученной основы ниже.
Малые или сильно коррелированные группы могут давать нерепрезентативные статистики. Батч из одного примера не обязательно означает одно значение: канал всё ещё содержит \(HW\) значений, хотя соседние позиции коррелируют. Группа из одного значения не позволяет оценить несмещённую выборочную дисперсию. При применении сохранённые статистики могут плохо описывать изменившееся распределение входа. Поэтому нужно совместно проверять оси, режим и данные, а не считать, что нормализация устраняет различия распределений.
LayerNorm: расчёт для одного примера
LayerNorm строит группы внутри примера, не между примерами (Ba и др. 2016 г.). Маленький пример лекции делает видимыми аффинный шаг и \(\epsilon\). Для \(\mathbf x=(1,3)\):
\[ \mu=2,\qquad \sigma^2=1,\qquad \widehat{\mathbf x}=\frac{(-1,1)}{\sqrt{1.25}} \approx(-0.894427,0.894427), \]
Здесь \(\epsilon=0.25\). Применим покоординатно \(\gamma=(2,0.5)\) и \(\beta=(1,-1)\):
\[ \mathbf y=\left(1-\frac2{\sqrt{1.25}},\; -1+\frac{0.5}{\sqrt{1.25}}\right) \approx(-0.788854,-0.552786). \]
У нормализованной пары среднее ноль и дисперсия \(1/1.25=0.8\). Конечный аффинный выход не имеет ни нулевого среднего, ни единичной дисперсии. Большое \(\epsilon\) выбрано для объяснения, а не как рекомендуемая настройка.
Следующий самостоятельный расчёт переносит эти значения в PyTorch:
import torch
from torch import nn

x = torch.tensor([[1.0, 3.0]], dtype=torch.float64)
normalizer = nn.LayerNorm(2, eps=0.25).double()
with torch.no_grad():
    normalizer.weight.copy_(torch.tensor([2.0, 0.5]))  # gamma
    normalizer.bias.copy_(torch.tensor([1.0, -1.0]))   # beta
output = normalizer(x)
expected = torch.tensor([[-0.788854382, -0.552786405]],
                        dtype=torch.float64)
torch.testing.assert_close(output, expected, atol=1e-8, rtol=0)
Другие примеры не входят в статистики. Добавление примера к батчу не меняет выход данного примера при фиксированных его значениях и аффинных параметрах.
Явно указывайте последние оси
В PyTorch normalized_shape задаёт последние измерения, по которым LayerNorm вычисляет статистики, и форму аффинных параметров. И при обучении, и при оценке используются статистики входа; скользящих оценок BatchNorm нет. Дисперсия вычисляется с делением на размер группы. См. LayerNorm.
| Оси входа и вызов | Группа статистик | Форма аффинных параметров по умолчанию | Обучаемые скаляры |
|---|---|---|---|
\((B,C,H,W)\); LayerNorm((C,H,W)) |
Все каналы и пиксели каждого изображения | \((C,H,W)\) | \(2CHW\) |
\((B,C,H,W)\); LayerNorm((H,W)) |
Пространственная карта каждой пары пример/канал | \((H,W)\) | \(2HW\) |
\((B,N,D)\); LayerNorm(D) |
Признаки каждой пары пример/токен | \((D)\) | \(2D\) |
В строке токенов \(N\) — число позиций последовательности, \(D\) — ширина вектора признаков, а не прежняя третья ось Conv3d. К токенам вернёмся на неделе 06.
Первые два вызова задают разные предположения. Нормализация всего изображения объединяет каналы и позиции, нормализация пространственной карты оставляет каналы в разных группах. Её пространственные аффинные параметры общие для ведущих осей батча и каналов. LayerNorm всего изображения также фиксирует форму параметров, включающую выбранное разрешение.
В тензоре \((B,C,H,W)\) вызов LayerNorm(C) не выбирает ось каналов. Он ожидает размер \(C\) у последней оси и нормализует её. При \(W=C\) код может успешно работать, нормализуя ширину вместо каналов. Для нормализации каналов каждого пикселя нужно сначала получить \((B,H,W,C)\), затем вызвать LayerNorm(C).
Зафиксируем одно изображение и аффинные параметры, но заменим другое изображение его батча. Может ли измениться выход первого при обучающем BatchNorm? А при LayerNorm всего изображения? При оценке считайте, что включено стандартное сохранение скользящих статистик.
Показать объяснение
Обучающий BatchNorm может измениться: статистики канала включают другие примеры. LayerNorm всего изображения использует только его координаты, поэтому замена не влияет на выход. Стандартный BatchNorm при оценке использует сохранённые статистики; другой текущий вход также не меняет выход фиксированного изображения.
Выбрать группировку для нужного вычисления
BatchNorm при обучении использует общие поканальные статистики по примерам и позициям; LayerNorm группирует выбранные координаты внутри примера. Изменение, одинаково затрагивающее все значения группы, частично удаляется центрированием и масштабированием перед аффинным шагом. Является ли такая вариация помехой или полезным сигналом, зависит от задачи и представления.
Нормализация — архитектурная гипотеза для проверки на валидации. Учитывайте состав батча, порядок осей, форму параметров и поведение при применении. BatchNorm может быть эффективен в CNN с репрезентативными батчами; для токенов часто используют LayerNorm по ширине представления. Это не универсальное правило замены, и модель без нормализации остаётся полезной базовой линией.
Остаточные связи и нормализация меняют обучение и оценку глубокого представления. Для его повторного использования возникает практический вопрос: какие параметры, буферы и операции, зависящие от режима, должны меняться на новой задаче?
Осмысленное повторное использование представлений
Аугментация задаёт предположение о целевой переменной
Обучающий пример — не только массив: смысл его целевого значения определяет допустимые изменения. При классификации объектов отражение фотографии кошки может сохранить класс. При определении направления отражение превращает стрелку влево в стрелку вправо. Прежняя метка направления внесла бы ошибку в обучение.
Пусть \(T\) — преобразование входа, \(y(\mathbf x)\) — целевая функция задачи. Обучая на \((T(\mathbf x),y(\mathbf x))\), мы предполагаем
\[ y(T(\mathbf x))=y(\mathbf x). \]
Предположение зависит от задачи. При локализации и сегментации корректное геометрическое преобразование обычно требует изменить и цель: отражённому изображению соответствуют отражённые координаты или маска. Неизменная метка класса и преобразованная пространственная цель — разные правила обучения.
Аугментация знакомит модель с желаемой вариативностью, но не доказывает точную инвариантность. Преобразования должны сохранять нужную цель и напоминать изменения при будущем применении. Обрезка единственного размеченного объекта или изменение цвета, уничтожающее диагностический признак, нарушает это условие. Аугментации AlexNet — исторический пример регуляризации для конкретной задачи (Krizhevsky и др. 2012 г.), а не универсальный список безопасных преобразований.
Выбирайте аугментации по валидационным данным. Проверяйте ошибки после преобразований, особенно в случаях возможной смены метки. Без разбора применённые преобразования могут научить модель игнорировать именно нужное различие.
Зафиксировать представление и обучить новую голову
Предположим, нужно классифицировать спутниковые сцены с помощью сети, предобученной на другой коллекции изображений. Можно повторно использовать преобразование изображения в признаки и обучить новый классификатор наших меток. Повторно используемая часть — основа (backbone), новый классификатор задачи — голова (head).
Разложим предобученную модель на основу \(f_{\theta_{\mathrm{back}}}\) и голову \(q_{\theta_{\mathrm{head}}}\). Индексы \(\mathrm{back}\) и \(\mathrm{head}\) различают наборы параметров; \(\mathbf z^{\mathrm{head}}\) — логиты головы. Для одного входа:
\[ \mathbf h=f_{\theta_{\mathrm{back}}}(\mathbf x), \qquad \mathbf z^{\mathrm{head}}=q_{\theta_{\mathrm{head}}}(\mathbf h). \]
При переносе с фиксированными признаками основа даёт неизменное представление, оптимизируется только новая голова. Линейная голова \(\mathbf z^{\mathrm{head}}=\mathbf W^{\mathrm{head}}\mathbf h+\mathbf b^{\mathrm{head}}\) проверяет, допускают ли признаки линейную границу классов. Нелинейная голова проверяет более широкую пригодность; её результат не следует называть свидетельством линейной разделимости.
Неизменное представление требует полной политики состояния: зафиксировать параметры основы и скользящие статистики BatchNorm, отключить обучающий dropout. Используйте предобработку, предусмотренную весами: порядок каналов, масштаб входа, изменение размера и нормализация входят в соглашение о данных. Иначе основа получит измерения, отличающиеся от тех, на которых сформировались признаки.
На практике отключают градиенты параметров основы, переводят её в режим оценки и оптимизируют только голову. Вызов основы можно поместить в no_grad(), если градиенты по входу не нужны, но вычисление головы должно остаться дифференцируемым. Если train() у общей обёртки вернул основу в режим обучения, перед следующим проходом восстановите режим оценки. См. документацию autograd.
Признаки можно кэшировать при фиксированных основе и предобработке. Если случайная аугментация меняет входы, один сохранённый вектор не описывает все варианты исходного примера. Изменение предобработки или состояния основы также делает кэш неактуальным.
Такой перенос — полезный начальный эксперимент при малом числе меток или ограниченных вычислениях. Успех зависит от соответствия исходных признаков новым различиям. Yosinski и соавторы показали ограничения переноса из-за специализации признаков и разделения совместно адаптированных слоёв; в их экспериментах переносимость снижалась при расхождении задач (Yosinski и др. 2014 г.). Предобученная основа — проверяемая гипотеза, а не гарантия наличия всех нужных признаков.
Адаптировать в пределах, оправданных валидацией
Дообучение (fine-tuning) позволяет выбранным предобученным параметрам меняться под новую целевую функцию. Градиент снова проходит через обновляемые части основы. При размораживании уберите соответствующую границу no_grad() и включите параметры в оптимизатор. Параметр с градиентом, которого нет в оптимизаторе, не получит нужного обновления.
| Стратегия | Обновляемые параметры | Проверяемый вопрос |
|---|---|---|
| Только голова | Новая голова задачи | Пригодны ли уже имеющиеся признаки? |
| Частичное дообучение | Голова и выбранные поздние блоки | Помогает ли адаптация поздних представлений? |
| Полное дообучение | Голова и вся основа | Оправдывает ли широкая адаптация затраты и риски? |
Обучение одной головы может не сработать из-за несоответствия признаков; широкая адаптация — переобучиться на малой выборке или разрушить полезные признаки. Частичная адаптация создаёт границу между фиксированными и изменяемыми представлениями. Задайте поведение нормализации на этой границе явно, не оставляя его случайному общему переключению режима.
Начать с головы и затем проверить поздние блоки — практический маршрут, а не обязательная последовательность. Меньший learning rate для предобученных параметров — начальная эвристика. Сравнивайте стратегии на одной валидационной выборке с записанными бюджетами и предобработкой, включая убедительную базовую линию. Тест оставьте для выбранной процедуры; не выбирайте по нему число размораживаемых блоков.
Свидетельства качества шире среднего результата
Точность на отложенной выборке отвечает на определённый вопрос об определённой выборке. Она не устанавливает, что модель использует нужные признаки или надёжна на новом устройстве, фоне либо популяции. Изучайте ошибки по классам и при реалистичных изменениях. Например, замена фона с сохранением объекта может обнаружить чувствительность предсказания для дальнейшего анализа; сама по себе она не доказывает неуместность любого фонового признака.
Разрабатывайте проверки на валидационных данных, указывайте сохраняемые свойства и отличайте исследование ошибок от итоговой оценки. Вероятности и калибровка важны, если уверенность влияет на решение; неопределённость по примерам и инициализациям — при сравнении моделей. Следующий эксперимент отвечает на более узкий вопрос с небольшим синтетическим набором и явным протоколом.
Исследование: MLP против Conv1d
Сможет ли модель с повторным использованием локальных структур выучить полезное представление при том же числе обновлений, что и полносвязная альтернатива? Упорядоченные сигналы дают небольшой тест этой гипотезы. Сравним MLP и Conv1d на одинаковых примерах. Это две полные архитектуры, поэтому сравнение не выделяет эффект только общих весов.
Метка обозначает порождающую форму сигнала
MNIST-1D — синтетическая задача Sam Greydanus и Дмитрия Кобака. Метки 0–9 обозначают исходные шаблоны; входы — зашумлённые преобразованные сигналы длины 40, а не развёрнутые изображения рукописных цифр. Официальная процедура в закреплённой версии включает дополнение, сдвиг, масштабирование, скашивание, коррелированный и независимый шум. По одной форме примера нельзя восстановить точные случайные параметры его преобразования.
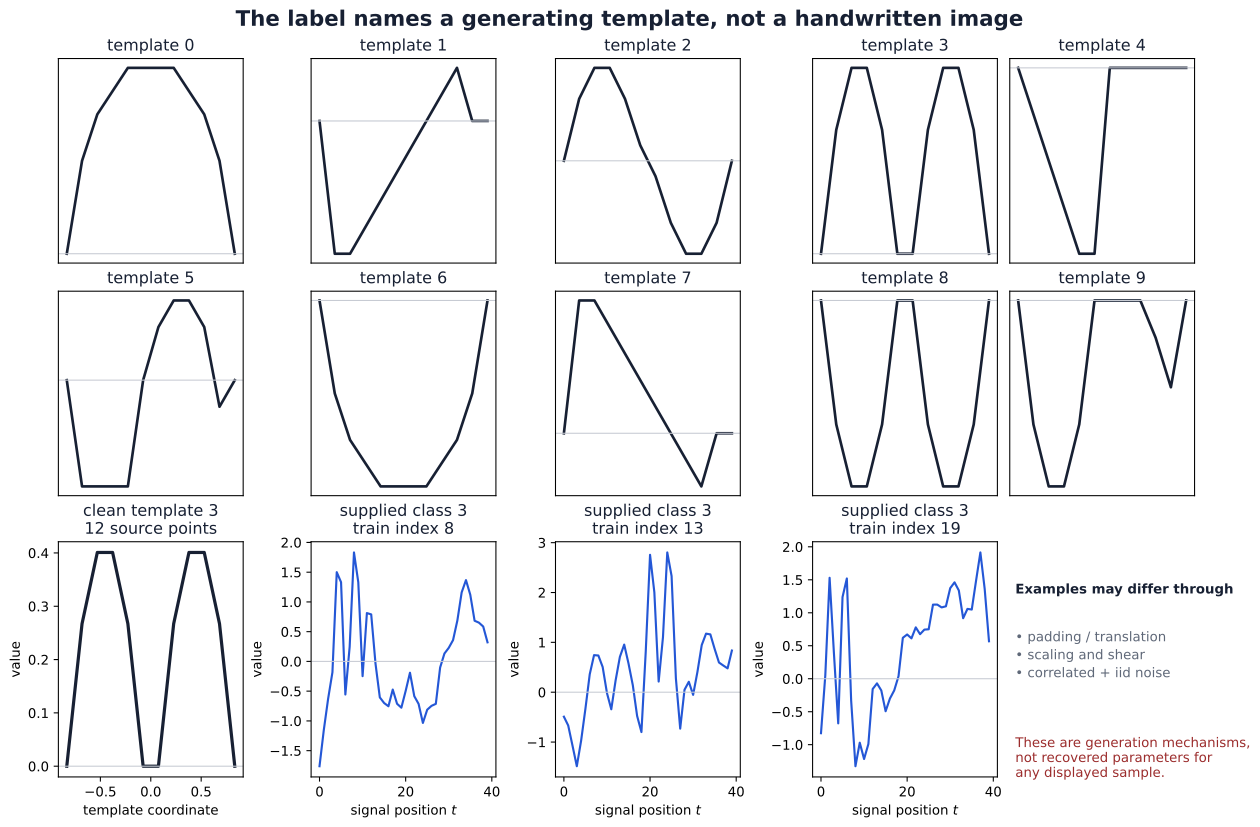
Рисунок в полном размере. Соседство позиций имеет смысл, поскольку они описывают упорядоченную форму. Это делает локальность и общие веса правдоподобными, а преобразования и шум усложняют прямое узнавание шаблона.
Раздел использует сохранённые эксперимент и рисунки практикума. Файлы данных и подробности воспроизводимости описаны в ноутбуке.
Разделить роли обучения, валидации и теста
При seed 202605 ноутбук строит стратифицированное разбиение 3 200/800 из 4 000 обучающих примеров. Стратификация приблизительно сохраняет пропорции классов, не предполагая равного числа примеров каждого класса. Отдельные 1 000 тестовых примеров сохраняют свою роль.
Предобработка оценивает одно скалярное среднее и одно стандартное отклонение с делением дисперсии на число значений по всем элементам 3 200 обучающих сигналов. Одно преобразование применяется ко всем выборкам. Оценка этих величин по валидации или тесту позволила бы отложенным примерам влиять на разработку. Это предобработка входа, отдельная от нормализации скрытых активаций.
| Выборка | Примеры | Роль |
|---|---|---|
| Обучение | 3 200 | Оценить предобработку и обновить параметры |
| Валидация | 800 | Сравнить поведение при разработке и выбрать контрольные точки |
| Исходный тест | 1 000 | Оценить обе зафиксированные выбранные модели |
Близкое число параметров, разные связи
Обе модели получают одинаковые нормализованные числа и выдают десять логитов. Вход MLP — \((B,40)\); далее линейный слой 40→68, ReLU и голова 68→10. Число параметров:
\[ 68(40+1)+10(68+1)=3478. \]
Conv1d рассматривает вход как \((B,1,40)\). Три свёрточных слоя с шагом один, нулевым дополнением и 16 выходными каналами имеют ширины 5, 5 и 3; после каждого стоит ReLU. Длина остаётся 40. Адаптивное среднее затем создаёт восемь упорядоченных ячеек каждого канала, разворачиваемых в 128 входов головы.
| Этап Conv1d | Форма выхода | Параметры |
|---|---|---|
| Ширина 5, дополнение 2, каналы 1→16 | \((B,16,40)\) | \(16(1\cdot5+1)=96\) |
| Ширина 5, дополнение 2, каналы 16→16 | \((B,16,40)\) | \(16(16\cdot5+1)=1296\) |
| Ширина 3, дополнение 1, каналы 16→16 | \((B,16,40)\) | \(16(16\cdot3+1)=784\) |
| Адаптивное среднее | \((B,16,8)\) | 0 |
| Развёртка и голова 128→10 | \((B,10)\) | \(10(128+1)=1290\) |
Всего \(96+1296+784+1290=3466\). ReLU не добавляют параметров. Разница составляет двенадцать, но близкие числа не делают одинаковыми классы функций, глубину, оптимизацию и вычислительные затраты.
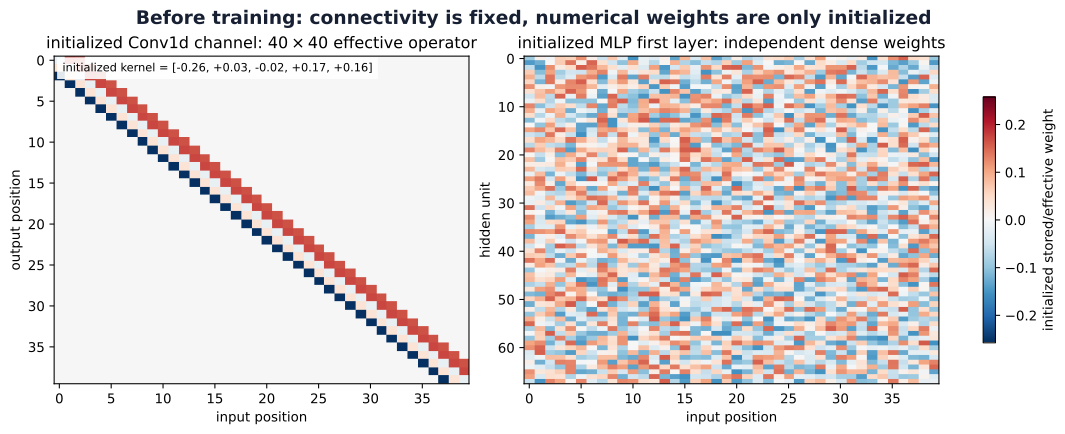
Повторяющиеся элементы ленточного оператора определяются всего пятью весами ядра и одним смещением. Полносвязный слой настраивает каждую связь независимо. Это структура архитектуры до обучения.
Рекуррентная формула даёт протяжённости 5, 9 и 11 в стеке Conv1d при расстоянии один. Одна конечная позиция может использовать диапазон из одиннадцати позиций с поправкой на дополнение у границ. Классификатор объединяет много позиций: при переходе от 40 значений к восьми ячейкам усредняются последовательные пятёрки. Внутренняя ячейка может номинально охватить пятнадцать входных позиций за счёт пяти перекрывающихся зависимостей длины одиннадцать. Линейная голова использует все ячейки и может зависеть от всего сигнала.
В отличие от глобального среднего до одной ячейки, восемь ячеек сохраняют грубое положение. Голова может по-разному обрабатывать разные ячейки. Поэтому модель не следует называть точно инвариантной к сдвигу: важны границы и сохранённые пространственные интервалы. См. AdaptiveAvgPool1d.
Согласовать протокол и указать оставшиеся различия
Одна заранее вычисленная последовательность перемешиваний используется для обеих моделей. В эпохе \(3200/64=50\) обновлений; тридцать эпох дают 1 500 обновлений на модель. Используются средняя кросс-энтропия и Adam с learning rate \(10^{-3}\). Обе инициализации используют seed 202605; одинаковый seed обеспечивает воспроизводимость, но не эквивалентные начальные представления разных архитектур.
После каждой эпохи метрики обучения и валидации вычисляются в режиме оценки на полных соответствующих выборках. Обучающая потеря на графике — оценка текущей модели в конце эпохи, а не среднее меняющихся потерь при обновлениях. Для каждой модели сохраняется контрольная точка с минимальной валидационной потерей. Только после фиксации обеих выбранных моделей каждая один раз оценивается на тесте.
Совпадают примеры, порядок, оптимизатор, размер батча, число обновлений и правило выбора. Не совпадают число операций и время. Близкое число параметров оставляет различия глубины, объединения и связей. Сравниваются две полные модели в заданной процедуре; причинный вклад только разделения параметров не выделяется.
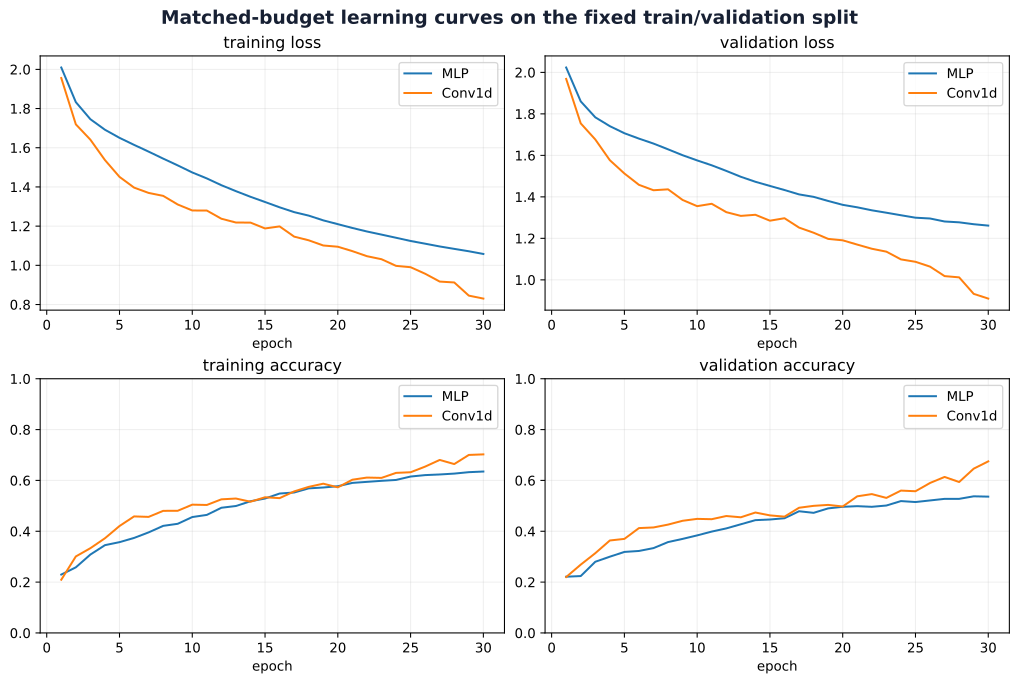
Обе модели MNIST-1D выбрали эпоху 30 — последнюю разрешённую. Доказывает ли это сходимость? На что на рисунке нужно опереться?
Показать объяснение
Нет. Обе валидационные потери ещё снижаются у границы бюджета. Последняя эпоха — лучшая увиденная контрольная точка в этом бюджете, но не доказательство бесполезности дальнейшего обучения. Более длинный бюджет следует исследовать по валидации, не используя тест для этого решения.
Прочитать результаты и парные ошибки
Для выбранных контрольных точек ноутбук сообщает округлённые значения:
| Модель | Выбранная эпоха | Потери валидации | Точность валидации | Потери теста | Точность теста |
|---|---|---|---|---|---|
| MLP | 30 | 1.2615 | 0.536 | 1.2424 | 0.521 |
| Conv1d | 30 | 0.9097 | 0.675 | 0.9023 | 0.654 |
В сохранённом сравнении у Conv1d выше точность и ниже потери. Результат согласуется с полезностью локальной структуры и общих весов для этих сигналов. Он не ранжирует все CNN и MLP, не измеряет качество на изображениях рукописных цифр и не устанавливает средний эффект по разбиениям и seed.
Раздельные точности скрывают, какие примеры каждая модель решает верно. Парные категории теста сохраняют эту информацию:
| Результат на одном тестовом примере | Число |
|---|---|
| Обе верны | 416 |
| Ошиблась только MLP | 238 |
| Ошиблась только Conv1d | 105 |
| Обе ошиблись | 241 |
На 105 примерах MLP права, а Conv1d ошибается. Лучший суммарный результат не означает превосходства на каждом входе. Категории расхождений показывают различия моделей, общие ошибки — оставшиеся трудности.
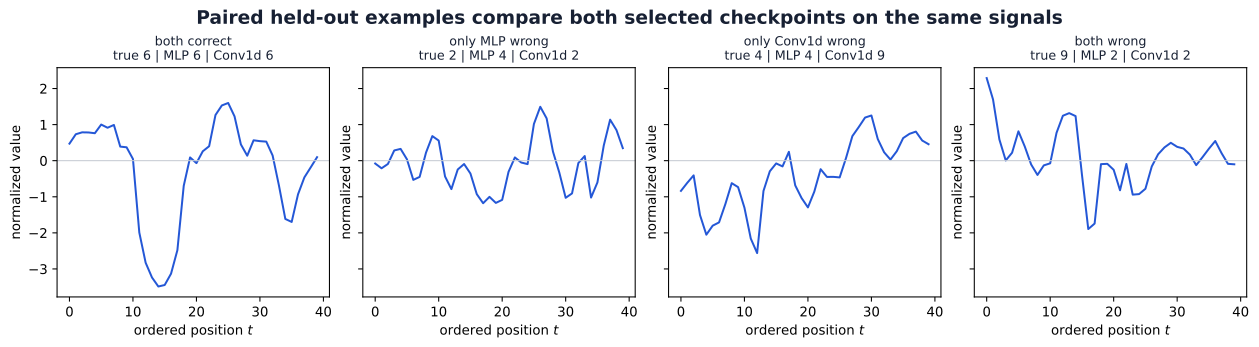
Галерея берёт первый доступный пример категории, а не случайную или репрезентативную выборку. Она подсказывает вопросы об ошибках, но четыре случая не устанавливают закономерности по классам или преобразованиям. Для этого нужен более широкий анализ с разделением дальнейшей настройки и итоговой оценки.
Обоснованный вывод ограничен: на данном синтетическом наборе, разбиении, seed и протоколе 30 эпох выбранная Conv1d превзошла выбранную MLP. Повторные seed, дополнительные разбиения, убедительная настройка обеих моделей и отдельные сравнения затрат отвечали бы на вопросы, оставшиеся открытыми.
Итоги, упражнения и дальнейшее чтение
Что установлено в главе
Свёрточная сеть сохраняет механизм обучения недели 04, ограничивая аффинные преобразования. Локальность ограничивает входы одной позиции; общие веса повторяют коэффициенты в разных позициях; сумма по каналам объединяет разные измерения. Цепное правило собирает вклады каждого применения в компактный градиент параметров.
Геометрия определяет связь вычисления со входом. Дополнение задаёт граничные значения, шаг выбирает начала окон, пулинг обобщает области. Глубина расширяет локальный охват; глобальное или грубое объединение связывает пространственные признаки с головой задачи. Эквивариантность означает, что выход следует преобразованию; инвариантность — что выход задачи не меняется. Ни пулинг, ни знакомое название архитектуры не гарантируют последнего.
Остаточные пути добавляют прямой маршрут рядом с обучаемыми преобразованиями. Нормализация группирует координаты и может хранить состояние. Аугментация предполагает сохранение цели, перенос определяет, какие параметры и состояние сохранять или адаптировать. Каждый выбор меняет представимые функции или обучение. Валидация проверяет выборы, итоговая отложенная оценка поддерживает конкретный вывод.
Частые заблуждения
| Заблуждение | Важное различие |
|---|---|
| Канал — это класс | Скрытые каналы — признаки; логиты классов создаёт голова |
| Меньше параметров гарантирует более быстрое или качественное обучение | Число описывает степени свободы; затраты и предсказания проверяются отдельно |
| Протяжённость рецептивного поля равна действующему влиянию | Это возможные локальные связи; вентили, веса и нормализация меняют реальную зависимость |
| Тождественный обход гарантирует тождественный блок | На выход влияют сложение, остаточная ветвь и активация |
| Замороженные параметры означают фиксированные признаки | На представление также влияют буферы, dropout и предобработка |
| Победа на тесте устанавливает общий рейтинг моделей | Вывод ограничен данными, разбиением, процедурой и изученной неопределённостью |
Упражнения
Дополнительные упражнения продолжают объяснения; решения не приведены. Упражнения 1–2 относятся к свёрткам и обучению, 3–4 — к геометрии, 5–6 — к глубине и нормализации, 7–8 — к переносу и аугментации, 9 — к эксперименту.
Упражнение 1 — Полный учёт свёртки
Вход имеет форму \((B,3,32,32)\). Свёртка использует двенадцать выходных фильтров, ядро \(5\times5\), шаг два, симметричное нулевое дополнение два и смещение. Выведите пространственные размеры выхода и число параметров. Объясните, почему изменение \(B\) не меняет ни пространственную форму, ни число обучаемых коэффициентов. Укажите форму весов и число входных срезов каждого фильтра.
Упражнение 3 — Протяжённость и расстояние
Вдоль оси последовательно примените свёртку ширины 3 с шагом 2, пулинг ширины 2 с шагом 2 и свёртку ширины 3 с шагом 1. Проследите протяжённость рецептивного поля и расстояние выходов после каждой операции. Какие ещё сведения нужны для положения поля конкретного выхода у границы? Отличите номинальную протяжённость от числа измеренных входов.
Упражнение 4 — Для утверждения о сдвиге нужна область
Постройте одномерный пример, где выборка с шагом 2 после сдвига на одну позицию меняется так, что это нельзя описать сдвигом выхода. Затем найдите согласованный входной сдвиг, соответствующий сдвигу выхода вдали от границ. Объясните, почему глобальное среднее не исправляет любое расхождение из-за границ или выборки, возникшее раньше в классификаторе.
Упражнение 5 — Остаточные пути и вентили
Пусть \(F(\mathbf x)=\mathbf A\mathbf x\), где \(\mathbf A=\begin{bmatrix}0&1\\-1&0\end{bmatrix}\) и \(\mathbf x=(2,1)^\top\). Вычислите остаточную сумму, выход ReLU после сложения и градиент по входу для \(J=h_0+3h_1\). Используйте градиенты-столбцы. Сравните с отсутствием ReLU и объясните различие через два пути и их вентиль.
Упражнение 6 — Оси и параметры
Для \((B,C,H,W)=(4,8,6,6)\) укажите группы статистик и числа аффинных параметров BatchNorm2d(8), LayerNorm((8,6,6)) и LayerNorm((6,6)). Какие выходы меняются при замене другого примера в обучающем батче? Какие методы хранят скользящие статистики? Почему LayerNorm(8) здесь не выбирает каналы?
Упражнение 7 — Проверка замороженной основы
Обёртка содержит замороженную основу с BatchNorm и dropout и обучаемую голову. Перед каждой эпохой вызывается wrapper.train(). Объясните, почему requires_grad=False у параметров основы не гарантирует неизменных признаков. Предложите настройки режима и оптимизатора, затем копиями до и после проверьте, что обновление меняет голову, сохраняя все параметры и буферы основы.
Упражнение 8 — Допустима ли аугментация?
Рассмотрите горизонтальное отражение для классификации объектов, определения направления знаков и сегментации. Укажите, должна ли цель сохраняться, меняться или требовать отдельного анализа. Опишите валидационную проверку неверного предположения об инвариантности без настройки по тесту.
Упражнение 9 — Что ответит следующий эксперимент?
По сохранённым кривым MNIST-1D и парным числам ошибок сформулируйте один подтверждённый результат и три вопроса без ответа. Спроектируйте продолжение по валидационным данным для одного вопроса: более долгое обучение, вариативность seed, абляция общих весов или равные вычислительные затраты. Укажите фиксируемые факторы, правило выбора и границу итоговой оценки. Объясните, почему близкое число параметров не изолирует локальность или общие веса.
Дальнейшее чтение
Читайте первоисточники с конкретным вопросом:
- AlexNet: как взаимодействуют архитектура, оптимизация, аугментация и оборудование; что отличается от библиотечного варианта? (Krizhevsky и др. 2012 г.)
- ResNet: какие обучающие ошибки мотивируют остаточное обучение и когда нужно согласовывать размерности обхода? (He и др. 2016 г.)
- BatchNorm и LayerNorm: какие значения формируют статистики, какие параметры обучаются и как различаются обучение и оценка? (Ioffe и Szegedy 2015 г.; Ba и др. 2016 г.)
- Перенос признаков: как специализация исходной задачи и граница адаптируемых слоёв влияют на повторное использование? (Yosinski и др. 2014 г.)
- Официальный MNIST-1D в закреплённой версии: как генерация данных делает пространственные предположения значимыми для эксперимента?
- Vision Transformer: как превратить изображение в последовательность векторов фрагментов и зачем нужна информация о позиции? (Dosovitskiy и др. 2021 г.)
Далее: последовательности и внимание
Свёртка уже показала обработку упорядоченного сигнала общими параметрами. Следующая неделя посвящена последовательным представлениям, рекуррентным состояниям и вниманию. Целевая функция, цепное правило и требования к оценке сохраняются, меняется взаимодействие позиций.
Vision Transformer даёт связующий пример: фрагменты изображения становятся токенами, положение задаётся явно, а самовнимание связывает удалённые фрагменты. Исходное исследование ViT проверяло эту конструкцию при больших масштабах предобучения (Dosovitskiy и др. 2021 г.); оно не устанавливает вечный рейтинг архитектур. Локальные фильтры, рекуррентность и внимание задают разные предположения о взаимодействиях. Понимание предположений позволяет сравнивать поведение, а не выбирать по названию.