Неделя 04 · Обучение нелинейным представлениям: полносвязные сети и обратное распространение
Рисунки, изображения, анимации и их элементы управления сохранены с исходными английскими надписями. Переведены текст главы, таблицы и внешние подписи; формулы и код сохранены.
Линейная и логистическая регрессия уже содержат основной цикл обучения с учителем: выбрать модель, предсказать, измерить потерю, вычислить градиент, обновить параметры. Полносвязная сеть (feedforward neural network) сохраняет цикл, но обогащает модель обучаемыми промежуточными представлениями.
Начнём со сбоя, который оптимизация не исправит, введём меняющую выразительность нелинейность и проведём вход через полное многослойное вычисление. Затем построим скалярную цель, распространим чувствительности назад, свяжем математику с PyTorch autograd и соберём обучение. В конце выясним, что результаты обучения сообщают и не сообщают о новых данных. Цель — увидеть, как несколько операций становятся обучаемой моделью, требующей оценки, а не накопить термины.
Результаты обучения
После главы вы сможете:
- различать недостаточность представления и сбой оптимизации;
- понимать нейрон как аффинное преобразование с активацией;
- сворачивать композицию аффинных слоёв без нелинейностей в одно отображение;
- объяснять подвижные изломы ReLU одномерной функции;
- переводить формулы одного примера в batch-first формы PyTorch;
- прослеживать проверенный пример сети \(2\to3\to1\) до скалярного выхода;
- согласовывать выходы регрессии, бинарной и многоклассовой классификации с потерей;
- различать логиты, Softmax-вероятности, индексы и one-hot цели;
- распространять чувствительности скалярного графа: произведения вдоль путей, суммы ветвей и шлюз ReLU;
- выводить градиенты весов, смещений и входов батчевого слоя и проверять формы;
- объяснять обратный режим autograd записанными операциями и вектор-якобианными произведениями;
- понимать влияние статуса листа, накопления градиентов,
retain_grad()иdetach(); - различать
detach(),torch.no_grad()иmodel.eval()по записи графа и поведению модулей; - связывать мини-батчи, скорость, состояние оптимизатора и инициализацию с полным циклом;
- различать обучение, валидацию, тест и типичные кривые потерь.
Необходимые знания
Нужны матричное умножение, скалярные производные и линейная либо логистическая регрессия. Кратко повторим градиентный спуск и отличие обучения от оценки. Синтаксис PyTorch объясняется там, где влияет на математику.
Лекция недели 04 представляет визуальную последовательность, практикум Ode to Autograd — полный исполняемый эксперимент. Глава понятна и без открытых сопутствующих материалов.
Знакомый цикл с более богатой моделью
Что остаётся неизменным
Пусть \(f_\theta\) переводит вход \(\mathbf x\) в предсказание \(\hat{\mathbf y}\), а \(\theta\) собирает всё обучаемое. Обучение следует цепочке:
\[ \theta \longrightarrow \hat{\mathbf y}=f_\theta(\mathbf x) \longrightarrow L(\hat{\mathbf y},\mathbf y) \longrightarrow \nabla_\theta L \longrightarrow \theta-\eta\nabla_\theta L. \]
Скорость \(\eta\) задаёт размер обновления. Антиградиент — локальное направление снижения потерь при достаточно малом шаге. Это не особые свойства нейросетей.
Меняется модель между входом и ответом. Логистическая регрессия использует обучаемый аффинный скор и фиксированное выходное преобразование:
\[ \hat y=\sigma(\mathbf w^\top\mathbf x+b). \]
Двухслойная сеть сначала строит скрытое представление, затем выход:
\[ \mathbf h =\phi\!\left(\mathbf W^{(1)}\mathbf x+\mathbf b^{(1)}\right), \qquad \hat{\mathbf y} =g\!\left(\mathbf W^{(2)}\mathbf h+\mathbf b^{(2)}\right). \]
Здесь \(\phi\) — активация скрытого слоя, выходное \(g\) зависит от задачи. Обе матрицы весов и оба вектора смещений учатся совместно. Поэтому \(\mathbf h\) — не заранее заданные признаки, а представление, настраиваемое той же целью, что итоговый предиктор.
Когда оптимизация не исправит семейство
Рассмотрим одномерную цель практикума:
\[ f(x)=\sin(\pi x)+0.25x, \qquad -1\le x\le1. \]
Аффинная модель:
\[ \hat f(x)=mx+c. \]
Изменение \(c\) сдвигает прямую вертикально, \(m\) меняет наклон. Спуск ищет лучшие значения, но не заставит производную \(d\hat f/dx=m\) зависеть от \(x\): семейство содержит только прямые.
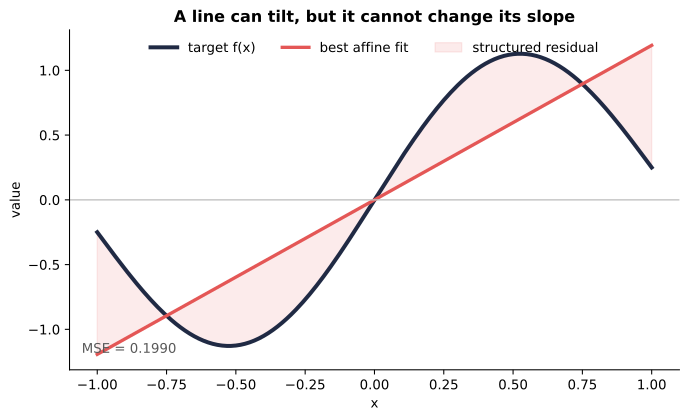
Прямая на Рисунок 1 уже является решением задачи наименьших квадратов для показанной 241 обучающей точки. Её среднеквадратичная ошибка составляет примерно \(0.1990\). Дальнейшая оптимизация той же модели с двумя параметрами не создаст недостающие изгибы. Остаток имеет структуру, потому что выбранное семейство моделей не подходит для этой зависимости.
Это недостаточность представления (representation failure): нужной формы нет ни при каких параметрах. Сбой оптимизации (optimization failure) иной: подходящие параметры существуют, но алгоритм их не достигает, например из-за неустойчивой скорости или неинформативных градиентов.
Оптимизатор выбирает параметры внутри семейства, не расширяет его. Если наклон всех функций постоянен, дополнительная оптимизация не сделает его переменным.
Показанная на графике ошибка — остаток на обучающих данных. Он описывает поведение подобранной прямой в этих точках; это не валидационные данные и не свидетельство того, как любая из моделей обобщается на новые наблюдения. На протяжении учебника мы будем разделять вопросы оптимизации и обобщения.
Нужен компонент, меняющий наклон. Сеть получает его нелинейными операциями между аффинными преобразованиями.
От нейрона к нелинейному представлению
Аффинный сигнал и активация
Нейрон принимает \(d\) численных входов, умножает на обучаемые веса, суммирует, добавляет обучаемое смещение и применяет активацию:
\[ z =\mathbf w^\top\mathbf x+b =\sum_{j=1}^{d}w_jx_j+b, \qquad h=\phi(z). \]
Две промежуточные величины имеют разные роли:
- предактивация (preactivation) \(z\) — аффинный скор;
- активация \(h\) — значение после \(\phi\), передаваемое дальше.
Веса задают силу и направление вкладов. Смещение сдвигает скор до активации, а та меняет форму сигнала последующих слоёв.
Распространены сигмоида, гиперболический тангенс и rectified linear unit. Для геометрии используем ReLU:
\[ \operatorname{ReLU}(z)=\max(0,z) = \begin{cases} 0, & z\le0,\\ z, & z>0. \end{cases} \]
При одном входе нейрон:
\[ h(x)=\operatorname{ReLU}(wx+b). \]
При \(w\ne0\) аффинный скор пересекает ноль в
\[ x_{\text{break}}=-\frac{b}{w}. \]
По одну сторону точки излома ответ нулевой, по другую — линейный. Вес \(w\) задаёт ориентацию и наклон скора, \(b\) помогает расположить излом.
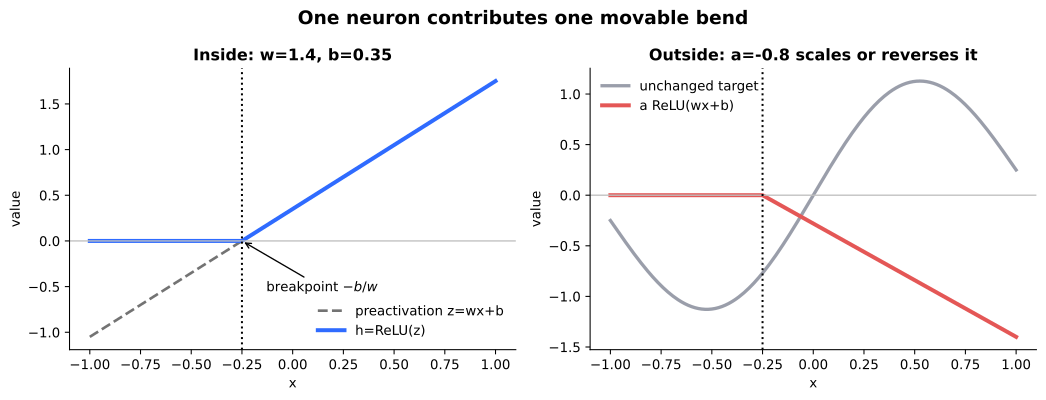
Нейрон на Рисунок 2 не воспроизводит всю цель: он даёт простой геометрический элемент, подвижный излом. Следующий слой выходным весом масштабирует или обращает вклад.
Почему глубине нужна нелинейность
До объединения изломов исключим активации. Пусть два последовательных слоя аффинны:
\[ \mathbf h=\mathbf W^{(1)}\mathbf x+\mathbf b^{(1)}, \qquad \mathbf y=\mathbf W^{(2)}\mathbf h+\mathbf b^{(2)}. \]
Подстановка первого во второй даёт:
\[ \begin{aligned} \mathbf y &=\mathbf W^{(2)} \left(\mathbf W^{(1)}\mathbf x+\mathbf b^{(1)}\right) +\mathbf b^{(2)}\\ &=\left(\mathbf W^{(2)}\mathbf W^{(1)}\right)\mathbf x +\left(\mathbf W^{(2)}\mathbf b^{(1)}+\mathbf b^{(2)}\right). \end{aligned} \]
Обозначим:
\[ \widetilde{\mathbf W}=\mathbf W^{(2)}\mathbf W^{(1)}, \qquad \widetilde{\mathbf b} =\mathbf W^{(2)}\mathbf b^{(1)}+\mathbf b^{(2)}. \]
Тогда всё двухслойное вычисление равно:
\[ \mathbf y=\widetilde{\mathbf W}\mathbf x+\widetilde{\mathbf b}. \]
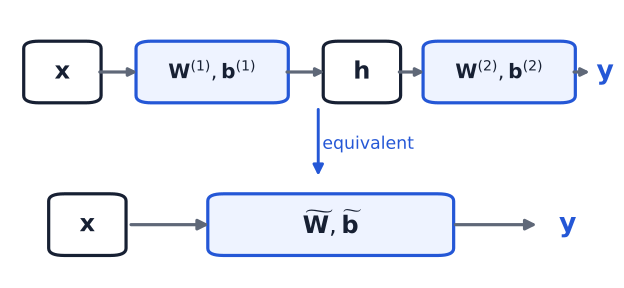
Аргумент повторяется: любая конечная композиция аффинных отображений аффинна. Дополнительные матрицы меняют факторизацию той же функции, но не создают нелинейную зависимость вход–выход. Нелинейные активации предотвращают свёртку Рисунок 3.
Несколько изломов образуют более богатую функцию
Пусть скрытый слой имеет \(H\) ReLU-нейронов с общим скалярным входом. Линейный выход объединяет активации:
\[ h_j(x)=\operatorname{ReLU}(w_jx+b_j), \qquad \hat f(x)=b_2+\sum_{j=1}^{H}a_jh_j(x). \]
Пара \((w_j,b_j)\) задаёт место и ориентацию излома. Вес \(a_j\) масштабирует или обращает его вклад; \(b_2\) сдвигает всю сумму вертикально.
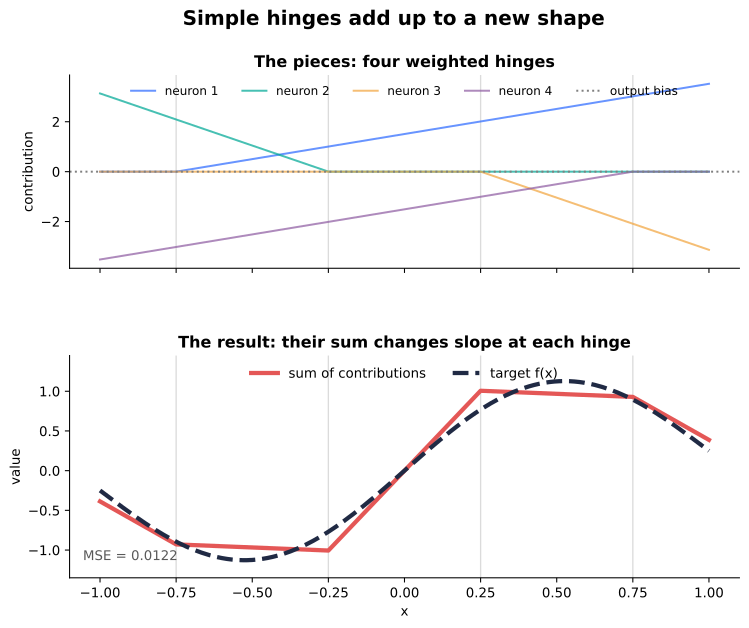
Между соседними точками излома набор активных нейронов не меняется. Вклад каждого активного нейрона на этом интервале является аффинной функцией, поэтому их сумма также аффинна. В точке излома один нейрон меняет состояние, и общий наклон может измениться. Поэтому функция на Рисунок 4 непрерывна и кусочно-линейна.
Это более узкое объяснение, чем теорема универсальной аппроксимации: несколько простых нелинейных компонентов создают функции, недоступные одному аффинному отображению.
nn.Linear PyTorch вычисляет аффинную часть \(\mathbf W\mathbf x+\mathbf b\). Несмотря на название, смещение делает её математически аффинной. ReLU и другие активации — отдельные операции.
Теперь соберём параллельные нейроны в векторы и зададим размерности.
Слои, формы тензоров и прямой проход
От нейрона к слою
Слой \(\ell\) ширины \(d_\ell\) принимает вектор из \(d_{\ell-1}\) компонентов. У каждого выходного нейрона своя строка весов и смещение. Для одного примера:
\[ \mathbf h^{(0)}=\mathbf x, \]
Для последующих слоёв:
\[ \mathbf z^{(\ell)} =\mathbf W^{(\ell)}\mathbf h^{(\ell-1)} +\mathbf b^{(\ell)}, \qquad \mathbf h^{(\ell)} =\phi_\ell\!\left(\mathbf z^{(\ell)}\right). \]
Если не указано иное, активация поэлементная. Формы:
\[ \mathbf h^{(\ell-1)}\in\mathbb R^{d_{\ell-1}}, \qquad \mathbf W^{(\ell)}\in \mathbb R^{d_\ell\times d_{\ell-1}}, \]
\[ \mathbf b^{(\ell)},\mathbf z^{(\ell)},\mathbf h^{(\ell)} \in\mathbb R^{d_\ell}. \]
Строка \(j\) матрицы \(\mathbf W^{(\ell)}\) — веса выходного нейрона \(j\); умножение на \(\mathbf h^{(\ell-1)}\) даёт его взвешенную сумму. Все строки вычисляют слой одной матричной операцией.
Один пример и батч по строкам
Столбцы удобны для чтения одного примера. PyTorch обычно хранит батч из \(B\) примеров строками:
\[ \mathbf H^{(\ell-1)} \in\mathbb R^{B\times d_{\ell-1}}. \]
Матрица весов всё ещё хранится как
\[ \mathbf W^{(\ell)} \in\mathbb R^{d_\ell\times d_{\ell-1}}, \]
поэтому батчевая формула использует транспонирование:
\[ \mathbf Z^{(\ell)} =\mathbf H^{(\ell-1)}\mathbf W^{(\ell)\top} +\mathbf b^{(\ell)} \in\mathbb R^{B\times d_\ell}. \]
Форма умножения:
\[ (B\times d_{\ell-1}) (d_{\ell-1}\times d_\ell) =B\times d_\ell. \]
Смещение имеет форму \((d_\ell,)\) и повторяется по строкам: broadcasting действует как добавление того же вектора ко всем \(B\) строкам. Отдельное смещение для каждого примера не обучается.
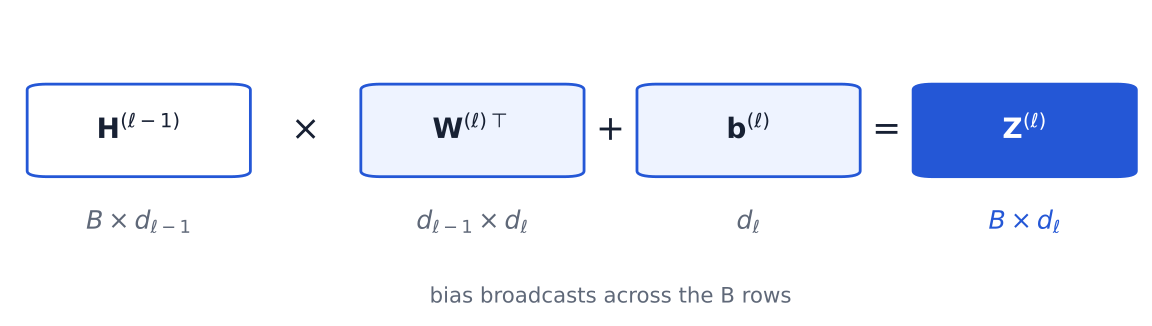
Рисунок 5 — не формальный учёт: неверная форма часто показывает смешение осей примеров, входных признаков и выходных нейронов.
Полный пример прямого прохода \(2\to3\to1\)
Один вход с двумя признаками:
\[ \mathbf x= \begin{bmatrix} 2\\-1 \end{bmatrix}. \]
В первом слое три ReLU-нейрона:
\[ \mathbf W^{(1)}= \begin{bmatrix} 0.5&1\\ -1&0.5\\ 1&1 \end{bmatrix}, \qquad \mathbf b^{(1)}= \begin{bmatrix} 0.5\\0\\-0.5 \end{bmatrix}. \]
Три предактивации:
\[ \begin{aligned} \mathbf z^{(1)} &=\mathbf W^{(1)}\mathbf x+\mathbf b^{(1)}\\ &= \begin{bmatrix} 0.5(2)+1(-1)+0.5\\ -1(2)+0.5(-1)+0\\ 1(2)+1(-1)-0.5 \end{bmatrix}\\ &= \begin{bmatrix} 0.5\\-2.5\\0.5 \end{bmatrix}. \end{aligned} \]
Поэлементная ReLU даёт:
\[ \mathbf h^{(1)} =\operatorname{ReLU}(\mathbf z^{(1)}) = \begin{bmatrix} 0.5\\0\\0.5 \end{bmatrix}. \]
Второй слой аффинный, то есть его активация тождественная:
\[ \mathbf W^{(2)}= \begin{bmatrix} 2&-1&1 \end{bmatrix}, \qquad b^{(2)}=-0.5. \]
Следовательно:
\[ \begin{aligned} \hat y &=\mathbf W^{(2)}\mathbf h^{(1)}+b^{(2)}\\ &=2(0.5)-1(0)+1(0.5)-0.5\\ &=1. \end{aligned} \]
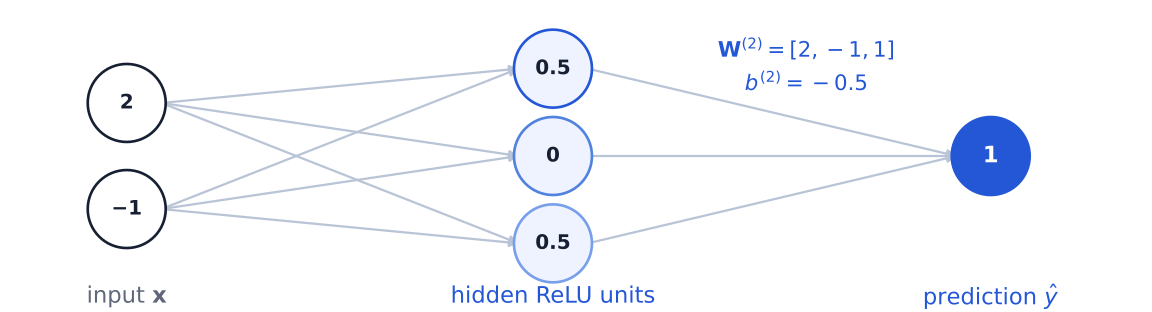
Рисунок 6 показывает прямое распространение (forward propagation): операции вычисляются в порядке зависимостей при текущих параметрах. Сам проход не выполняет обучения.
Читать nn.Linear как математику
Для X формы (B, 2) слой nn.Linear(2, 3) хранит weight формы (3, 2), bias формы (3,), выдаёт (B, 3) (PyTorch contributors, б. д.-d). Самостоятельная проверка использует \(B=4\); алгебра верна для любого батча:
import torch
from torch import nn

B = 4
X = torch.zeros(B, 2)
layer = nn.Linear(in_features=2, out_features=3)

Z = layer(X)
Z_explicit = X @ layer.weight.T + layer.bias

torch.testing.assert_close(Z, Z_explicit)
assert Z.shape == (X.shape[0], 3)
Транспонирование нужно, потому что строки X — примеры, строки layer.weight — выходные нейроны. Смещение распространяется по батчу. ReLU слой не применяет:
H = torch.relu(layer(X))Это две разные операции. Различие важно для сохранения промежуточных значений и обратного распространения чувствительности по той же последовательности.
Прямой проход ответил на первый вопрос обучения: какое предсказание даёт параметризованная композиция для этих входов?
От выходов сети к цели обучения
Смысл выхода зависит от задачи
Прямой проход заканчивается числами, но одна архитектура не определяет их смысл. Задача задаёт толкование выхода и сравнение с целью. Рассмотрим три распространённых случая.
| Задача | Выход последнего слоя | Смысл и типичная потеря |
|---|---|---|
| Регрессия | Одно или несколько неограниченных значений | Предсказания в единицах цели; MSE уместна, если квадратичная ошибка соответствует задаче. |
| Бинарная классификация | Один неограниченный логит \(z_i\) | Вероятность \(q_i=\sigma(z_i)\); устойчивый интерфейс BCE принимает логиты напрямую. |
| Многоклассовая классификация | \(K\) неограниченных логитов \(z_{i1},\ldots,z_{iK}\) | Softmax вероятностей взаимоисключающих классов; CE использует наблюдаемый класс. |
Тождественная активация регрессии не ограничивает предсказание. Потеря не обязательно квадратична: возможны абсолютная и специальные цели. Смысл и форма выхода должны соответствовать потере.
В бинарной классификации единственный логит сам по себе не является вероятностью. Сигмоида переводит его в число между нулём и единицей. В PyTorch binary_cross_entropy_with_logits и nn.BCEWithLogitsLoss принимают исходный логит и объединяют вычисление сигмоиды с бинарной перекрёстной энтропией. Это позволяет избежать менее устойчивой последовательности отдельных операций с явным вычислением вероятностей (PyTorch contributors, б. д.-b).
При многоклассовой задаче пример \(i\) получает \(K\) логитов. Скор класса \(k\) обозначим \(z_{ik}\). Softmax переводит вектор в вероятности:
\[ q_{ik} = \frac{\exp z_{ik}} {\sum_j \exp z_{ij}}. \]
Вероятности положительны, суммируются в единицу и сохраняют порядок логитов.
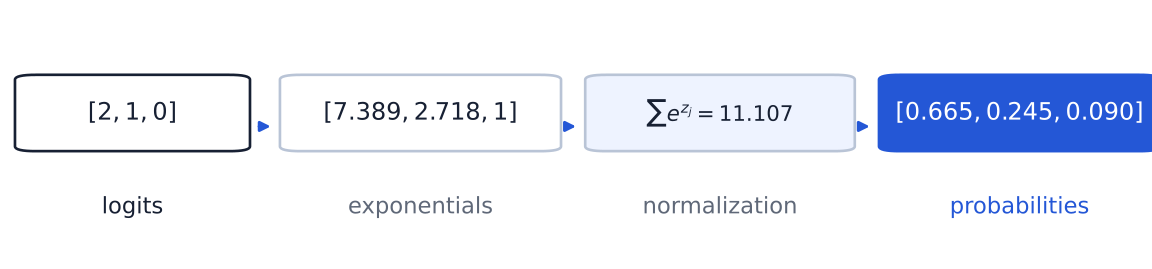
Рисунок 7 различает выход сети — логиты — и их нормировку Softmax. Цель не входит в Softmax, а используется позже при вычислении потери наблюдаемого класса.
Softmax зависит от относительных уровней: общая константа \(r\) сохраняет все вероятности:
\[ \frac{\exp(z_{ik}+r)}{\sum_j\exp(z_{ij}+r)} = \frac{\exp(r)\exp(z_{ik})} {\exp(r)\sum_j\exp(z_{ij})} =q_{ik}. \]
Устойчивые реализации вычитают удобную константу, обычно максимум, до экспоненты. То же тождество объясняет, почему argmax не требует Softmax:
\[ \operatorname*{arg\,max}_k z_{ik} = \operatorname*{arg\,max}_k q_{ik}. \]
Вероятности нужны для вероятностного выхода или потери. Их калибровка — отдельный эмпирический вопрос; класс максимального скора не меняется.
Перекрёстная энтропия и соглашение о цели
Пусть \(c_i\) — индекс наблюдаемого класса примера \(i\), \(y_{ik}\) — one-hot элемент: \(y_{ik}=1\) у наблюдаемого класса, \(0\) иначе. Потеря CE записывается эквивалентно:
\[ \ell_i = -\log q_{i,c_i} = -\sum_k y_{ik}\log q_{ik}. \]
Первая форма выбирает класс целым индексом, вторая делает тот же выбор one-hot вектором. Это представления одной цели, не разные наблюдаемые классы.
Для проверенных логитов
\[ [2,1,0], \]
Softmax даёт:
\[ [2,1,0] \longmapsto [0.665241,\;0.244728,\;0.090031]. \]
Пусть наблюдается второй класс при названиях с единицы. Его вероятность \(0.244728\), поэтому
\[ \ell=-\log(0.244728)\approx1.407606. \]
«Второй класс» — учебное именование с единицы. PyTorch индексирует с нуля: цель 1, не 2; one-hot представление \([0,1,0]\). Все три записи обозначают одну категорию:
- название для читателя: класс 2;
- индекс PyTorch:
1; - one-hot цель: \([0,1,0]\).
Для батча \(B\) примеров и \(K\) классов типичный интерфейс:
import torch.nn.functional as F

# logits: (B, K)
# targets: (B,) of dtype torch.long
loss = F.cross_entropy(logits, targets)
F.cross_entropy принимает логиты, а не вероятности после предварительного Softmax. Для целевых индексов классов она объединяет log-softmax и отрицательное логарифмическое правдоподобие в численно устойчивом вычислении. Для рассматриваемого батча без весов и игнорируемых целей редукция по умолчанию — среднее по батчу; другие редукции можно задать явно. Допустимые формы входов и целей, а также более общий случай взвешенной редукции описаны в официальной документации (PyTorch contributors, б. д.-c).
Так строится скалярная цель без повторения категориального правдоподобия, его максимизации, энтропии и KL, относящихся к неделе 07. Теперь вопрос обратного распространения: как каждый связанный параметр получает свою чувствительность к известной скалярной потере?
Обратное распространение начинается со скалярного графа
Вычисление по отдельным узлам
Формула вроде \(L(f_\theta(x),y)\) скрывает промежуточные зависимости потери от параметра. Вычислительный граф (computation graph) раскрывает их. Рассмотрим скалярную сеть:
\[ z=wx+b, \qquad h=\operatorname{ReLU}(z), \qquad \hat y=ah+c, \qquad L=\frac12(\hat y-y)^2. \]
Используем проверенные значения:
\[ x=3,\quad y=2,\quad w=2,\quad b=-1,\quad a=0.4,\quad c=-1. \]
Прямой проход вычисляет узел после входов: \(z=5\), \(h=5\), \(\hat y=1\), \(L=0.5\).
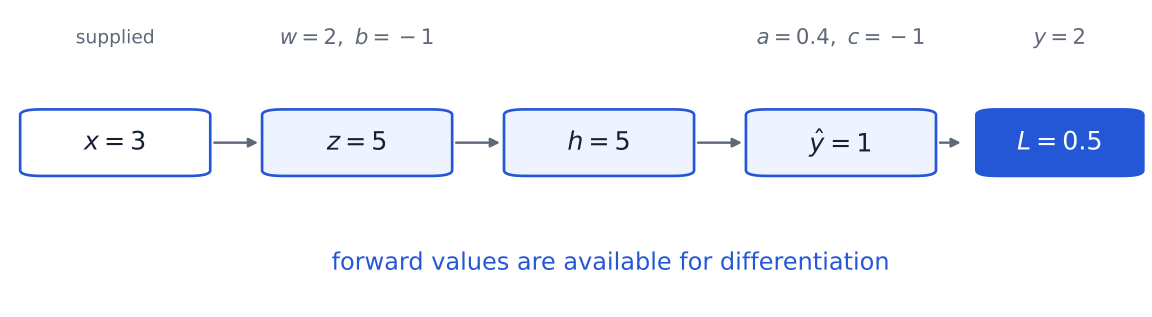
Рисунок 8 — та же модель четырёх уравнений с нужными последующим операциям значениями. Обратный проход идёт по зависимостям в обратном порядке.
Локальные производные и входящие чувствительности
Градиент — локальная чувствительность. Например, \(\partial L/\partial w\) описывает изменение текущей потери в первом порядке при малом изменении \(w\), фиксируя остальные входы. Это ещё не обновление параметра.
Начинаем от скалярной потери с затравкой:
\[ \frac{\partial L}{\partial L}=1. \]
Каждый узел получает входящую чувствительность от операций, расположенных ближе к потере, умножает её на собственную локальную производную и передаёт результат своим входам. Единая таблица ниже объединяет все заданные и вычисленные значения прямого прохода с полным обратным проходом. Целевое значение \(y\) включено для полноты, хотя оно наблюдается, а не оптимизируется.
| Узел | Прямое значение | Входящая чувствительность | Локальная производная | Итоговая чувствительность |
|---|---|---|---|---|
| \(L\) | \(0.5\) | — | \(\partial L/\partial L=1\) | затравка \(1\) |
| \(\hat y\) | \(1\) | \(1\) | \(\partial L/\partial\hat y=\hat y-y=-1\) | \(\partial L/\partial\hat y=-1\) |
| \(y\) | \(2\) (цель) | \(1\) | \(\partial L/\partial y=y-\hat y=1\) | \(\partial L/\partial y=1\) |
| \(a\) | \(0.4\) | \(\partial L/\partial\hat y=-1\) | \(\partial\hat y/\partial a=h=5\) | \(\partial L/\partial a=-5\) |
| \(c\) | \(-1\) | \(\partial L/\partial\hat y=-1\) | \(\partial\hat y/\partial c=1\) | \(\partial L/\partial c=-1\) |
| \(h\) | \(5\) | \(\partial L/\partial\hat y=-1\) | \(\partial\hat y/\partial h=a=0.4\) | \(\partial L/\partial h=-0.4\) |
| \(z\) | \(5\) | \(\partial L/\partial h=-0.4\) | \(\partial h/\partial z=1\), поскольку \(z>0\) | \(\partial L/\partial z=-0.4\) |
| \(w\) | \(2\) | \(\partial L/\partial z=-0.4\) | \(\partial z/\partial w=x=3\) | \(\partial L/\partial w=-1.2\) |
| \(b\) | \(-1\) | \(\partial L/\partial z=-0.4\) | \(\partial z/\partial b=1\) | \(\partial L/\partial b=-0.4\) |
| \(x\) | \(3\) | \(\partial L/\partial z=-0.4\) | \(\partial z/\partial x=w=2\) | \(\partial L/\partial x=-0.8\) |
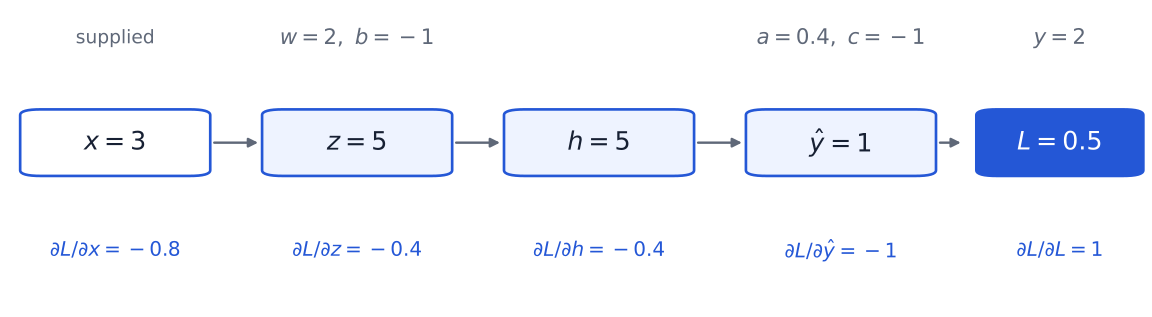
Два выделенных результата Рисунок 9:
\[ \frac{\partial L}{\partial w}=-1.2, \qquad \frac{\partial L}{\partial x}=-0.8. \]
Производная по \(x\) важна, хотя \(x\) здесь не обучаемый параметр: предыдущий слой получил бы её как входящую чувствительность. Для параметров и промежуточных активаций правило одинаково; оптимизатор позже выбирает обучаемые листья для обновления.
Почему пути перемножаются, а ветви складываются
Вдоль пути цепное правило перемножает локальные скорости изменения. Для \(w\) путь к потере один:
\[ w\longrightarrow z\longrightarrow h\longrightarrow\hat y\longrightarrow L, \]
поэтому
\[ \frac{\partial L}{\partial w} = \frac{\partial L}{\partial\hat y} \frac{\partial\hat y}{\partial h} \frac{\partial h}{\partial z} \frac{\partial z}{\partial w} =(-1)(0.4)(1)(3)=-1.2. \]
Каждый множитель описывает одно ребро; произведение — изменение \(w\) после всей цепи зависимостей.
Если значение влияет на потерю несколькими путями, полный эффект первого порядка — сумма вкладов. Простейший пример ветвления: \(u_1=rh\), \(u_2=sh\), \(L=L_1(u_1)+L_2(u_2)\). Тогда:
\[ \frac{\partial L}{\partial h} = \frac{\partial L_1}{\partial u_1}r + \frac{\partial L_2}{\partial u_2}s. \]
Это не дополнительное соглашение backprop, а многомерное цепное правило всех путей влияния \(h\) на \(L\). Сумма градиентов смещения по батчу имеет тот же смысл.
ReLU определяет активность пути:
\[ \frac{d}{dz}\operatorname{ReLU}(z) = \begin{cases} 0,&z<0,\\ 1,&z>0. \end{cases} \]
Здесь \(z=5\), поэтому чувствительность проходит без изменения. Если \(z<0\), локальная производная равна нулю и все градиенты раньше по этому пути также обращаются в ноль. Нулевой градиент может означать, что именно этот путь через ReLU неактивен для данного входа; сам по себе он не доказывает сходимость модели. В точности в нуле ReLU недифференцируема. Документированное правило PyTorch выбирает в этой точке субградиент минимальной нормы, равный нулю (PyTorch contributors, б. д.-a).
Независимая численная проверка
Центральная разность оценивает производную без обратной таблицы. Фиксируем остальное и берём \(\varepsilon=10^{-5}\):
\[ \frac{L(w+\varepsilon)-L(w-\varepsilon)}{2\varepsilon} = \frac{0.499988000072-0.500012000072}{2\times10^{-5}} =-1.200000000021. \]
Результат согласуется с \(\partial L/\partial w=-1.2\) в пределах точности. Разности полезны для проверки, но требуют новых прямых вычислений каждого возмущённого параметра. Backprop получает все связанные чувствительности одним обратным обходом.
Размер шага уравновешивает две ошибки. При слишком большом \(\varepsilon\) конечный интервал плохо приближает локальную производную; при слишком малом вычитание почти одинаковых потерь в арифметике с плавающей точкой усиливает ошибку округления. Поэтому проверка должна задавать абсолютный или относительный допуск, а не требовать побитового равенства. В гладкой точке короткого вычисления в float64 допуск порядка \(10^{-5}\) часто подходит как отправная точка, но конкретное значение зависит от масштаба и глубины вычислений. Возмущение, пересекающее излом ReLU, сравнивает разные линейные области; расхождение в таком случае не обязательно указывает на неверное правило обратного прохода.
Обратное распространение заканчивается градиентами. Правило \(w\leftarrow w-\eta\,\partial L/\partial w\) — отдельная оптимизация. Практикум содержит независимый скалярный граф с другими числами; не смешивайте их с этим расчётом.
От скалярных производных к матричному backprop
Батчевый аффинный слой с активацией
К массивам применяется та же локальная логика цепного правила. Примеры по строкам: батч \(B\), ширины входа \(d_{\mathrm{in}}\) и выхода \(d_{\mathrm{out}}\):
\[ \mathbf Z = \mathbf H_{\mathrm{in}}\mathbf W^\top+\mathbf b, \qquad \mathbf H=\phi(\mathbf Z). \]
Формы:
\[ \mathbf H_{\mathrm{in}}\in\mathbb R^{B\times d_{\mathrm{in}}}, \quad \mathbf W\in\mathbb R^{d_{\mathrm{out}}\times d_{\mathrm{in}}}, \quad \mathbf b\in\mathbb R^{d_{\mathrm{out}}}, \]
\[ \mathbf Z,\mathbf H\in\mathbb R^{B\times d_{\mathrm{out}}}. \]
Пусть оставшаяся сеть и потеря уже дали входящую чувствительность:
\[ \mathbf G_H = \frac{\partial L}{\partial\mathbf H} \in\mathbb R^{B\times d_{\mathrm{out}}}. \]
Для поэлементной активации первый обратный шаг тоже поэлементен:
\[ \mathbf G_Z = \mathbf G_H\odot\phi'(\mathbf Z) \in\mathbb R^{B\times d_{\mathrm{out}}}. \]
Для ReLU \(\phi'(\mathbf Z)\) — маска пропуска/блокировки. Положительная предактивация пропускает чувствительность, отрицательная блокирует.
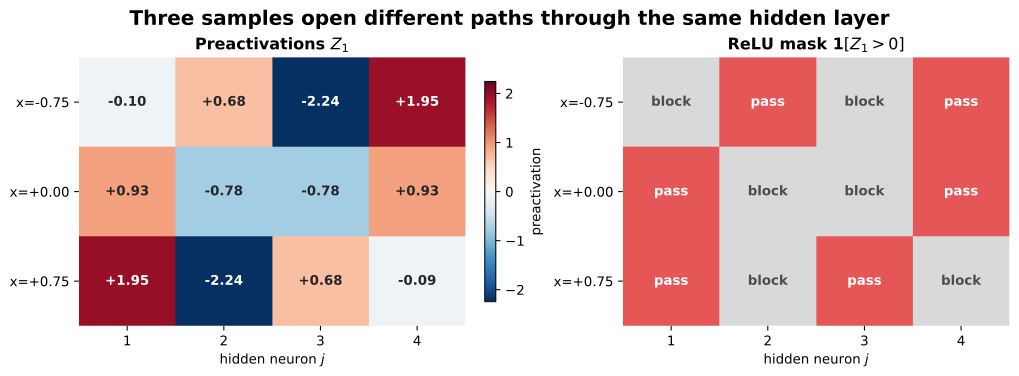
Рисунок 10 показывает разные активные пути общего слоя для разных строк. Маска имеет ту же форму \(B\times d_{\mathrm{out}}\), что предактивация и чувствительность.
Сначала производная одного веса, затем матрица
Предактивация \((i,j)\) равна:
\[ Z_{ij} = \sum_{k=1}^{d_{\mathrm{in}}} H_{\mathrm{in},ik}W_{jk}+b_j. \]
Параметр \(W_{jk}\) общий для всех \(B\) строк. Для строки \(i\):
\[ \frac{\partial Z_{ij}}{\partial W_{jk}} =H_{\mathrm{in},ik}. \]
Полное влияние на скалярную потерю суммирует все строки:
\[ \frac{\partial L}{\partial W_{jk}} = \sum_{i=1}^{B} \frac{\partial L}{\partial Z_{ij}} \frac{\partial Z_{ij}}{\partial W_{jk}} = \sum_{i=1}^{B} G_{Z,ij}H_{\mathrm{in},ik}. \]
Это элемент \((j,k)\) произведения: строка \(j\) у \(\mathbf G_Z^\top\) содержит \(G_{Z,1j},\ldots,G_{Z,Bj}\), столбец \(k\) у \(\mathbf H_{\mathrm{in}}\) содержит \(H_{\mathrm{in},1k},\ldots,H_{\mathrm{in},Bk}\). Собирая все \((j,k)\), получаем:
\[ \frac{\partial L}{\partial\mathbf W} = \mathbf G_Z^\top\mathbf H_{\mathrm{in}} \in\mathbb R^{d_{\mathrm{out}}\times d_{\mathrm{in}}}. \]
Транспонирование следует и из смысла, и из формы:
\[ (d_{\mathrm{out}}\times B) (B\times d_{\mathrm{in}}) =d_{\mathrm{out}}\times d_{\mathrm{in}}, \]
совпадающей с хранимой матрицей весов.
Каждое смещение \(b_j\) влияет на выход \(j\) каждой строки с производной один; градиент суммируется по оси батча:
\[ \frac{\partial L}{\partial\mathbf b} = \sum_{i=1}^{B}\mathbf G_{Z,i} \in\mathbb R^{d_{\mathrm{out}}}. \]
Чувствительность предыдущему слою:
\[ \frac{\partial L}{\partial\mathbf H_{\mathrm{in}}} = \mathbf G_Z\mathbf W \in\mathbb R^{B\times d_{\mathrm{in}}}, \]
поскольку
\[ (B\times d_{\mathrm{out}}) (d_{\mathrm{out}}\times d_{\mathrm{in}}) =B\times d_{\mathrm{in}}. \]
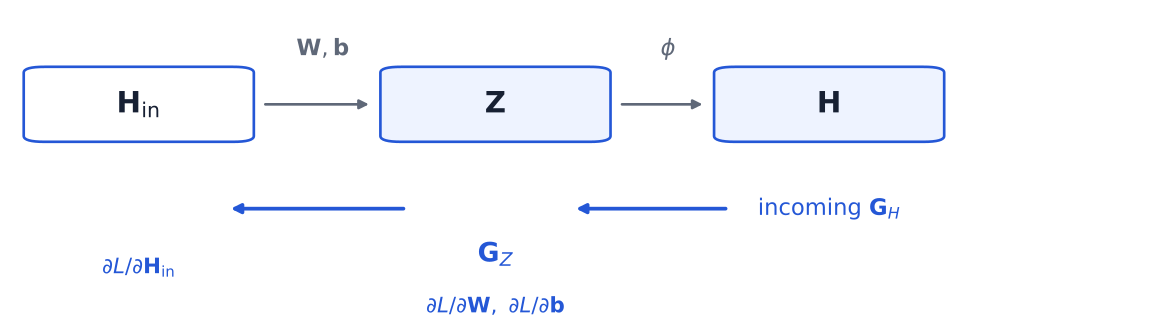
Три пути Рисунок 11 — массивный вариант скалярного графа. Производные перемножаются по зависимостям, общие параметры собирают все встречающиеся вклады.
Малый батч с разными активными путями
Возьмём \(B=3\), \(d_{\mathrm{in}}=2\), \(d_{\mathrm{out}}=2\):
\[ \mathbf H_{\mathrm{in}}= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}. \]
\[ \mathbf W= \begin{bmatrix} 1&-1\\ -1&2 \end{bmatrix}, \qquad \mathbf b= \begin{bmatrix} 0.2&0.5 \end{bmatrix}. \]
Прямые предактивации и маска ReLU:
\[ \mathbf Z= \begin{bmatrix} 1.2&-0.5\\ -0.8&2.5\\ 0.2&1.5 \end{bmatrix}, \qquad \phi'(\mathbf Z)= \begin{bmatrix} 1&0\\ 0&1\\ 1&1 \end{bmatrix}. \]
Первый пример включает только путь 1, второй — 2, третий — оба. Пусть входящая чувствительность:
\[ \mathbf G_H= \begin{bmatrix} 1&2\\ -1&1\\ 0.5&-2 \end{bmatrix}. \]
После маски:
\[ \mathbf G_Z = \begin{bmatrix} 1&0\\ 0&1\\ 0.5&-2 \end{bmatrix}. \]
Тогда градиенты слоя:
\[ \frac{\partial L}{\partial\mathbf W} = \begin{bmatrix} 1.5&0.5\\ -2&-1 \end{bmatrix}. \]
\[ \frac{\partial L}{\partial\mathbf b} = \begin{bmatrix} 1.5&-1 \end{bmatrix}, \]
\[ \frac{\partial L}{\partial\mathbf H_{\mathrm{in}}} = \begin{bmatrix} 1&-1\\ -1&2\\ 2.5&-4.5 \end{bmatrix}. \]
Градиент смещения делает редукцию явной: первый элемент \(1+0+0.5=1.5\), второй \(0+1-2=-1\). Повторение смещения во всех прямых строках требует суммирования обратных вкладов.
Сумма, среднее и повторение локальных правил
Формулы не выбирают редукцию скрыто. Предполагается, что \(\mathbf G_H\) — производная настоящей скалярной потери \(L\). Если
\[ L_{\mathrm{sum}}=\sum_{i=1}^{B}\ell_i, \]
то входящая чувствительность содержит производные суммы. Если же
\[ L_{\mathrm{mean}}=\frac1B\sum_{i=1}^{B}\ell_i, \]
то вклады уже включают множитель \(1/B\). Формулы слоя неизменны; на том же батче градиенты среднего равны соответствующим градиентам суммы, умноженным на \(1/B\).
В MLP правила повторяются в обратном порядке слоёв. В слое \(\ell\) вычислите:
\[ \mathbf G_Z^{(\ell)} = \mathbf G_H^{(\ell)}\odot \phi_\ell'(\mathbf Z^{(\ell)}), \]
найдите по нему градиенты \(\mathbf W^{(\ell)}\), \(\mathbf b^{(\ell)}\) и передайте
\[ \mathbf G_H^{(\ell-1)} = \mathbf G_Z^{(\ell)}\mathbf W^{(\ell)} \]
предыдущему слою. У аффинного выхода с тождественной активацией производная один, поэтому там \(\mathbf G_Z=\mathbf G_H\).
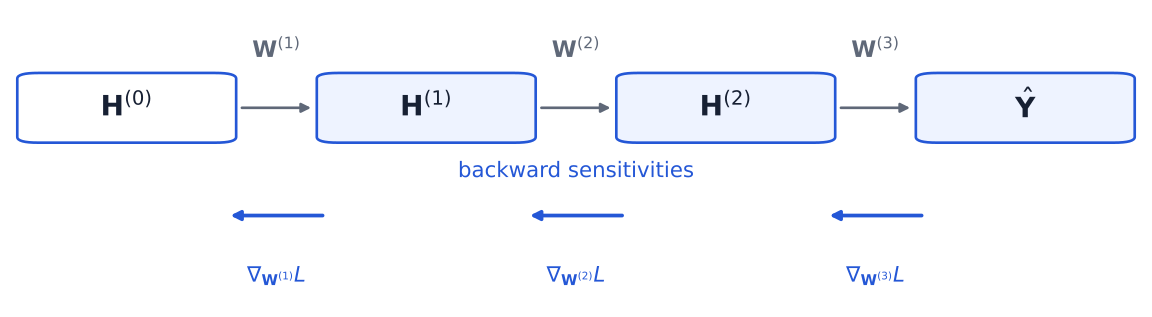
Каждое умножение на локальную производную — произведение вектора на якобиан (vector–Jacobian product, VJP): оно объединяет чувствительность, пришедшую от последующих вычислений, с локальной производной текущей операции. Обратное распространение вычисляет такие произведения непосредственно, не создавая и не сохраняя полную матрицу Якоби для каждого слоя. Поэтому Рисунок 12 показывает один повторяющийся принцип, а не отдельную формулу для каждой возможной архитектуры.
Скалярная таблица и матричные тождества задают вычисления обратного режима. Практикум проверяет их по PyTorch autograd; вместе это проверяемая математическая спецификация автоматики.
Autograd реализует математику
Автоматическая запись того же обратного прохода
Autograd в PyTorch реализует дифференцирование обратного режима, разобранное в двух предыдущих разделах. Когда запись градиентов включена, прямой проход выполняет две задачи: вычисляет значения тензоров и записывает операции и зависимости, необходимые для последующего обратного прохода. Вызов backward() для скалярной потери задаёт уже знакомую начальную чувствительность
\[ \frac{\partial L}{\partial L}=1 \]
и идёт по графу назад, применяя локальные VJP. Связанные листовые тензоры с градиентами получают накопленные чувствительности в .grad (PyTorch contributors, б. д.-a).
Математика от этого не меняется. Autograd автоматизирует учёт, который иначе пришлось бы вести в скалярной таблице или повторять по правилам слоёв. Он не решает, какая модель представляет задачу, какая потеря выражает цель, какой оптимизатор должен использовать градиенты и какие научные выводы подтверждает полученный эксперимент.
Скалярный пример почти построчно записывается в PyTorch:
import torch

x = torch.tensor(3.0, requires_grad=True)
w = torch.tensor(2.0, requires_grad=True)
b = torch.tensor(-1.0, requires_grad=True)
a = torch.tensor(0.4, requires_grad=True)
c = torch.tensor(-1.0, requires_grad=True)
y = torch.tensor(2.0)

z = w * x + b
h = torch.relu(z)
y_hat = a * h + c
loss = 0.5 * (y_hat - y) ** 2
loss.backward()

actual = torch.stack([a.grad, c.grad, w.grad, b.grad, x.grad])
expected = torch.tensor([-5.0, -1.0, -1.2, -0.4, -0.8])
torch.testing.assert_close(actual, expected)
Последняя проверка подтверждает пять ручных результатов: w.grad — \(-1.2\), x.grad — \(-0.8\). loss.backward() заполнил градиенты, но не изменил значения \(w,b,a,c\).
Листья, промежуточные тензоры и сохранённые градиенты
requires_grad=True сообщает, что операции с тензором могут участвовать в обратном режиме. Здесь \(x,w,b,a,c\) — листовые тензоры: созданы непосредственно, не записанной операцией. z, h, y_hat, loss — нелистовые, полученные внутри графа.
Обучаемые объекты nn.Parameter обычно являются листовыми по той же практической причине. Оптимизатору нужен устойчивый набор тензоров, у которых он может читать поля .grad. Градиенты нелистовых тензоров всё равно вычисляются при прохождении чувствительностей по графу, но по умолчанию PyTorch не сохраняет их в .grad. Поэтому после предыдущего примера:
assert w.is_leaf and w.grad is not None
assert not z.is_leaf
z.grad  # None by default; PyTorch may also emit a reminder warning
Это не пропуск производной z: без неё ненулевые w.grad, b.grad, x.grad не получились бы. Для диагностики вызовите retain_grad() у промежуточного тензора до backward (PyTorch contributors, б. д.-g):
for tensor in (x, w, b, a, c):
    tensor.grad = None

z_check = w * x + b
z_check.retain_grad()
h_check = torch.relu(z_check)
loss_check = 0.5 * (a * h_check + c - y) ** 2
loss_check.backward()

torch.testing.assert_close(z_check.grad, torch.tensor(-0.4))
Сохранение всех промежуточных градиентов расходует память без пользы обычному обновлению; это инструмент адресной диагностики.
Накопление сделано намеренно
В пределах одного обратного прохода autograd складывает вклады всех путей графа по правилу цепочки. Между отдельными вызовами backward PyTorch прибавляет новый градиент листового тензора к значению, уже сохранённому в .grad. Первое поведение необходимо для вычислительного графа; второе позволяет намеренно накапливать градиенты нескольких мини-батчей и объясняет, почему перед новым обновлением их обычно очищают.
Пример изолирует второй эффект: w.grad уже заполнен после loss_check.backward(). Новый forward строит новый граф того же вычисления, новый backward добавляет его градиент к старому:
first_w_grad = w.grad.clone()

# Recompute the forward pass because the first graph was released.
loss_again = 0.5 * (a * torch.relu(w * x + b) + c - y) ** 2
loss_again.backward()

torch.testing.assert_close(w.grad, 2 * first_w_grad)

for tensor in (x, w, b, a, c):
    tensor.grad = None
assert all(tensor.grad is None for tensor in (x, w, b, a, c))
Прямой проход вычисляется заново, потому что обычный вызов backward освобождает использованную информацию графа. Поэтому второй вызов добавляет ещё \(-1.2\) в w.grad, и сохранённое значение становится \(-2.4\). Очистка градиентов восстанавливает нужные начальные условия для нового обновления при обучении. Обычно её поручают optimizer.zero_grad() (PyTorch contributors, б. д.-e).
Разорвать зависимость через detach()
Иногда численное значение нужно использовать повторно, не позволяя последующей потере передавать чувствительность через историю его получения. detach() возвращает тензор, отключённый от создавшего его графа. Это не простое копирование данных: возвращённый тензор разделяет память с исходным, поэтому изменения in-place могут быть видны обоим. Отключение одного тензора также не переводит модель в режим оценки (PyTorch contributors, б. д.-f).
В скалярной сети отключение \(h\) блокирует путь к \(z,w,b,x\), но последующие листья \(a\), \(c\) остаются связаны:
for tensor in (x, w, b, a, c):
    tensor.grad = None

z_cut = w * x + b
h_cut = torch.relu(z_cut).detach()
loss_cut = 0.5 * (a * h_cut + c - y) ** 2
loss_cut.backward()

assert w.grad is None and b.grad is None and x.grad is None
torch.testing.assert_close(a.grad, torch.tensor(-5.0))
torch.testing.assert_close(c.grad, torch.tensor(-1.0))
Это свойство графа, не исчезновение раннего численного расчёта: h_cut по-прежнему \(5\).
Три часто смешиваемых средства действуют на разных уровнях:
| Средство | Что меняет | Чего не делает |
|---|---|---|
tensor.detach() |
Возвращает тензор с общей памятью, отключённый от прежней истории autograd. | Не меняет режим обучения/оценки модели. |
with torch.no_grad(): |
Не записывает обычные операции контекста для обратного режима. | Не переключает модель на оценочное поведение. |
model.eval() |
Переключает модули с особым поведением при оценке. | Не выключает глобально запись градиентов. |
При валидации обычно нужны оба: model.eval() и no-grad. Первое выбирает поведение модулей, второе исключает ненужный граф. Возвращение к обучению — model.train(). Это независимые средства (PyTorch contributors, б. д.-a).
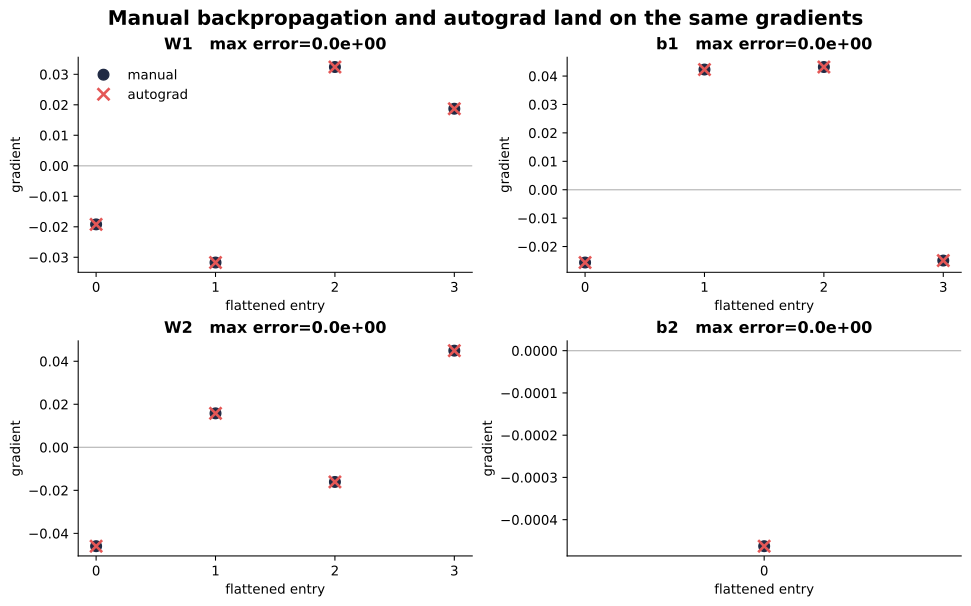
Рисунок 13 проверяет на слое поэлементное совпадение autograd с матричными правилами. Практикум содержит исполняемый цикл с неактивными ReLU и дополнительными проверками. Глава объясняет контракт: backward() вычисляет и накапливает чувствительности, отдельный оптимизатор использует их позже.
От градиентов к процессу обучения
Одно обновление за семь шагов
Корректный градиент описывает локальную чувствительность текущих параметров. Для обучения его применяют многократно в таком порядке:
- выбрать мини-батч входов и целей;
- очистить старые градиенты параметров;
- выполнить forward;
- свести потери примеров к скаляру;
- выполнить backprop;
- обновить параметры;
- записать диагностику и по расписанию оценить валидацию.
Вычислительное ядро компактно:
optimizer.zero_grad()
prediction = model(X)
loss = criterion(prediction, y)
loss.backward()
optimizer.step()
У каждой строки своя роль. zero_grad() очищает накопленные чувствительности параметров. model(X) вычисляет функцию с текущими параметрами. criterion(...) превращает её предсказания и целевые значения в скалярную цель данного батча. backward() вычисляет и сохраняет градиенты параметров. Только step() изменяет параметры по правилу обновления и с учётом текущего состояния оптимизатора.
Часто явно пишут optimizer.zero_grad(set_to_none=True): отсутствующие градиенты остаются None до backward вместо заполнения буферов нулями. Это сокращает операции памяти, а оптимизатор может различать отсутствие и нулевой градиент. Главное прежнее: старые вклады не должны незаметно входить в новое обновление без намеренного накопления.
Диагностику обучения записывают после появления соответствующих величин. Потерю батча можно записать после прямого прохода; диагностика градиентов требует обратного прохода; параметры можно записывать до или после step(), явно указывая выбранный момент. Валидацию обычно выполняют реже, чем каждое обновление, и она не должна обновлять параметры.
Мини-батчи оценивают полное направление
Пусть \(\mathcal B_t\) — индексы примеров шага \(t\). При усреднении скалярная потеря:
\[ L_{\mathcal B_t} = \frac{1}{|\mathcal B_t|} \sum_{i\in\mathcal B_t}\ell_i. \]
Обновление можно записать:
\[ \theta_{t+1} = \theta_t - \eta\, \widehat{\nabla_\theta L}_{\mathcal B_t}. \]
Шляпка отмечает оценку полного градиента. Это не неверный градиент: он точен для выбранной мини-батчевой цели и служит вычислительно доступным случайным направлением полной цели.
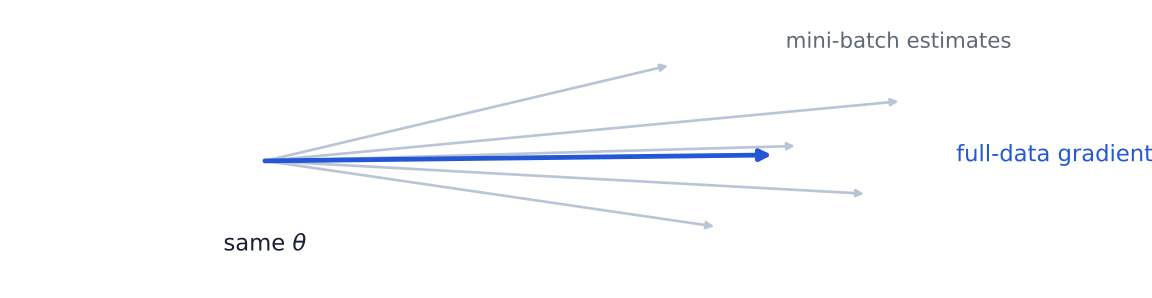
На Рисунок 14 разные примеры дают разные направления. Большие батчи обычно уменьшают вариацию выборки, требуя больше памяти и вычислений на шаг; малые дают более частые и шумные обновления. Универсально лучшего размера нет.
Шаг (update step) потребляет батч и обновляет параметры. Эпоха (epoch) — проход всех обучающих примеров, обычно много шагов. Перемешивание между эпохами мешает фиксированному порядку постоянно создавать структурированные батчи, но не превращает валидацию/тест в обучение.
Способ редукции потери определяет масштаб градиентов. Замена среднего выше на сумму для тех же примеров умножает градиент батча на \(|\mathcal B_t|\). Это меняет эффективный масштаб обновления, если скорость обучения или другая часть процедуры не компенсирует изменение. Как установлено в разделе о матричном обратном распространении, правила обратного прохода не добавляют скрытого множителя: они дифференцируют переданную им скалярную потерю.
Скорость и состояние оптимизатора
Скорость \(\eta\) задаёт силу реакции на предложенное оптимизатором направление. При слишком малой даже надёжный градиент движется медленно; при большой можно перескакивать полезную область, колебаться или получить нечисленные потери.
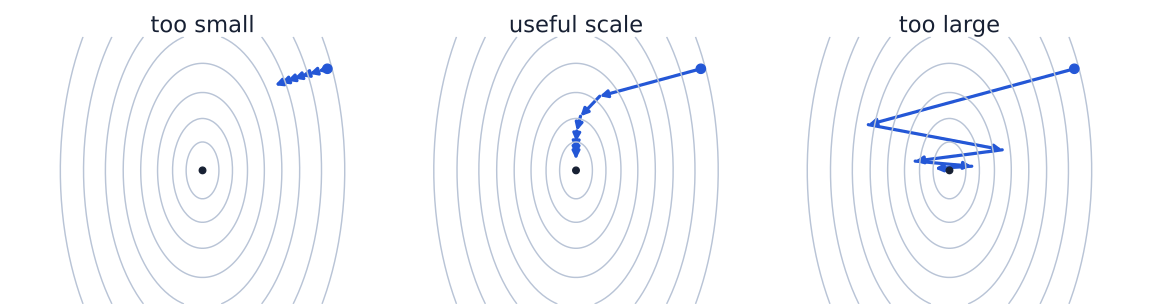
Рисунок 15 схематичен: единого численного порога режимов нет. Масштаб зависит от цели, параметризации, батча, градиентов, оптимизатора и стадии.
Градиент и состояние оптимизатора — разные объекты. Обычный стохастический градиентный спуск без инерции может непосредственно использовать текущий градиент. Метод инерции (momentum) хранит текущую комбинацию настоящих и прошлых градиентов. Адаптивные оптимизаторы, например Adam, дополнительно ведут статистики для изменения масштаба отдельных координат. Эти величины сохраняются между обновлениями, а не создаются заново текущим обратным проходом. Adam по-прежнему требует выбора скорости обучения и не гарантирует ни успешной оптимизации, ни обобщения (PyTorch contributors, б. д.-i).
AdamW добавляет отдельное уменьшение параметров. Отделённое затухание весов (decoupled weight decay) алгоритмически не равно L2-члену потерь с последующим преобразованием его градиента адаптивным Adam (Loshchilov и Hutter 2019 г.). Оба сдерживают большие веса, но в разных местах процесса.
Инициализация задаёт масштаб сигнала
До первого обновления инициализация определяет значения прямого прохода сети и локальные производные, доступные обратному проходу. Одинаковые входные веса и смещения всех скрытых нейронов создают симметрию: нейроны выдают одинаковые активации и получают одинаковые градиенты, поэтому обычные градиентные обновления не заставят их изучать разные признаки. Случайная инициализация нарушает эту симметрию.
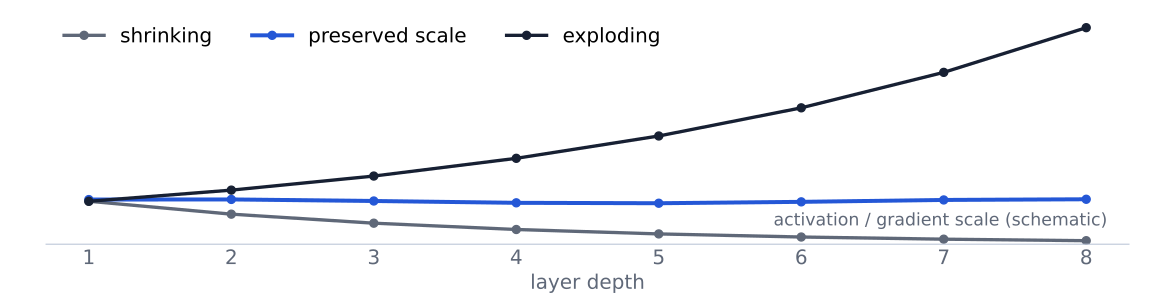
Одной случайности недостаточно. Если начальный масштаб весов слишком мал, активации и градиенты могут уменьшаться при прохождении многих слоёв. Если он слишком велик, они могут быстро расти либо переводить насыщающиеся активации в области со слабыми производными. Цель — сохранять полезные масштабы сигналов, не допуская их немедленного затухания или взрыва; равенство всех значений на разных глубинах не требуется.
Инициализация Xavier/Glorot учитывает входной и выходной fan; в обычной нормальной форме дисперсия примерно:
\[ \operatorname{Var}(W_{jk}) \approx \frac{2}{\operatorname{fan}_{\mathrm{in}}+\operatorname{fan}_{\mathrm{out}}}. \]
Она мотивирована сохранением дисперсии активаций и градиентов при упрощающих предположениях (Glorot и Bengio 2010 г.). He/Kaiming учитывает блокировку части симметричного сигнала ReLU; обычная нормальная fan-in форма:
\[ \operatorname{Var}(W_{jk}) \approx \frac{2}{\operatorname{fan}_{\mathrm{in}}}. \]
Поэтому это распространённый выбор для ReLU-сетей (He и др. 2015 г.). PyTorch предоставляет варианты Xavier и Kaiming с явными соглашениями о gain, mode, nonlinearity и fan (PyTorch contributors, б. д.-h). Формулы являются эвристиками, выведенными при приближениях относительно распределений и независимости. Они не гарантируют стабильного обучения; их предпосылки становятся менее точными при изменении архитектуры, нормализации, распределения данных или поведения активаций. Поэтому Рисунок 16 следует понимать как иллюстрацию механизма, который эти методы пытаются контролировать, а не обещание для любой сети.
Оптимизация не равна обобщению
Три роли данных — три вопроса
Аппроксимация кривой по 241 точке в сопутствующем практикуме показывает, что нелинейная сеть может снижать потери и располагать изломы ReLU около наблюдаемых обучающих точек. Это демонстрация оптимизации и выразительности модели на этих точках. Эксперимент не устанавливает качество на отдельных примерах и потому не доказывает обобщения подобранной кривой.
Нужны три роли данных:
| Выборка | Главная роль | Применение |
|---|---|---|
| Обучающая | Подбор параметров. | Мини-батчи оптимизатора. |
| Валидационная | Сравнение решений разработки. | Гиперпараметры, архитектуры, checkpoints, момент остановки. |
| Тестовая | Итоговое качество после фиксации разработки. | Финальная оценка, не обычная настройка. |
Снижение обучающей потери отвечает на узкий, но важный вопрос: выбранный оптимизатор уменьшает обучающую цель для текущей модели и данных. Это не доказывает, что модель изучила зависимость, переносимую на новые случаи. Валидация даёт предварительные основания для оценки при разработке. Тестовая выборка обеспечивает итоговую проверку на отложенных данных. Повторное обращение к качеству на тесте при изменении модели включает тест в процесс разработки и ослабляет его роль независимой итоговой оценки.
Совместное чтение обучающих и валидационных кривых
Две кривые информативнее одной. Типичные картины:
- Если обе потери снижаются, оптимизация улучшает соответствие обучающим данным, а валидационные результаты также улучшаются.
- Если обучающая потеря продолжает снижаться, а валидационная растёт, расширяющийся разрыв показывает, что последующие обновления улучшают обучающую цель без улучшения выбранного валидационного критерия.
- Если оба результата остаются плохими, возможны недообучение, неэффективная оптимизация или неподходящие данные и цель; одни кривые не позволяют определить причину.
- Если валидационная потеря шумная, выборка может быть малой или неоднородной, а метрика — иметь высокую вариативность. Не следует переоценивать единичное удачное колебание.
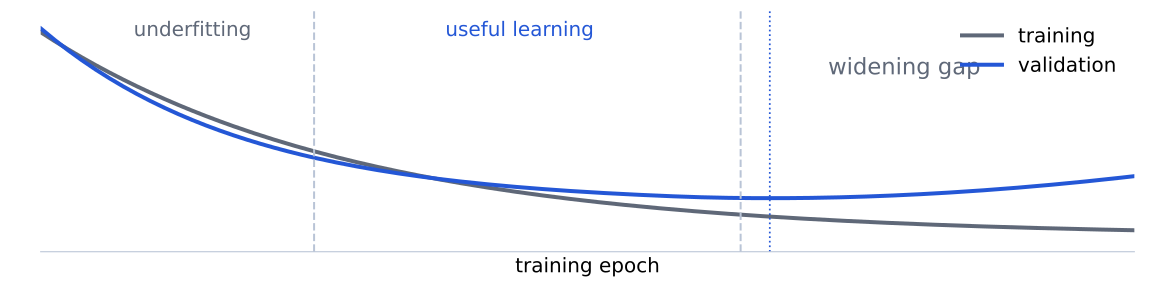
Пунктирная отметка на Рисунок 17 иллюстрирует раннюю остановку (early stopping). Валидационный критерий выбирает момент обучения или сохранённую контрольную точку (checkpoint); тестовую выборку не отслеживают для решения о моменте остановки. Поэтому ранняя остановка — процедура выбора модели по валидационным данным и одновременно практический способ ограничить дальнейшую адаптацию к обучающей выборке.
Краткая карта регуляризации
Регуляризация — воздействия ради качества за пределами обучающих примеров, часто ограничивающие, возмущающие или направляющие обучение. Они входят в разные места математики:
- штрафы в целевой функции добавляют член, например L1 или L2, к скалярной обучающей цели;
- отделённое уменьшение весов (decoupled weight decay) сокращает параметры как отдельную часть обновления оптимизатора;
- ранняя остановка ограничивает длительность адаптации параметров к обучающим данным, используя валидацию для выбора контрольной точки;
- Dropout случайно маскирует выбранные активации во время обучения;
- аугментация данных создаёт обучающие примеры преобразованиями, которые должны сохранять смысл задачи;
- ограничения архитектуры или выразительности сужают семейство функций, доступное обучающемуся алгоритму.
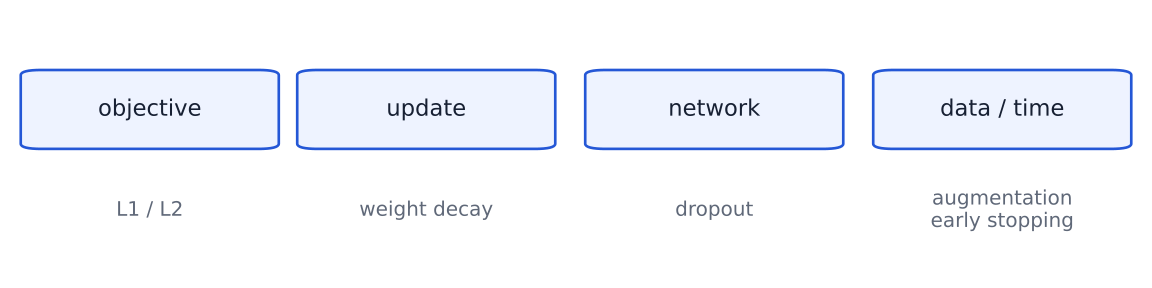
Рисунок 18 помогает избежать распространённого смешения понятий: регуляризация — не всегда дополнительный член функции потерь. Имеет значение место её применения. Явный штраф меняет градиент цели, тогда как уменьшение весов в стиле AdamW отдельно меняет обновление. Ранняя остановка меняет выбор контрольной точки. Аугментация меняет обучающие примеры, которые встречает модель.
Dropout возвращает различие средств autograd. При обучении он маскирует и масштабирует оставшиеся активации, при оценке действует детерминированно. model.eval() выбирает оценочное поведение, no-grad отдельно управляет графом. Для валидации обычно нужны оба явных решения.
Здесь ещё нет вывода L2 из гауссовского prior/MAP, подробной теории Dropout, полной схемы bias–variance и каталога настроек. Им нужны отдельное место и предпосылки. Теперь достаточно компонентов, чтобы восстановить полное рассуждение об обучении.
Итоги, упражнения и чтение
Единая система обучения
Начав с неспособной изгибаться прямой, мы пришли к обучению, проверке и оценке нелинейной модели. Основная цепочка:
\[ \begin{aligned} \text{input} &\longrightarrow \text{learned representation}\\ &\longrightarrow \text{logits or prediction}\\ &\longrightarrow \text{loss}\\ &\longrightarrow \text{sensitivities}\\ &\longrightarrow \text{parameter update}\\ &\longrightarrow \text{validation evidence}. \end{aligned} \]
Каждый переход необходим, но ни один сам не доказывает полное утверждение об обучении.
- От входа к обучаемому представлению. Аффинные преобразования объединяют доступные признаки; нелинейные активации не дают последовательности слоёв схлопнуться в одно аффинное отображение. Это расширяет семейство моделей, но большая выразительность не гарантирует нахождения полезных параметров при оптимизации.
- От представления к логитам или предсказанию. Прямое распространение вычисляет текущую композицию. Столбцовые обозначения показывают один пример, а соглашение о строках батча — выполнение тех же операций для многих примеров. Значение прямого прохода является выходом модели; оно ещё не доказывает точности или полезности этого выхода.
- От выхода к потере. Смысл задаётся задачей. Регрессионные предсказания можно непосредственно сравнивать с численными целями; бинарные и многоклассовые классификаторы выдают логиты, которые устойчиво обрабатываются соответствующими функциями потерь. Softmax выражает вектор вероятностей классов, а цель выбирает наблюдаемую компоненту. Скалярная потеря измеряет выбранное расхождение, но не объясняет, какой параметр его вызвал.
- От потери к чувствительностям. Правило цепочки задаёт локальные чувствительности каждого связанного значения. Скалярное обратное распространение перемножает производные вдоль пути и складывает вклады в местах схождения путей. Матричное обратное распространение выполняет ту же работу через VJP и тензорные операции с проверенными размерностями. Autograd записывает и выполняет локальные правила; он не выбирает модель и не обновляет параметры.
- От чувствительностей к обновлению параметров. Оптимизатор использует сохранённые градиенты параметров, скорость обучения и, возможно, состояние: инерцию или адаптивные моменты.
backward()вычисляет градиенты;step()меняет параметры. Корректное локальное обновление всё ещё может быть слишком большим, слишком малым или плохо обусловленным; успешное снижение обучающей потери само по себе ничего не говорит о новых данных. - От обновлений к валидационным результатам. Повторные обновления по мини-батчам подгоняют обучающую цель. Валидационные данные определяют выбор контрольной точки и гиперпараметров, не задавая обновлений оптимизатора. Только такое разделение позволяет отличать улучшение соответствия обучающим данным от свидетельств обобщения; зарезервированный тест используют после фиксации решений разработки.
В результате получается единая система, а не перечень терминов нейросетей. Представление определяет, что можно выразить. Прямое распространение определяет предсказания текущих параметров. Потеря задаёт оптимизируемое расхождение. Обратное распространение и autograd определяют чувствительности. Оптимизатор задаёт движение параметров. Валидация показывает, остаются ли выбранные решения перспективными за пределами обучающих батчей.
Частые смешения понятий
| Различие | Надёжная проверка |
|---|---|
| Аффинный слой и активация | nn.Linear аффинен; ReLU отдельна. |
| Логит и вероятность | Логит не ограничен; sigmoid/Softmax дают вероятности; logits-потери получают исходные логиты. |
| Градиент и обновление | Локальная чувствительность хранится после backprop; оптимизатор строит обновление. |
| Лист и промежуточный тензор | Листья — концы графа, например параметры; промежуточные — результаты записанных операций. Оба дифференцируются, но промежуточный .grad не сохраняется по умолчанию. |
detach() / no_grad() / eval() |
Первое разрывает историю одного возвращённого тензора, второе выключает запись контекста, третье меняет поведение модулей. |
| Обучающая потеря и валидация | Первая — подгоняемая цель, вторая оценивает разработку на данных без обновлений параметров. |
| L2 и decoupled weight decay | L2 входит в градиент потери, decay действует отдельно в оптимизаторе. |
При отладке точное имя объекта слева полезнее вопроса «работает ли сеть»: оно превращает общий сбой в проверку представления, forward, смысла потери, градиентов, обновлений или оценки.
Упражнения
Задачи идут от алгебры и forward к градиентам и диагностике. Если не сказано иначе, один пример — столбец, батч — строки, названия классов с единицы, индексы PyTorch с нуля.
Упражнение 1 — Три аффинных слоя сворачиваются
Пусть
\[ \mathbf h^{(1)}=\mathbf W^{(1)}\mathbf x+\mathbf b^{(1)}, \qquad \mathbf h^{(2)}=\mathbf W^{(2)}\mathbf h^{(1)}+\mathbf b^{(2)}, \]
\[ \mathbf y=\mathbf W^{(3)}\mathbf h^{(2)}+\mathbf b^{(3)}, \]
при ширинах \(d_0,d_1,d_2,d_3\). Подстановкой докажите аффинность полного отображения \(\mathbf x\in\mathbb R^{d_0}\) в \(\mathbf y\in\mathbb R^{d_3}\). Найдите эквивалентные матрицу и смещение, проверьте формы. Где именно перестанет работать довод при вставке ReLU после первого или второго слоя?
Упражнение 2 — Прямой проход и размерности
Для одного входа рассмотрим сеть \(2\to3\to1\):
\[ \mathbf x= \begin{bmatrix}1\\-2\end{bmatrix}, \quad \mathbf W^{(1)}= \begin{bmatrix} 1&0\\ -1&1\\ 0.5&-0.5 \end{bmatrix}, \quad \mathbf b^{(1)}= \begin{bmatrix}0\\1\\-0.5\end{bmatrix}. \]
В скрытом слое используется ReLU. Выходной слой — аффинный, с параметрами
\[ \mathbf W^{(2)}= \begin{bmatrix}2&-1&0.5\end{bmatrix}, \qquad b^{(2)}=-1. \]
Вычислите \(\mathbf z^{(1)}\), \(\mathbf h^{(1)}\) и \(\hat y\). Укажите размерность каждого входа, параметра и промежуточной величины. Теперь предположим, что матрица батча \(\mathbf X\) содержит четыре примера в строках. Укажите размерности \(\mathbf X\), \(\mathbf Z^{(1)}\), \(\mathbf H^{(1)}\) и итогового выхода батча; запишите уравнение первого слоя для батча с учётом ориентации весов при хранении в PyTorch.
Упражнение 3 — Уверенность и перекрёстная энтропия
В задаче с тремя классами наблюдается класс 3 при нумерации с единицы. Поэтому индекс целевого класса в PyTorch равен 2, а его one-hot-вектор — \([0,0,1]\). Сравните два вектора логитов:
\[ \mathbf z_{\mathrm{correct}}=[0,0,4], \qquad \mathbf z_{\mathrm{wrong}}=[4,0,0]. \]
Для каждого вектора вычислите вероятности Softmax как минимум до четырёх знаков после запятой, определите класс argmax и перекрёстную энтропию для наблюдаемого класса. Объясните, почему значения потерь сильно различаются, хотя оба вектора содержат одни и те же три числовых значения логитов. Укажите точно, какой целевой тензор нужно передать в F.cross_entropy для батча, содержащего только этот пример.
Упражнение 4 — Сначала предскажите знаки градиентов
Используйте
\[ z=wx+b, \qquad h=\operatorname{ReLU}(z), \qquad \hat y=ah+c, \qquad L=\frac12(\hat y-y)^2, \]
при
\[ x=2,\quad w=-1,\quad b=3,\quad a=-2,\quad c=4,\quad y=1. \]
До вычисления точных производных предскажите знаки \(\partial L/\partial a\), \(\partial L/\partial w\) и \(\partial L/\partial x\). Обоснуйте каждый знак: как небольшое положительное изменение соответствующей величины повлияет на предсказание и потери? Затем выполните полный прямой проход и вычислите градиенты по \(a,c,w,b,x\). Сопоставьте каждый точный результат с предсказанным знаком.
Упражнение 5 — От одного элемента весов к матричному произведению
Для одного слоя «аффинное преобразование плюс активация» предположим, что производная активации уже учтена и
\[ \mathbf H_{\mathrm{in}}= \begin{bmatrix} 1&2\\ -1&3 \end{bmatrix}, \qquad \mathbf G_Z= \begin{bmatrix} 2&-1\\ 4&0.5 \end{bmatrix}. \]
Здесь \(B=2\), \(d_{\mathrm{in}}=2\) и \(d_{\mathrm{out}}=2\). Используя математические индексы с единицы, выведите \(\partial L/\partial W_{12}\) непосредственно как сумму по двум строкам батча. Затем вычислите всю матрицу \(\partial L/\partial\mathbf W=\mathbf G_Z^\top\mathbf H_{\mathrm{in}}\) и градиент смещения. Проверьте все размерности и объясните, почему перестановка множителей в матричном произведении неверна.
Упражнение 6 — Два смысла слова «накопление»
Пусть начальное значение скалярного параметра равно \(p=0\), скорость обучения равна \(\eta=0.1\), а две функции потерь определены как
\[ L_1(p)=\frac12(p-1)^2, \qquad L_2(p)=\frac12(p-3)^2. \]
Разберите два разных сценария.
- Два вызова backward, одно обновление: вычислите обе функции потерь при \(p=0\), вызовите
backward()для каждой, не очищая.grad, и вызовитеstep()только после обоих обратных проходов. Какой градиент сохранится и какое значение \(p\) получится? Это градиент суммы или среднего? - Два обновления, неочищенный градиент: вычислите \(L_1\), вызовите
backward()иstep(), затем вычислите \(L_2\) при новом значении параметра, но пропуститеzero_grad()перед вторыми вызовамиbackward()иstep(). Вычислите полученное \(p\). Сравните его с результатом при корректной очистке градиента перед вторым обратным проходом.
Для каждого сценария укажите, является ли накопление градиентов намеренным или случайным. Отличайте сложение между вызовами backward от сложения вкладов нескольких путей внутри одного графа по правилу цепочки.
Упражнение 7 — Сначала диагностика кривых, затем выбор меры
Для каждого качественного поведения кривых ниже предложите (i) как минимум две правдоподобные интерпретации и (ii) одну следующую диагностическую проверку, которая поможет их различить. Не назначайте единственное автоматическое решение только по виду кривых.
- Потери на обучении и валидации устойчиво снижаются.
- Потери на обучении снижаются, а на валидации достигают минимума и затем растут.
- Потери на обучении и валидации остаются высокими и почти не меняются.
- Кривая потерь на обучении гладкая, а потери на валидации резко меняются от одной оценки к следующей.
Для случая 2 объясните, как ранняя остановка должна выбирать контрольную точку и почему тестовая выборка не должна определять момент остановки. Для случая 4 учтите возможную роль размера или неоднородности валидационной выборки.
Упражнение 8 — Проверка центральной конечной разностью
Используйте скалярную сеть и числовые значения из упражнения 4. Зафиксируйте все величины, кроме \(w\), и определите \(L(w)\) через полный прямой проход. При \(\varepsilon=10^{-5}\) оцените
\[ \frac{\partial L}{\partial w} \approx \frac{L(w+\varepsilon)-L(w-\varepsilon)}{2\varepsilon}. \]
Сравните оценку с аналитическим градиентом из упражнения 4. Опишите разумный абсолютный или относительный допуск для проверки в float64 и объясните, почему слишком малое \(\varepsilon\), слишком большое \(\varepsilon\) или возмущение, пересекающее точку излома ReLU, могут сделать сравнение обманчивым.
Дополнительное чтение
Следующие источники углубляют отдельные темы главы; для её изучения предварительно читать их не требуется:
- Глава 6 книги Deep Learning подробнее рассматривает сети прямого распространения, выходные и скрытые элементы, а также обратное распространение (Goodfellow и др. 2016 г.).
- Baydin и соавторы помещают дифференцирование обратного режима в общий контекст автоматического дифференцирования и отличают его от символьного и численного дифференцирования (Baydin и др. 2018 г.).
- Rumelhart, Hinton и Williams дают исторически влиятельное первичное изложение обучения внутренним представлениям с помощью обратного распространения (Rumelhart и др. 1986 г.).
- Документация PyTorch об устройстве autograd описывает граф, режимы вычисления градиентов и отличия режима оценки, используемые в этой главе (PyTorch contributors, б. д.-a).
- Статьи Glorot и He развивают обоснования инициализации, кратко изложенные в разделе о процессе обучения (Glorot и Bengio 2010 г.; He и др. 2015 г.).
Далее: свёрточные нейронные сети
Следующая глава курса посвящена свёрточным нейронным сетям. CNN сохраняют все механизмы, разработанные здесь: прямой проход вычисляет логиты или предсказания, функция потерь оценивает их, дифференцирование обратного режима вычисляет чувствительности, оптимизатор обновляет параметры, а валидация даёт основания для выбора решений при разработке. Меняется структура обучаемого аффинного преобразования. Локальные связи, общие параметры и пространственная организация выражают предположения, подходящие для данных на регулярной сетке. Эти идеи заслуживают отдельного вывода; данная глава даёт процесс обучения, на котором они основаны.